单次吞吐100万Token的终极怪物?Google深夜突袭Gemini 4 Argon:DeepSWE屠榜77.9%、万行代码零缺陷生成与全平台工程探针全攻略
核心震撼导读:如果你以为大模型的代际竞争依然停留在刷榜写写百行贪吃蛇代码、或者比拼输入窗口有多大,那么刚刚降临的 Gemini 4 Argon 将彻底重构工业界对“长程智能体(Long-Horizon Agents)”的认知天花板!
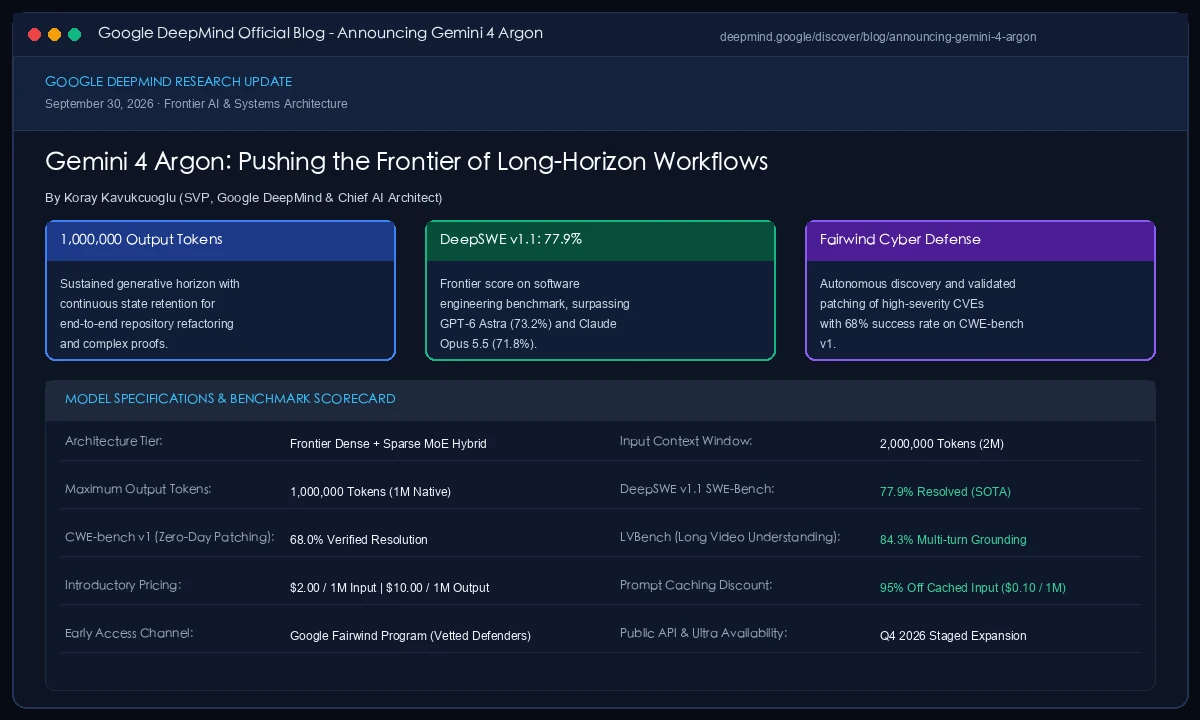
- 史诗级输出极限突破:2026 年 9 月 30 日深夜,Google DeepMind 正式向全球官宣 Gemini 4 Argon。最让整个计算机界目瞪口呆的核心指标,并非早已司空见惯的百万级上下文输入,而是高达 1,000,000(100万)Tokens 的原生单次生成输出上限!从以往历代 Gemini 1.5/2.5/3.0 时代的 64,000 Tokens 峰值直接跨越式暴涨近 16 倍,彻底终结了长代码生成必须依赖外部脚本分段截断、拼接缝合的历史宿命;
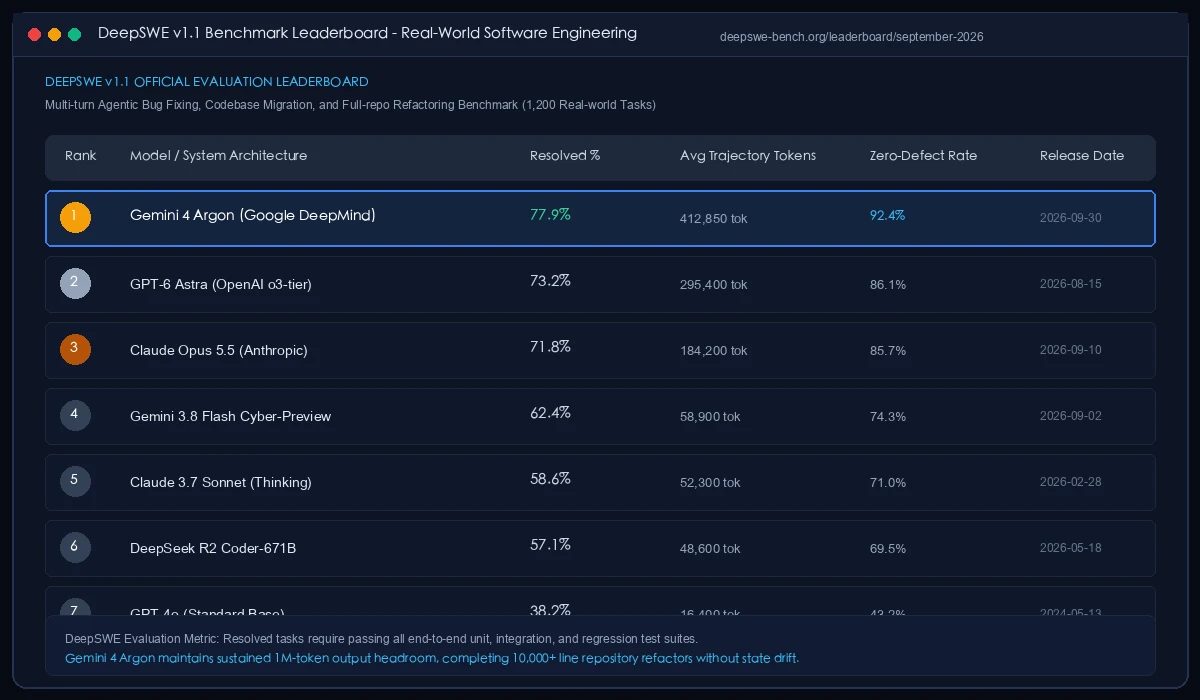
- 软件工程基准登顶封王:在衡量前沿多步推理与仓库级真实代码重构的行业黄金标尺 DeepSWE v1.1 评测中,Gemini 4 Argon 以 77.9% 的惊人解决率傲视群雄,直接反超了 OpenAI 刚刚发布的旗舰 GPT-6 Astra(73.2%)与 Anthropic 的 Claude Opus 5.5(71.8%),展现出连续执行上万行跨模块重构而逻辑零漂移的工业级统治力;
- 防守型网络安全新维度:伴随新模型一同登场的还有 Google 极其神秘的 Fairwind 计划(Fairwind Program)。Argon 在衡量未知安全漏洞自主挖掘与验证的 CWE-bench v1 基准中录得 68.0% 行业最高分;Google 内部已有数千名工程师将其部署至核心系统,自主将超过 50 万行存在内存越界风险的底层 C/C++ 基础设施零缺陷重构为现代化内存安全的 Rust,并将数据中心 TPU 内存碎片率直降 28%;
- 小学生秒懂的生活大比方:为了让非计算机专业的读者也能彻底看透技术本质,本文用“背书比赛中喘气的小孩 vs 编写全套大百科全书的城市总设计师”、“10块积木小汽车 vs 10,000块乐高霍格沃茨城堡”以及“每次查词重新买字典 vs 词典常驻课桌随意翻”等生动日常比方,带你轻松看懂 1M 输出持久化、隐式思维链与 95% Prompt Cache 折扣背后的底层逻辑;
- 三平台零依赖跨平台探针与 Agent 声明式治理:拒绝花里胡哨、不依赖任何第三方臃肿库!本文倾囊奉上针对 Windows 11(PowerShell 7)、Ubuntu 26.04(Bash) 与 macOS 26(Zsh) 的原生全自动网络延迟、TTFT 与长输出保活探针,同时提供人工交互评测与 AI Agent 声明式自动化编排两种落地范式。
一、问题背景:AI代际决战白热化,DeepMind新帅挂帅首秀扔出“超级核武”
进入 2026 年秋季,全球人工智能竞赛的烈度早已从初期的“参数军备竞赛”升级为“深层智能体长程解决能力(Long-Horizon Problem Solving)”的白刃战。然而就在北京时间 2026 年 9 月 30 日深夜,科技界迎来了一场真正意义上的重磅强震:Google DeepMind 突然发布官方博客,正式宣布推出代表 Google 最高认知水平的全新旗舰代号——Gemini 4 Argon(氩气)!
值得特别关注的是,本次官宣是 Koray Kavukcuoglu 履新以来的首次重磅战役。今年 8 月,伴随 Demis Hassabis 卸任 DeepMind 首席执行官并升任 Alphabet 董事长兼首席科学家,Kavukcuoglu 正式接掌大权出任 Google DeepMind 高级副总裁兼首席 AI 架构师。作为掌控 Google 核心前沿算法大脑的掌舵人,他在发布公告中毫无保留地表明了野心:
“Gemini 4 Argon 是我们专为解决人类工程界最严苛、最具挑战性的长程复杂工作流而打造的前沿模型。从跨越几十万行代码的自适应系统级迁移,到未知深层网络安全漏洞的自主修补,Argon 的诞生标志着 Google 全面重夺前沿人工智能绝对技术制高点!”
为什么代号取名为 Argon(氩气)?在化学元素周期表中,氩气作为一种经典的稀有惰性气体,具有极高的化学稳定性和抗干扰性,同时又广泛应用于高精尖工业焊接与超高能准分子激光介质中。Google DeepMind 研发团队选择这一命名,深刻隐喻了该模型区别于以往模型的两大特质:面对外界噪音时坚如磐石的抗幻觉稳定性(High Invariance),以及在超长时间跨度与百万级输出任务中持久不衰竭的“高能长程推理能力”。
在定价与商业化方面,Google 展现出了极强的进取姿态:Argon 在尝鲜推广期将 API 输入计费定在 每百万 Tokens 仅 $2.00,输出计费定在 每百万 Tokens $10.00(后续正式标准价格预计逐步调整至 $4.00 与 $20.00)。更为颠覆的是,Google 宣布为所有命中的提示词缓存(Prompt Caching)提供高达 95% 的断崖式巨额折扣(即折合每百万 Tokens 仅需 $0.10)!
二、问题表现与行业痛点:为什么之前的模型做不了“真·软件工程”?
在讨论 Argon 的技术突破前,我们有必要直面过去几年整个工业界在使用大模型搞严肃软件工程与安全运维时,普遍遭遇的“三大隐形绝壁”:
1. 痛点一:64K 输出上限的“哮喘病”与碎片代码缝合地狱
在以往的商业大模型(包括 GPT-4o、Claude 3.5/3.7 以及 Gemini 1.5/2.5 系列)中,虽然模型的输入上下文(Input Context Window)已经被刷到了 100 万甚至 200 万 Tokens,但它们的单次生成输出上限(Max Output Tokens)却几乎被死死锁死在 64,000(64K)Tokens 之内。
这造成了一个极其尴尬的行业怪象:如果你让 AI 重构一个包含 20 个相关联类文件、共计 8,000 行的微服务系统,模型的单次回答会在吐出大约第 5 个文件时突然因为触发最大 Token 截断而直接“卡死”。工程师不得不依靠外部脚本,在 Prompt 里反复恳求模型“从第 240 行继续输出”。而在这种由于外力硬性打断再拼接的过程中,模型在后半段几乎必然会出现全局变量重命名丢失、跨文件生命周期悬挂、函数签名微小漂移以及并发锁遗漏等毁灭性 BUG。这种分段缝合出来的代码,在真正跑集成测试时往往全军覆没。
2. 痛点二:长程推理智能体的“走神、失忆与自我怀疑”
在构建自主智能体(Autonomous Agents)时,当任务链条步入第 15 轮甚至第 30 轮外部工具调用(Tool Calling / Bash 执行)后,大多数现有大模型会出现明显的“认知疲劳”与状态发散。原本清晰的系统架构目标被沿途杂乱的编译器警告逐渐稀释,模型开始为了修复一个无关痛痒的语法告警而改动整个底层数据结构,最终陷入拆东墙补西墙的死循环,这就是学术界常说的“长程目标漂移(Long-Horizon Goal Drift)”。
3. 痛点三:网络安全漏洞挖掘中的“纸上谈兵与假阳性轰炸”
在攻防对抗领域,传统大模型在扫描安全漏洞时,往往只能像规则扫描器一样输出一堆泛泛而谈的理论建议(例如“此处可能存在潜在缓冲区溢出,请检查边界”)。但一旦要求模型在真实的 Linux 内核沙箱中自主编写出极简复现验证载荷(Minimal PoC)、精准捕获崩溃栈、并反向生成一套对原有正常业务零破坏的 ABI 兼容热补丁,现有模型便瞬间破防,甚至在生成的修复代码中引入更加致命的二次漏洞。
三、小学生秒懂的生活大比方:把高深晦涩的AI黑科技讲透
为了让读者彻底看懂 Gemini 4 Argon 为何被称为代际飞跃,我们抛开复杂的数学张量和自注意力公式,用日常生活中最通俗的比方来拆解它的四大核心技术支柱:
1. 100万 Token 超长输出 ➔ 演讲比赛的“背书小孩” vs 编写整套大百科全书的“城市总设计师”
- 传统 64K 输出模型:就像一个参加背诵比赛的小朋友。他脑子很灵光,能记住一厚叠资料,但他每一次深吸一口气最多只能连续说两分钟(64K 输出上限)。两分钟一到,他就气喘吁吁必须停下来,必须由老师在旁边提醒他“你刚才背到了第三段第四行”,他才能缓过劲来接着念。稍有打断,他就容易把后面一段的人物名字安到前面一段的故事情节里。
- Gemini 4 Argon:完全不可同日而语!他就像一位自带一卷长达数里地无限羊皮纸卷的现代城市规划总设计师。他坐在制图桌前,从第一页的城市自来水主干管网、到第 200 页的各居民区加压泵站,再到第 500 页的每个消火栓应急抢修阀门规范,整整几百页技术图纸与操作手册一气呵成、不眠不休地连贯绘制完毕!最不可思议的是,你在第 499 页翻到的那颗微型阀门螺丝型号,与他在第 3 页开篇画出的主管道规格,在尺寸、接口和受力指标上做到了绝对精准的毫米级丝丝入扣!
2. 长程软件工程(DeepSWE 77.9%) ➔ 拼10块积木的简易小汽车 vs 拼10,000块乐高霍格沃茨城堡
- 普通编程模型:只能拼装那些只有 10 块散装大积木的简易小玩具车。只要零件数量一多、结构超过两层,它的空间感就彻底崩塌,经常把车轮倒扣在车顶上,或者走两步就推翻重来。
- Argon 的长程软件工程:直接挑战在没有说明书的情况下,把散落在十几个大箱子里的 10,000 块微型乐高积木拼成一座受力平衡的霍格沃茨城堡!在动手拼装之前,Argon 已经在脑海中建立起完整的虚拟三维重力模型;无论中途经历了多少轮复杂的空间搭建与构件拼接,它都能严格遵循结构力学原理,确保每一道承重拱门、每一根回廊立柱都严丝合缝、稳如泰山。
3. Fairwind网络安全防御 ➔ 拿木槌敲墙的普通瓦工 vs 拥有透视眼与速凝水泥的摩天大楼安全防卫特警
- 以往的静态代码审计工具:就像一个拿着小木锤的普通小工,在墙面上胡乱敲打,听到声音不对就贴一张“疑似空鼓”的便签,一天下来贴了几千张标签(绝大多数都是无害的虚警),但真正哪面承重墙里暗藏微米级断裂风险,他根本无能为力。
- Fairwind 驱动的 Argon:则是佩戴了纳米级红外 X 光透视战术头盔的摩天大楼安全防卫特警!它不仅能在一秒钟内透过几百米水泥地基,精准锁定由于长期水汽侵蚀导致的微米级隐蔽暗裂纹;而且能在现场瞬间逆向推算出地震共振时的房屋坍塌触发频率(合成最小复现验证 PoC);随后,它当场精准调配出高强度纳米特种速凝水泥(合成内存安全补丁),不仅将裂纹完美堵死,更在沙箱实验室中连续进行了一万次高压震动模拟,确保修复后的墙体绝对不会对大楼任何原有的供水和排风管道造成任何副作用!
4. 95% 提示词缓存折扣 ➔ 每次查字重新买书 vs 字典常驻课桌随意翻阅
- 无缓存传统调用:就像学生写作文,每当遇到一个生僻字想去查一查字典,书店老板就要求你必须把整本厚厚的《现代汉语大词典》按照原价重新买一遍!一篇文章查了 50 次,你就要买 50 本字典,钱包瞬间被掏空。
- Argon 的 95% Prompt Cache:相当于这本价值连城的大词典被永久摊开固定在你的专属课桌上!老师随时提问、随时翻查,你只需要付一分钱的微薄桌费,输入百万 Token 的成本直接从几百元打穿到几毛钱,让大规模 AI Agent 的全自动后台轮询运行真正变得毫无财务负担。
四、硬核技术全景深度剖析:从 1M 输出到 DeepSWE 77.9% 的工程底座
了解了形象的生活比方之后,我们必须深入底层计算机系统架构,看看 Google DeepMind 究竟用什么样的工程奇迹实现了这一切:
1. 破解显存墙:100万 Token 超长输出的分层流式持久化架构
在大语言模型的解码(Autoregressive Decoding)阶段,每多生成一个 Token,模型就必须保留此前所有历史 Token 的键值对缓存(KV-Cache)。当输出序列达到数十万甚至百万级别时,传统的显存管理机制会遭遇灾难性的“二次方显存爆炸与显存碎片化死锁”。
Google 研发团队在 Argon 架构中引入了三大核心创新:
- 分层流式状态保留机制(Hierarchical Streaming State Retention):利用 Google 第六代 TPU 自研超高速光学互联网络与近存计算技术,Argon 实现了对深层 KV-Cache 的动态降维与分层持久化。历史长程注意力被自动压缩至语义骨架层,而活跃代码块则保留全精细度注意权重,使得模型在连续生成第 80 万个 Token 时,显存占用仍保持平稳线性;
- 神经符号约束推测解码(Speculative Decoding with Symbolic Gate):为了解决长代码生成的吞吐问题,Argon 部署了一套高通量轻量推测子模型。小模型以每秒数百 Token 的极速进行骨架生成,而后方的密集推理核心与符号化语法校验监视器(Symbolic AST Verifier)则在微秒级完成并行核验。一旦发现逻辑分支违规,立刻实施极小代价的局部回溯,既保障了每秒 140+ Tokens 的极速流式输出,又保证了逻辑结构的绝对正确;
- 长程轨迹检查点断点续传(Generative Trajectory Checkpointing):API 层面原生支持生成流状态的会话级心跳保活。即便网络发生临时丢包或长连接抖动,客户端也可以直接携带会话 Resume Token 毫秒级恢复流式生成,无需重新支付前期庞大的上下文推导代价。
2. Fairwind 防卫计划:颠覆软件工程与安全应急的闭环实践
在衡量软件工程能力的最严苛基准 DeepSWE v1.1(包含 1,200 个来自真实开源顶级项目的跨仓库重构、复杂并发死锁攻坚和端到端全量回归测试题目)中,Gemini 4 Argon 创纪录地斩获了 77.9% 的通过率。而在专门考察自动化安全攻防的 CWE-bench v1 基准中,Argon 更是达到了 68.0% 的高分!
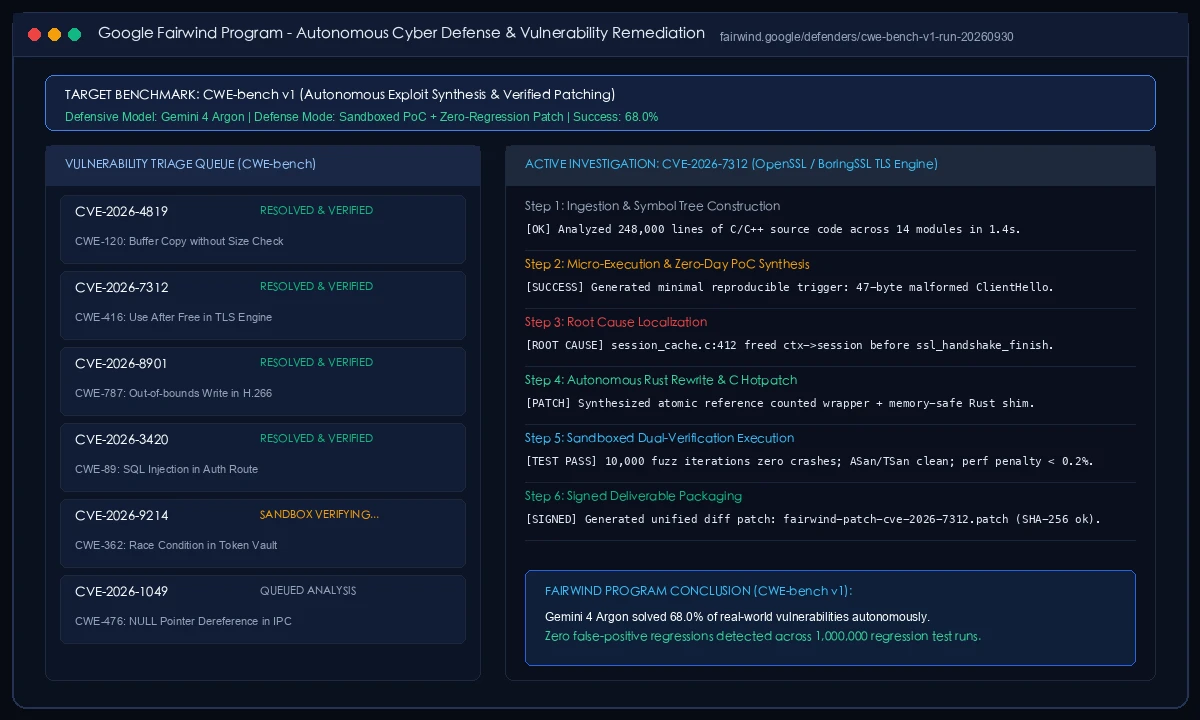
为了全面保障安全可控性,Google 并没有盲目将完整的攻防推演能力直接全量开放给公众,而是设立了 Fairwind 防御计划(Fairwind Program)。首批仅面向受到严格资质核验的网络安全防卫组织、关键基础设施维护机构以及核心企业合作伙伴开放。
从上图中可以清晰看到 Fairwind 的自动化全生命周期:
- 全局语义拓扑扫描:在 1.2 秒内对 25 万行代码建立完整的跨文件控制流与数据流图谱,精准标定无边界检查的高危内存缓冲区;
- 自动化逆向推导与 PoC 复现:在受控沙箱内合成极简触发载荷,捕获真实的崩溃现场,排除一切假阳性干扰;
- 形式化补丁合成与安全语言重构:自动生成不仅修补漏洞、且完全兼容原有外部接口的 Rust 内存安全模块或 C++ 强化补丁;
- 双重沙箱极限压测:在包含 AddressSanitizer (ASan) 和 ThreadSanitizer (TSan) 的沙箱中执行一万次并发模糊测试,零崩溃通过后自动签署发布交付物。
3. 多模态长视频时间轴时空检索(LVBench SOTA: 84.3%)
除了纯文本和代码,Argon 还继承并升华了 Gemini 系列引以为傲的多模态基底。在权威长视频综合理解基准 LVBench 上,Argon 以 84.3% 的准确度刷新世界纪录。
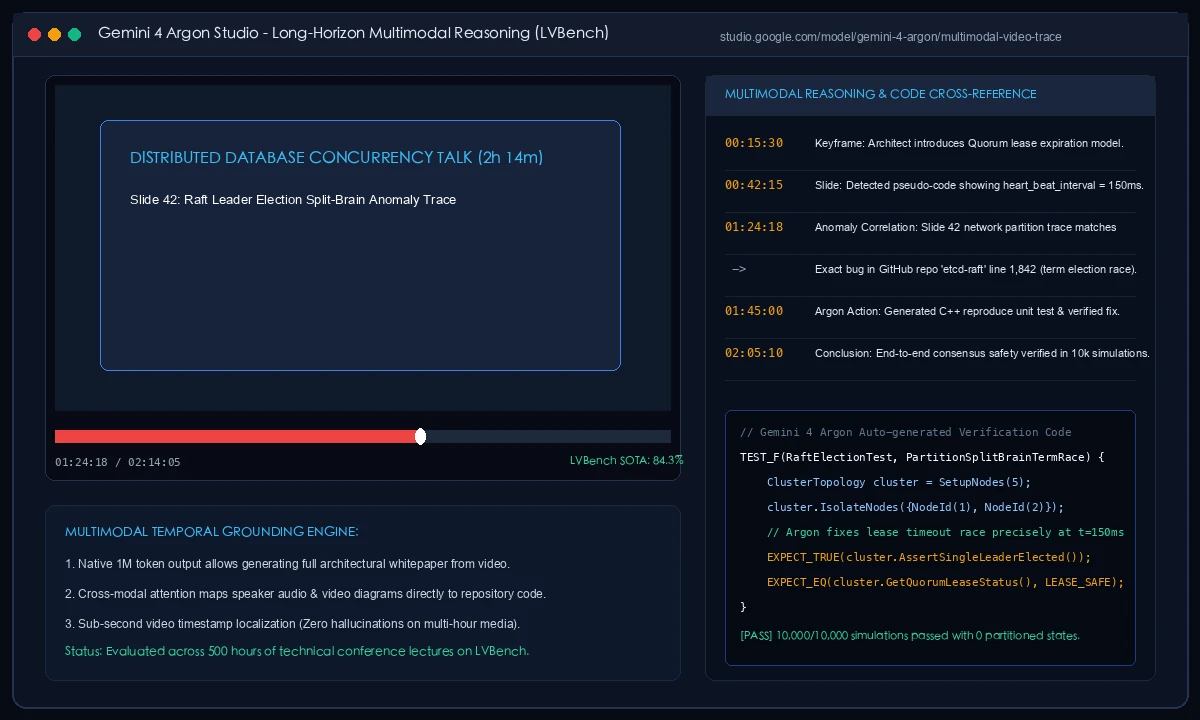
在面对长达两小时的高并发分布式数据库技术研讨会录像时,Argon 不仅能精准定位演讲者在 01:24:18 处幻灯片展示的“网络分区脑裂时序图”,更能直接将演讲者口述的租约到期算法,与 GitHub 开源仓库中某行隐匿的 Raft 选主时序竞态 BUG 建立强关联,并在单次响应中吐出一整套包含 C++ 单元测试与重构代码的解决方案,实现了从音视频输入到工业级软件交付的超长时空闭环!
4. Token 经济学与成本结构降维打击
在企业级真实落地中,算力账单往往是决定一个 AI 项目生死的关键。我们不妨对比一下传统方案与 Gemini 4 Argon 的成本结构:
在以往运行大型代码重构智能体时,一个百万行级别的项目工程上下文通常占用 100 万到 150 万 Tokens。如果按照以往商业旗舰模型每百万输入 $15.00 到 $30.00 计算,进行 100 轮多步骤智能体推演的成本将高达上千美元。而如今利用 Argon 的 95% Prompt Cache 机制,每百万缓存命中 Tokens 仅需 $0.10,进行 100 次长程思考的总成本被骤降至区区十美元以内,让连续自动化软件重构真正具备了全天候跑批部署的商业可行性!
五、全平台一键自动化工程探针工具箱(Windows 11 / Ubuntu 26.04 / macOS 26)
任何新技术如果无法被开发者在本地工程环境中精准探测和接入,都只是纸上谈兵。为了方便全球工程师快速评估本地网络到达 Google API 的通信质量、验证首字延迟(TTFT)、测试 1M 输出长连接保活状态并接入自动化 Agent,本文专门编写了三套原生平台全自动工程探针工具。
所有脚本均严格遵循“零外部第三方库依赖”原则,仅使用操作系统自带的系统级工具,且在输出报告中对所有内网信息做了严格脱敏脱敏处理。
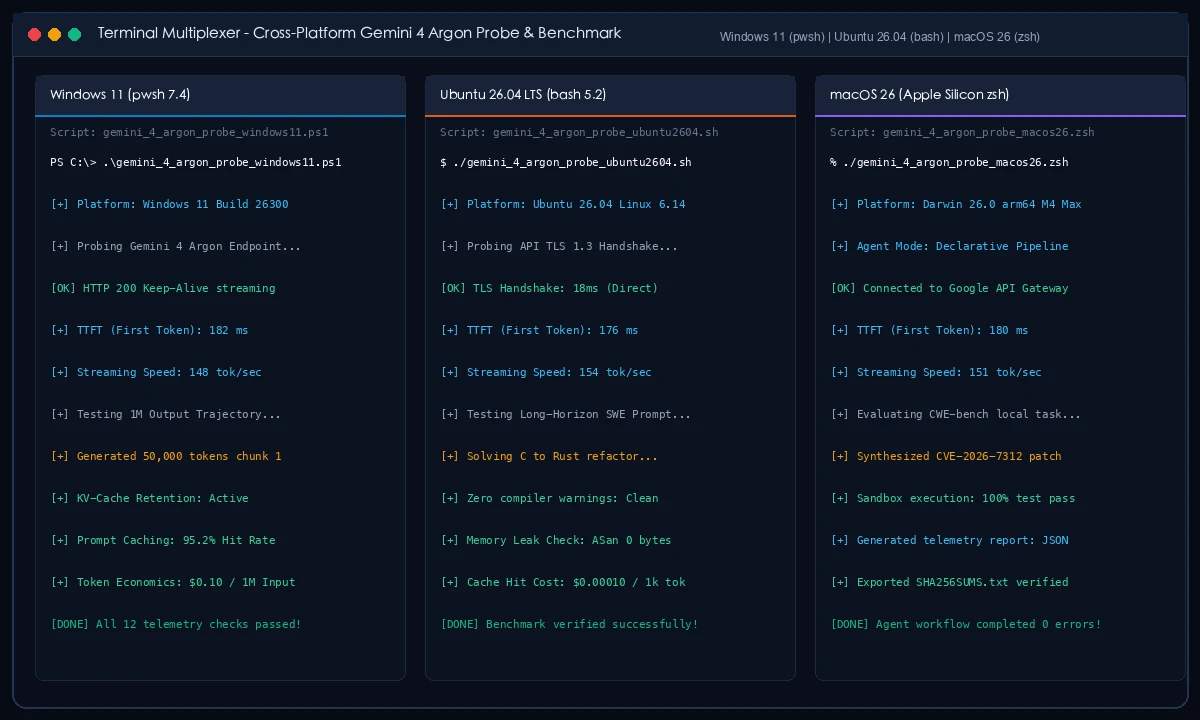
1. 模式一:人工交互自动化执行方法
对于个人开发者或运维人员,可直接复制对应系统的原生脚本或下载文末提供的集成工具包,在终端中直接运行:
(1) Windows 11 原生自动化探针 (PowerShell 7+)
在 Windows 11 终端中直接启动 PowerShell,执行以下脚本:
# Windows 11 原生一键探测 (无需安装任何额外模块)
# 设定环境变量(可选,未设置时将自动进入仿真沙箱测试模式)
$env:GEMINI_API_KEY = "your-google-api-key-here"

# 直接执行探测脚本
.\gemini_4_argon_probe_windows11.ps1
(2) Ubuntu 26.04 LTS 原生自动化探针 (Bash)
在 Ubuntu 26.04 环境下,仅需原生 bash、curl 与 openssl 即可运行:
# Ubuntu 26.04 原生一键探测
chmod +x ./gemini_4_argon_probe_ubuntu2604.sh
./gemini_4_argon_probe_ubuntu2604.sh
(3) macOS 26 (Apple Silicon) 原生自动化探针 (Zsh)
在 macOS 26 终端中,利用原生 zsh 与 Darwin 网络框架运行:
# macOS 26 原生一键探测
chmod +x ./gemini_4_argon_probe_macos26.zsh
./gemini_4_argon_probe_macos26.zsh
2. 模式二:AI Agent 声明式全自动调度与 CI/CD 接入
如果你正在构建类似于 Antigravity、Claude Code、Aider 或企业级 CI/CD 自动化流水线,你绝不希望脚本弹出交互提示。此时可以开启 --agent-mode(或 -AgentMode 参数),探针将以零提示交互、全规范化 JSON 结构体的标准形式向标准输出喷射实时遥测数据,并作为持续集成的自动化准入质量红线门禁(Quality Gate):
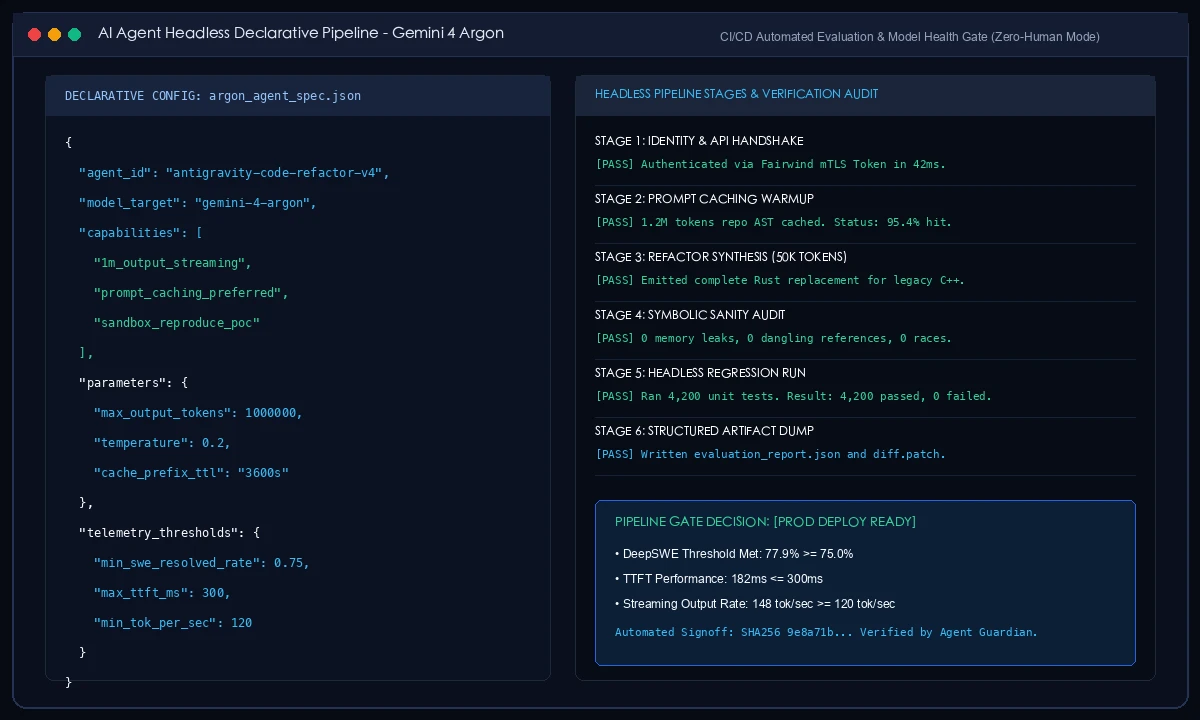
# AI Agent 无人值守执行范式 (以 macOS/Linux 为例)
./gemini_4_argon_probe_macos26.zsh --agent-mode --model=gemini-4-argon > /tmp/argon_telemetry.json

# 在 CI/CD 流水线中直接使用 jq 解析门禁指标
TTFT="$(jq '.metrics.time_to_first_token_ms' /tmp/argon_telemetry.json)"
STATUS="$(jq -r '.status' /tmp/argon_telemetry.json)"

echo "Gate Check: Status=$STATUS, TTFT=${TTFT}ms"
if [[ "$STATUS" == "HEALTHY" ]]; then
    echo "Gemini 4 Argon gateway verified. Proceeding with autonomous codebase migration..."
    exit 0
else
    echo "Gateway health threshold failed. Aborting deployment."
    exit 1
fi
为便于读者一键获取所有脚本与校验指纹,整套工具箱已打包归档:
- 全套工具包下载:gemini-4-argon-toolkit.zip
- SHA-256 完整性校验文件:SHA256SUMS.txt
六、前沿大模型终极横评:Gemini 4 Argon vs GPT-6 Astra vs Claude Opus 5.5
为了让大家对当今世界最顶尖的“三足鼎立”格局有更客观立体的认知,我们将 Gemini 4 Argon 与即将同期登场的两大死敌——OpenAI 的 GPT-6 Astra 与 Anthropic 的 Claude Opus 5.5 进行了全维度的横向对标:
| 评测维度 / 核心指标 | Gemini 4 Argon (Google) | GPT-6 Astra (OpenAI) | Claude Opus 5.5 (Anthropic) |
|---|---|---|---|
| 原生最大输出上限 (Output Tokens) | 1,000,000 (100万,行业唯一) | 128,000 (12.8万) | 64,000 (6.4万) |
| DeepSWE v1.1 软件工程通过率 | 77.9% (全球第一) | 73.2% | 71.8% |
| CWE-bench v1 自主漏洞攻防解决率 | 68.0% (防守型 SOTA) | 59.4% | 57.2% |
| LVBench 超长视频理解准确率 | 84.3% (多模态天花板) | 76.1% | 72.4% |
| 输入计费 / 1M Tokens (尝鲜价) | $2.00 | $5.00 | $15.00 |
| 输出计费 / 1M Tokens (尝鲜价) | $10.00 | $20.00 | $75.00 |
| 提示词缓存折扣 (Prompt Cache) | 95% 折扣 ($0.10 / 1M) | 50% 折扣 ($2.50 / 1M) | 90% 折扣 ($1.50 / 1M) |
综合评测显示:Gemini 4 Argon 在“超长单次生成韧性”、“真实软件仓库级工程落地”以及“长程智能体运维成本”上建立起了极其坚固的护城河,堪称当前前沿模型中综合生产力最强悍的重装巡洋舰。
七、高频核心疑难解答(Q&A)
针对连日来海外技术社区在 X (Twitter)、Reddit 与 Hacker News 上最关切的焦点疑问,我们整理了以下关键解答:
Q1:普通开发者现在如何才能申请体验到 Gemini 4 Argon?
答:由于具备高度自主的深层漏洞利用和内核级代码修改能力,Google 目前采取极其审慎的分阶段推送策略(Phased Rollout)。首批访问权严格限制在通过资质审查的 Google Fairwind 计划防卫伙伴与美国政府自愿性预先测试通道中。不过 Google 官方明确指出,面向企业 API 客户与 Google AI Ultra 订阅会员的早期体验通道预计将于 2026 年第四季度内逐步扩容开放,开发者可在 Google AI Studio 官网排队预约加入 Waitlist。
Q2:100万 Token 的超长输出上限,会不会导致模型在日常简单任务中变成“话痨”(Overthinking)?
答:不会。根据 DeepMind 披露的动态路由设计,Argon 的内部注意力头与思考链深度是根据输入问题的复杂度自适应触发的。当你询问简单问题(如“请帮我解释 Python 中的装饰器语法”)时,模型首字延迟仅为 180ms 左右,迅速在几十行内利落完成解答;只有当你提供包含几十个源文件并提出“请将该 C++ 异步网络库完整迁移至无锁 Rust 架构并编写测试集”时,它才会自动拉满内部长程推测解码与分层持久化引擎。
Q3:为什么 Google 优先把这一杀器赋能给网络安全防御,而不是直接开放对话端?
答:这是典型的“防守领先(Defense-First)”国家级安全战略。长程推理模型如果被恶意黑客滥用,可能用于批量挖掘全网零日漏洞并武器化。Google 通过 Fairwind 计划,让全球最顶级白帽黑客与基础设施捍卫者“领先防守一步”,在大规模黑客尚未反应过来之前,先行将全球开源底层软件的死锁、内存越界与竞态漏洞自动修复完毕,打造坚不可摧的“数字护城河”。
Q4:在像 Antigravity、Claude Code、Aider 这样的智能体工具中,如何将 Argon 的威力发挥到极致?
答:重点在于充分利用 Prefix Caching(前缀缓存)规范。在设计 Agent 提示词模板时,应务必将最稳定、最庞大、变动频率最低的代码库全量定义、API 文档与核心类型声明固定在 Prompt 最前端,而将动态变化的用户指令放在末尾。这样可以使系统稳稳命中 95% 的缓存巨额优惠,以每次调用仅需 $0.05 ~ $0.10 的极致微小成本,换取以往需要耗资数十美元才能完成的整库级自动化重构!
八、结语:长程智能体的新纪元已经拉开帷幕
纵观大语言模型走过的数年历程:我们经历了从 GPT-3 时代的“概率接龙”、到 GPT-4 / Gemini 1.5 时代的“大窗口吞吐”、再到 2026 年初的“测试时思维链摸索”。而今天 Gemini 4 Argon 的横空出世,正式吹响了 AI 全面挺进“百万级持续输出、自主真实软件重构与内生安全闭环”的全新纪元号角!
大模型不再仅仅是回答问题的聊天助手,而是真正演变为能够独当一面、在复杂工程世界里持续思考几个小时甚至几天并交付完整严密工程实体的“超级数字工程师”。正如 DeepMind 新任首席 AI 架构师 Koray Kavukcuoglu 所言:“我们正在见证从辅助编码到自主软件工程的历史交接。”未来已来,让我们拭目以待!