让 AI 画一只鹈鹕骑自行车:看似整活,实际上是在给大模型做一场空间智商考试
先说结论
“Generate an SVG of a pelican riding a bicycle”(生成一幅鹈鹕骑自行车的 SVG 图)并不是一句单纯的绘画提示词,而是一张很小、很刁钻的 AI 试卷。它同时要求模型认识鹈鹕、认识自行车、理解“骑在上面”的空间关系,还要把想法翻译成浏览器能显示的 SVG 代码。让任务再加上“车轮转动、脚蹬往复、鹈鹕身体上下起伏”,难度就从“会不会画”升级成了“会不会建模、会不会写程序、会不会检查自己的作业”。
本文复盘这个民间测试的来龙去脉,展示公开模型输出中的典型翻车现场,并给出一套完全离线、零第三方依赖的阅卷器:Windows 11 用 PowerShell,Ubuntu 26.04 和 macOS 26 用系统 Python。你可以手工执行,也可以交给 Agent 自动配置。最后还会解释:为什么一张滑稽的鹈鹕图,反而比很多“请总结一篇文章”更容易暴露模型的真实短板。
图 1:原创配图。测试表面上是在画鸟和自行车,实际考查的是概念组合、二维空间、代码生成与自我校验。
一、问题背景:为什么偏偏是“鹈鹕骑自行车”?
这个测试来自开发者 Simon Willison 在 2024 年 10 月公开记录的一次小实验。他给自己的 LLM 基准定了一个非常具体的题目:让不同模型生成“鹈鹕骑自行车”的 SVG。他的理由既诚实又重要:一是他喜欢鹈鹕,二是他认为互联网上当时几乎没有现成的“鹈鹕骑自行车 SVG”,因此模型不太可能只是从训练数据里背出答案。
这里有一个很生活化的比方。让 AI 写“春天很美”,像让学生写“今天的作文要有感情”——大家都可以套模板;但让学生画一只长嘴的鹈鹕骑车,就像老师突然要求“画一只大象坐在滑板上,还要让四个轮子大小一致”。题目不长,却没法只靠背范文混过去。
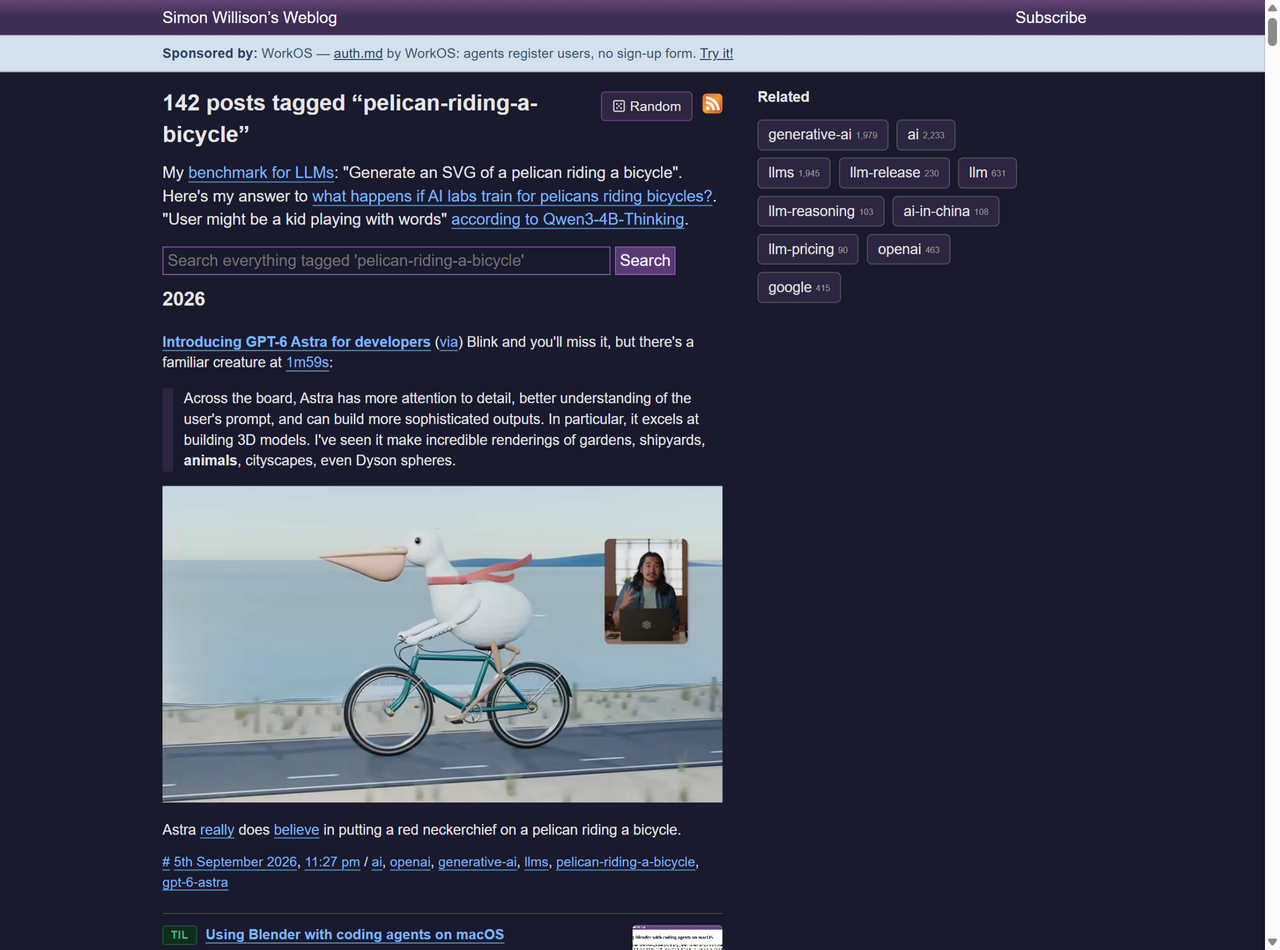
图 2:真实截图。Simon 的博客已经长期收集这一主题的模型输出,标签页后来发展成一份有趣的能力演进档案。
Simon 采用的原始提示词只有一句:
Generate an SVG of a pelican riding a bicycle
注意它没有告诉模型“鹈鹕应该是什么姿势”“车轮放在哪里”“要不要画翅膀”。模型必须自己补全这些常识。这一点很像给孩子一盒积木:题目只说“搭一辆能坐人的车”,真正的难点在于知道轮子要在下面、座位要在上面、车架要把结构连起来。
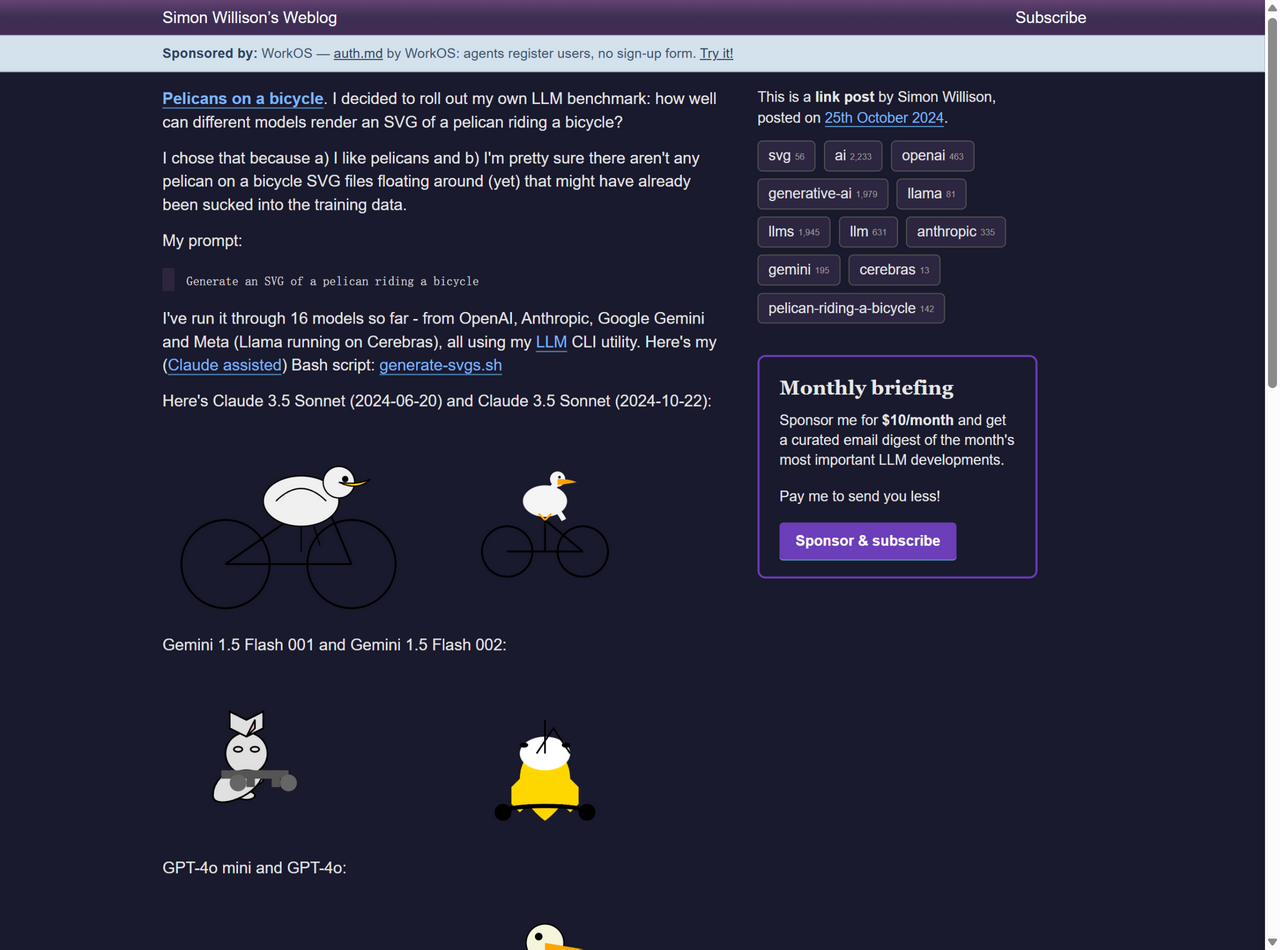
图 3:真实截图。出处文章记录了这一非正式基准的起点,以及最初一批模型的并排比较。
二、问题表现:模型不是“不会画”,而是“各自错在不同地方”
我从 Simon 公开仓库中下载了 22 份早期模型 SVG 输出,覆盖 Claude、GPT、Gemini、Llama 和 Amazon Nova 等系列。为了方便比较,我把其中几份放进了两张“试卷展览”。
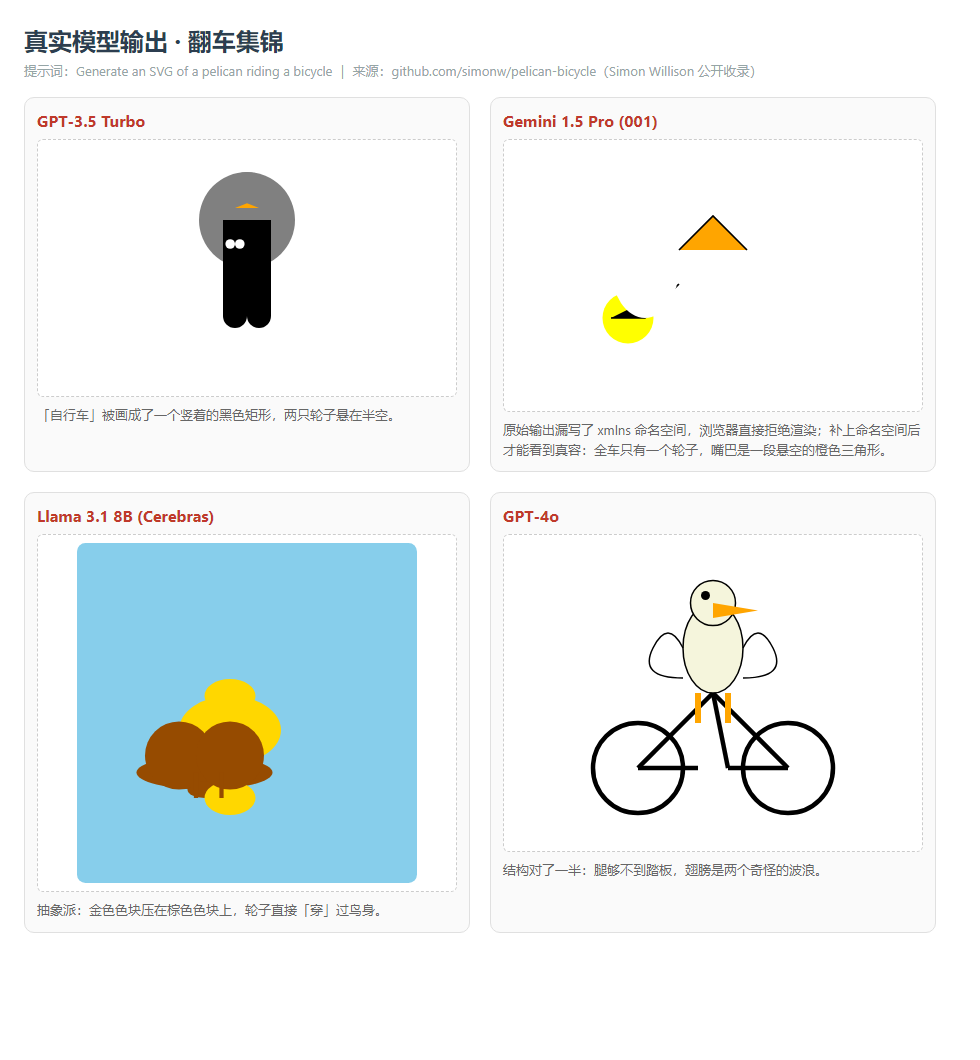
图 4:真实截图。GPT-3.5 Turbo 把自行车画成了黑色矩形;Gemini 1.5 Pro 001 只有一个轮子;较小模型则容易把鸟和车拼成色块。
典型问题可以分成七类:
- 轮子数量错:只有一个轮子,或把身体上的眼睛、轴心也误判成车轮。
- 轮子大小错:前轮和后轮一个像儿童车,一个像卡车。
- 轮子不接地:两个圆虽然存在,但底边不在同一条水平线上,车像悬浮在空中。
- 鸟和车没有关系:鹈鹕在车旁边站着,或者鸟身压住车轮,完全谈不上“骑”。
- 嘴巴和车把粘在一起:模型知道鹈鹕要有长嘴,也知道车要有车把,却没有处理两者的空间距离。
- 腿够不到踏板:腿画出来了,但脚停在半空;或者两条腿从同一侧伸出来。
- SVG 本身无法渲染:缺少
xmlns、viewBox不合法,甚至注释写法错误,导致浏览器直接拒绝显示。
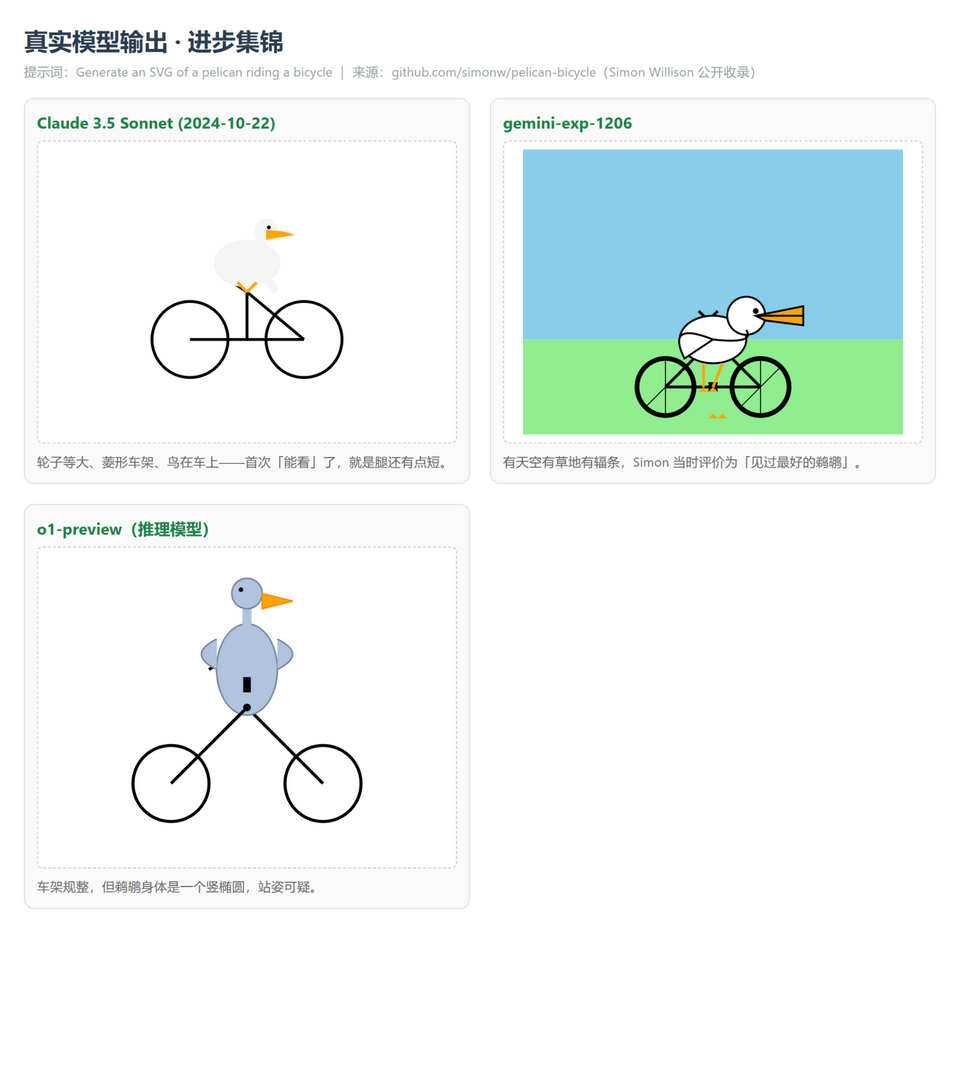
图 5:真实截图。Claude 3.5 Sonnet、Gemini experimental 1206、o1-preview 等输出已经能稳定表达“鸟在车上”,但仍然不等于机械结构完全正确。
早期结果尤其有意思:GPT-3.5 的代码很短,却把车架和轮子简化得近乎符号;Claude 3.5 Sonnet 已经能画出菱形车架、两个等大的轮子和长嘴鹈鹕;Gemini experimental 1206 甚至补了天空、草地和辐条。代码长度、画面好看程度和空间正确性并不总是同步,这也是它适合做工程测试的原因。
三、问题分析:一张图里藏着四张试卷
3.1 语义组合试卷:鹈鹕 + 自行车
单独问“鹈鹕是什么”,模型通常答得不错;单独问“自行车有哪些部件”,模型也会背。但“鹈鹕骑自行车”需要把两个概念放到同一张空间草图里。鹈鹕必须有长嘴、喉囊和翅膀,自行车必须有两个轮子、车架、车座和车把,最关键的是:鸟要坐在座位上,脚要接近踏板,车轮要在地面上。
这就是组合泛化。小学生也能理解:积木盒里有一只小鸟和一辆小车,不代表你已经知道怎么把小鸟放到车上。模型要先拆开概念,再重新组装。
3.2 几何试卷:SVG 是“会计算的画笔”
SVG 不是一张已经画好的照片,而是一组几何指令。circle 画圆,ellipse 画椭圆,line 画线,path 画曲线。模型必须决定坐标:两个轮子的圆心在哪里?鹈鹕身体的中心在哪里?喙要伸向哪里?
浏览器像一个非常严格的裁判。你说“把轮子放在这里”,它不会替你猜;坐标错了,它就照错的地方画。人眼看一张图可以凭感觉说“差不多”,但 SVG 会把“差 20 像素”原原本本地表现出来。
3.3 程序试卷:静态图和动画是两种难度
静态图只需要把几何体放到正确位置;动画还要处理时间。车轮旋转中心必须在轮轴,脚蹬要围绕中轴运动,脚要跟着踏板走,鹈鹕身体可以轻微上下摆动,但不能像火箭一样跳起来。
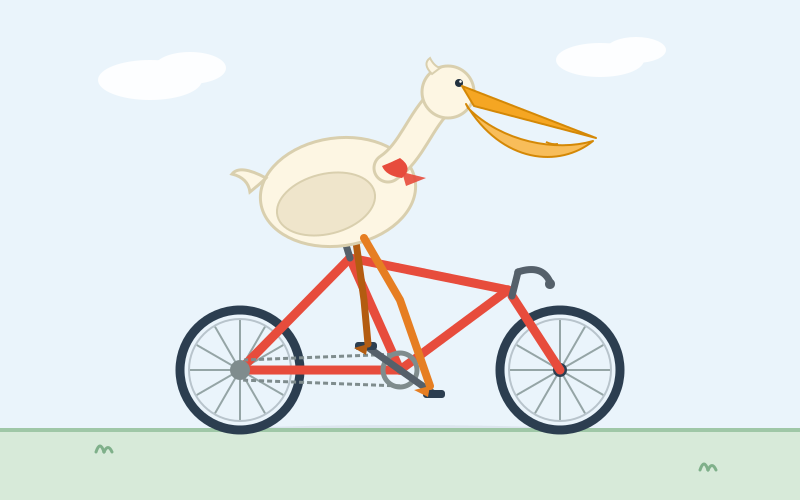
图 6:原创配图。静态 SVG 版本把关键几何关系做成了可检查的结构:两个等大轮子、地面线、菱形车架、鸟身和橙色喙。
动画其实像骑自行车本身:轮子转得再漂亮,如果脚没有踩到踏板,观众还是会觉得不对。下面这张是纯 SVG 动画,不依赖 JavaScript,也不请求网络资源。
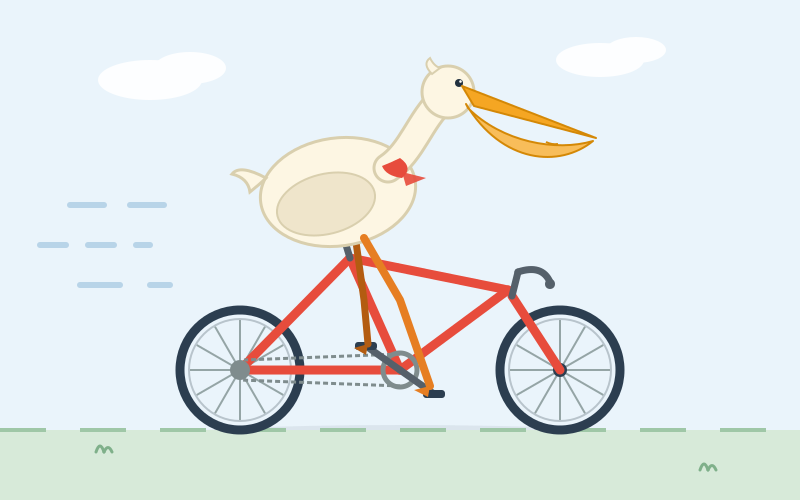
图 7:原创配图。动画版使用 SVG 内置的 animate 与 animateTransform,可以直接在浏览器中播放。
3.4 自我检查试卷:模型看到了自己的作业吗?
人类画画时会不断抬头看纸:轮子歪了就擦掉重画,鸟嘴碰到车把就挪一挪。很多语言模型却像蒙着眼睛写答案:生成完一大段 SVG 后,没有把它渲染出来,也没有检查结果。
图 8:原创配图。语言模型如果只生成代码、不渲染、不回看,就像蒙眼睛画画;人类至少会不断看纸修改。
这也是“让 AI 制作 2D 动画”比“让 AI 给出一段代码”更有价值的地方。动画会把隐藏的错误放大:静态图里不明显的脚蹬,转起来会突然飞走;轮轴偏了一点,旋转时会像喝醉了一样摆动。
四、问题根因:大模型为什么会把“会画”与“画对”分开?
第一,语言模型的本质是预测下一个 token。它可以非常熟练地预测“自行车通常有两个轮子”“鹈鹕通常有长嘴”,却不一定真正维护一份稳定的二维坐标表。像一个背过很多建筑名词的人,不一定真的会砌一面垂直的砖墙。
第二,训练数据里的代码和图片并不总是绑定在一起。模型可能见过大量 SVG 片段,却很少见过“鹈鹕骑自行车”这个具体组合,所以它会把熟悉的局部拼在一起,形成陌生的整体。
第三,生成链路经常缺少视觉闭环。代码生成器输出 SVG,渲染器负责显示,视觉模型负责理解,三者如果没有自动串起来,错误就会停留在“看起来像代码”的阶段。
第四,民间基准也可能被过度训练。Dylan Castillo 曾用多种动物与车辆组合研究所谓的“pelicanmaxxing”,讨论 AI 实验室是否专门针对这一提示词训练。这个提醒很重要:鹈鹕测试适合做快速体检,不适合冒充完整智商证明。如果所有模型都背熟了同一道题,我们测到的可能是记忆,不是推理。
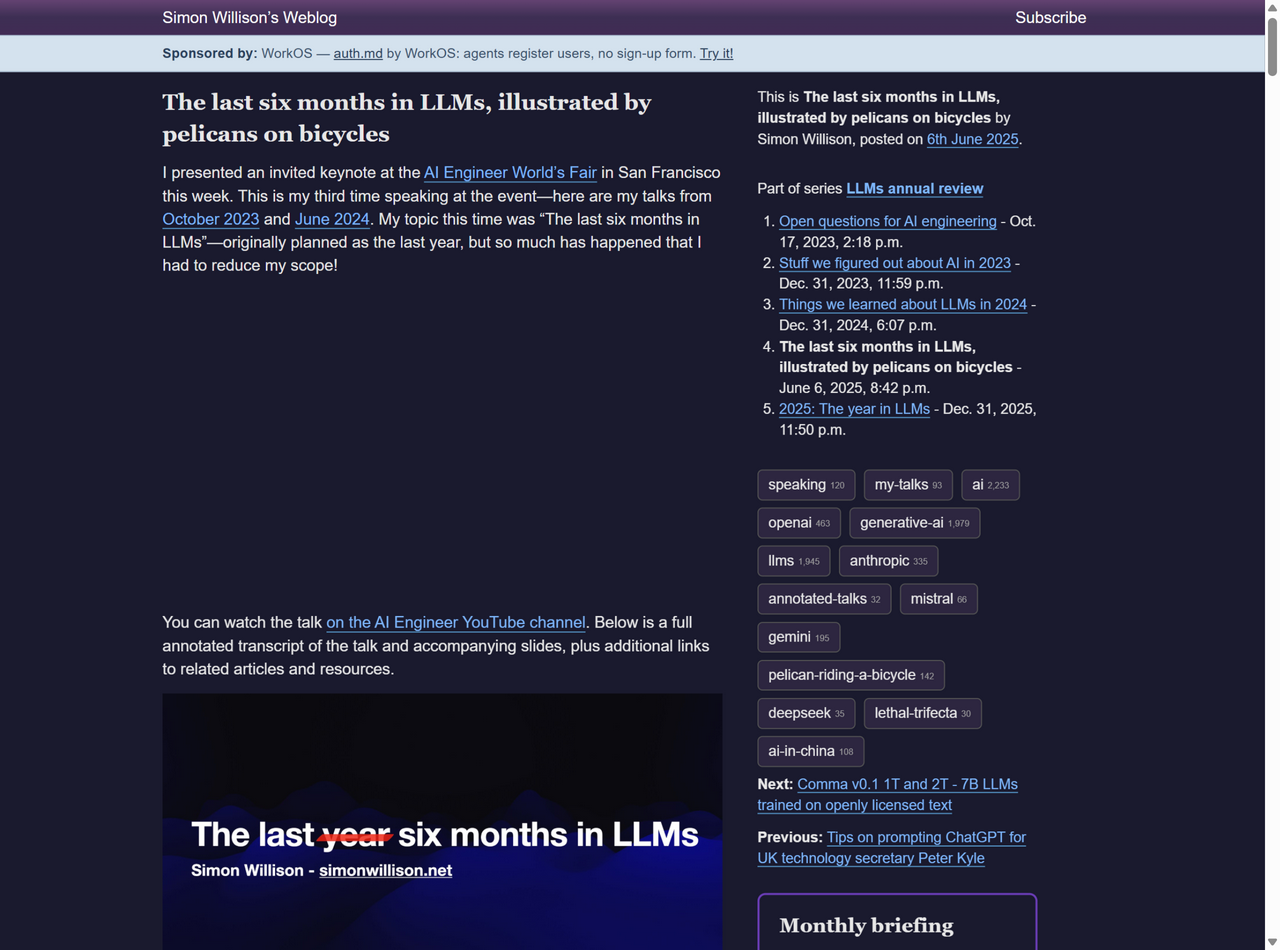
图 9:真实截图。Simon Willison 还在演讲中用这些鹈鹕图串起大模型能力的变化;它更像一条可视化时间线,而不是严格的学术排行榜。
五、如何解决:把一次性作答改造成“生成—渲染—自检”闭环
最有效的改进不是继续堆更长的提示词,而是让 Agent 看到自己的结果。推荐流程如下:
- 让模型生成 SVG,并明确要求输出完整、可独立打开的文件。
- 用浏览器或本地渲染器打开 SVG。
- 截图或读取渲染结果。
- 按清单检查:两个轮子吗?轮子等大吗?底边同高吗?鸟在车上吗?嘴巴是橙色吗?动画是否真的动?
- 把问题和截图发回模型,让它只修改出错部分。
- 最多循环 2—4 轮,超过次数就停止并保留失败样本。
图 10:原创配图。给 Agent 配上渲染器和检查清单,就像给蒙眼画家配了一位监考老师。
5.1 人工自动执行:一条命令开始阅卷
我把阅卷器放在文章配套目录中,核心文件名为 pelican_exam.py。它只使用 Python 标准库,不联网、不上传 SVG、不调用第三方 API。评分不是审美评分,而是启发式几何检查:
- SVG 根元素和
xmlns:10 分; viewBox:10 分;- 两个车轮级大圆:15 分;
- 两轮半径一致:10 分;
- 两轮底边同高:10 分;
- 车轮上方有鸟身:10 分;
- 橙色喙:10 分;
- 线或路径骨架:10 分;
- 构图至少占画面 20%:15 分;
- 检测到 SVG 动画元素:额外提示,不混入静态满分。
Windows 11
# 1. 生成模板(首次执行)
.\\pelican-exam-windows11.ps1

# 2. 把 AI 输出粘贴进 my-answer.svg 后阅卷
.\\pelican-exam-windows11.ps1 .\\my-answer.svg
脚本使用 PowerShell 自带 XML 解析器,完全离线。若系统阻止本地脚本,可以只对当前进程放行:
Set-ExecutionPolicy -Scope Process Bypass
Ubuntu 26.04
chmod +x pelican-exam-ubuntu2604.sh
./pelican-exam-ubuntu2604.sh
./pelican-exam-ubuntu2604.sh my-answer.svg
macOS 26
chmod +x pelican-exam-macos26.zsh
./pelican-exam-macos26.zsh
./pelican-exam-macos26.zsh my-answer.svg
Ubuntu 和 macOS 版本只使用系统自带的 Python 3 标准库。若安装的是精简系统,脚本会提示缺少 python3;不需要安装 Pillow、Cairo、浏览器插件或任何在线服务。
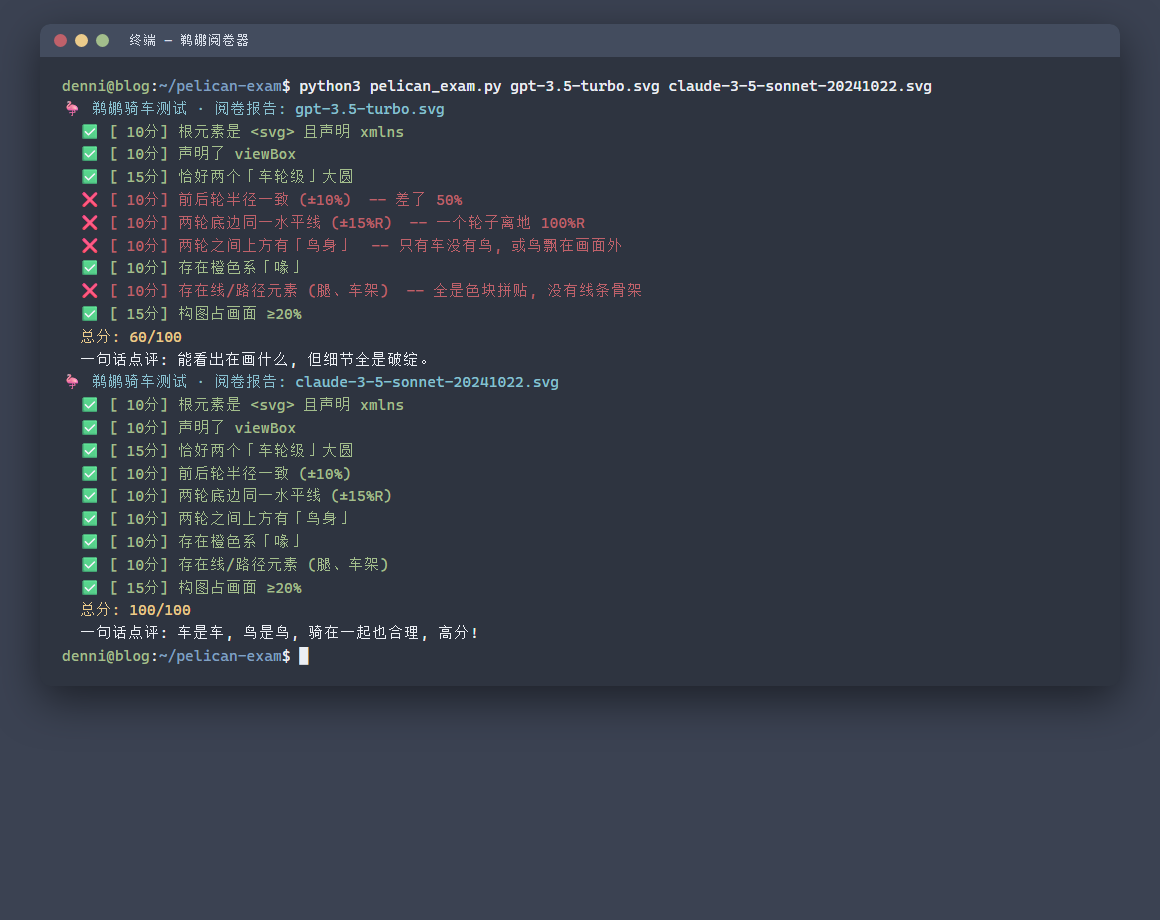
图 11:真实截图。本地阅卷器对 GPT-3.5 Turbo 与 Claude 3.5 Sonnet 的输出逐项打分,并解释扣分原因。
5.2 Agent 自动配置:让 Agent 自己搭考场
把下面这段任务说明交给本地 Agent 即可。它不需要访问外部服务:
请在当前目录创建 pelican-exam 目录。
1. 写入 pelican_exam.py、pelican-exam-windows11.ps1、pelican-exam-ubuntu2604.sh、pelican-exam-macos26.zsh。
2. 所有脚本只能使用操作系统自带能力,不得 pip/npm 安装依赖,不得联网上传文件。
3. 先运行 python3 pelican_exam.py --demo,确认坏样本约 10 分、好样本约 100 分。
4. 再对当前目录下的 SVG 批量阅卷,输出每一项通过/失败和总分。
5. 如果发现 SVG XML 无法解析,只报告错误,不要自动覆盖原文件。
6. 最后生成一份 JSON 或 Markdown 报告,列出文件名、总分和失败原因。
人工方式像老师一张张批卷,Agent 方式像把“出题、收卷、统计”交给助教。两者的评分规则相同,区别只是操作入口不同。
六、一个可复用的提示词:先把试卷说清楚
如果你确实想让模型一次生成更好的动画,可以使用下面的版本。但请注意:提示词只能降低错误概率,不能替代渲染检查。
Create one self-contained animated SVG, 800x500 viewBox, with no external assets.
Draw a recognizable brown-and-white pelican riding a red bicycle on a green ground line.
The bicycle must have exactly two equal-size wheels whose bottoms share the same y coordinate,
a visible diamond frame, a seat, handlebar, crank and two pedals.
The pelican must sit above the seat, have two orange legs reaching the pedals,
a long orange beak pointing toward (but not touching) the handlebar, one visible eye and wings.
Animate both wheels around their own hubs, animate the crank and pedals around the bottom bracket,
and add a subtle body bob. Use SVG animate/animateTransform only; do not use external JavaScript.
After generating, mentally verify: two wheels, equal radii, same ground level, bird on bike,
beak separated from handlebar, both feet connected to pedals, and valid XML.
Return only the SVG.
这个提示词用了“验收标准前置”的办法,相当于考试前把评分表发给学生。它能提高指令遵循,但不能证明模型真的看到了最终画面,所以仍建议配合闭环。
七、Q&A:这真的是在测 AI 智商吗?
Q1:画得好看就代表模型更聪明吗?
不代表。它更像汽车仪表盘上的一个小指针,只能告诉你某些方面有没有明显异常。一个模型可能很会写代码,却不擅长构图;另一个模型可能画面漂亮,却无法解释坐标和动画原理。
Q2:为什么不用标准数学题或代码题?
标准题当然要用,但它们容易被训练数据覆盖。鹈鹕骑车把语言、几何、代码、视觉和动画混在一起,答案空间更开放。它不是替代标准评测,而是一个便宜、直观、适合快速回归测试的补充。
Q3:为什么 SVG 比 PNG 更适合这个测试?
SVG 是文本代码,方便保存、比较、审计和自动修改。你可以检查元素数量、圆心坐标、颜色和动画标签;PNG 只告诉你“最后长什么样”,却不容易知道模型是怎么画出来的。
Q4:模型能不能专门背这道题?
当然可以,所以不要只测一只鹈鹕。可以轮换成“鸭子驾驶三轮车”“长颈鹿骑独轮车”“企鹅推着购物车”,再随机改变颜色、姿态和动画要求。单题高分只能说明它通过了这道题,不代表通用推理能力无穷大。
Q5:这套离线阅卷器会不会误判?
会。它主要检查几何结构和 SVG 语法,不能真正理解“这是鹈鹕”还是“只是一个白色椭圆”。因此我把它定位成机械阅卷器:先筛掉明显错误,再由人或视觉模型做第二轮审美和语义复核。
八、结语:真正的考试不是“画出来”,而是“发现自己画错了”
鹈鹕骑自行车之所以有趣,是因为它把一个宏大的 AI 问题压缩成了一个人人都能看懂的小场景。我们不需要先读几十页论文,只要看一眼:车有两个轮子吗?鸟坐上去了吗?脚能踩到踏板吗?轮子转起来会不会原地发疯?
从公开输出看,大模型的进步非常明显:从矩形车架、单轮自行车,到能表达鸟、车、地面和动画的完整场景。但更值得关注的不是“哪家模型赢了”,而是测试暴露出的工程事实:生成能力必须和渲染、观测、验证、修复组成闭环。
下一次你要评估一个新模型,不妨先别问它“你有多聪明”。给它一只鹈鹕、一辆自行车,再给它一个浏览器。真正优秀的模型,不只是把代码写得像答案,而是能把车轮放在地上,看到自己的错误,然后把鹈鹕稳稳地骑起来。
参考资料
- Simon Willison:Pelicans on a bicycle(基准起源)
- Simon Willison:Pelican-riding-a-bicycle 标签归档
- GitHub:simonw/pelican-bicycle(公开 SVG 样本)
- Simon Willison:The last six months in LLMs, illustrated by pelicans on bicycles
- Dylan Castillo:Are AI labs pelicanmaxxing?
- Nile the Bot:Every Pelican That Ever Rode a Bicycle
- Hugging Face:Pelican Benchmark
- Hacker News:The last six months in LLMs