容器显示 Up 4 周,网站却 530 了:Cloudflare Tunnel 被 QUIC 悄悄拖垮的一次排障
这次故障最迷惑人的地方,是所有能看到的东西都显示正常。
下载站的源站在内网里打开,0.008 秒就返回 200。负责公网映射的 cloudflared 容器,docker ps 里写着 Up 4 weeks。可从外面访问,浏览器只给出一句冷冰冰的 error code: 1033,HTTP 状态码是 530。
最后查明:容器还活着,但容器里面那几条通往 Cloudflare 的隧道连接已经全部断开。罪魁祸首是 QUIC 所依赖的 UDP 7844 出口出现间歇性超时,而一个两年没升级的旧版连接器,在“改走 http2”这一步没站稳,自己退出了。
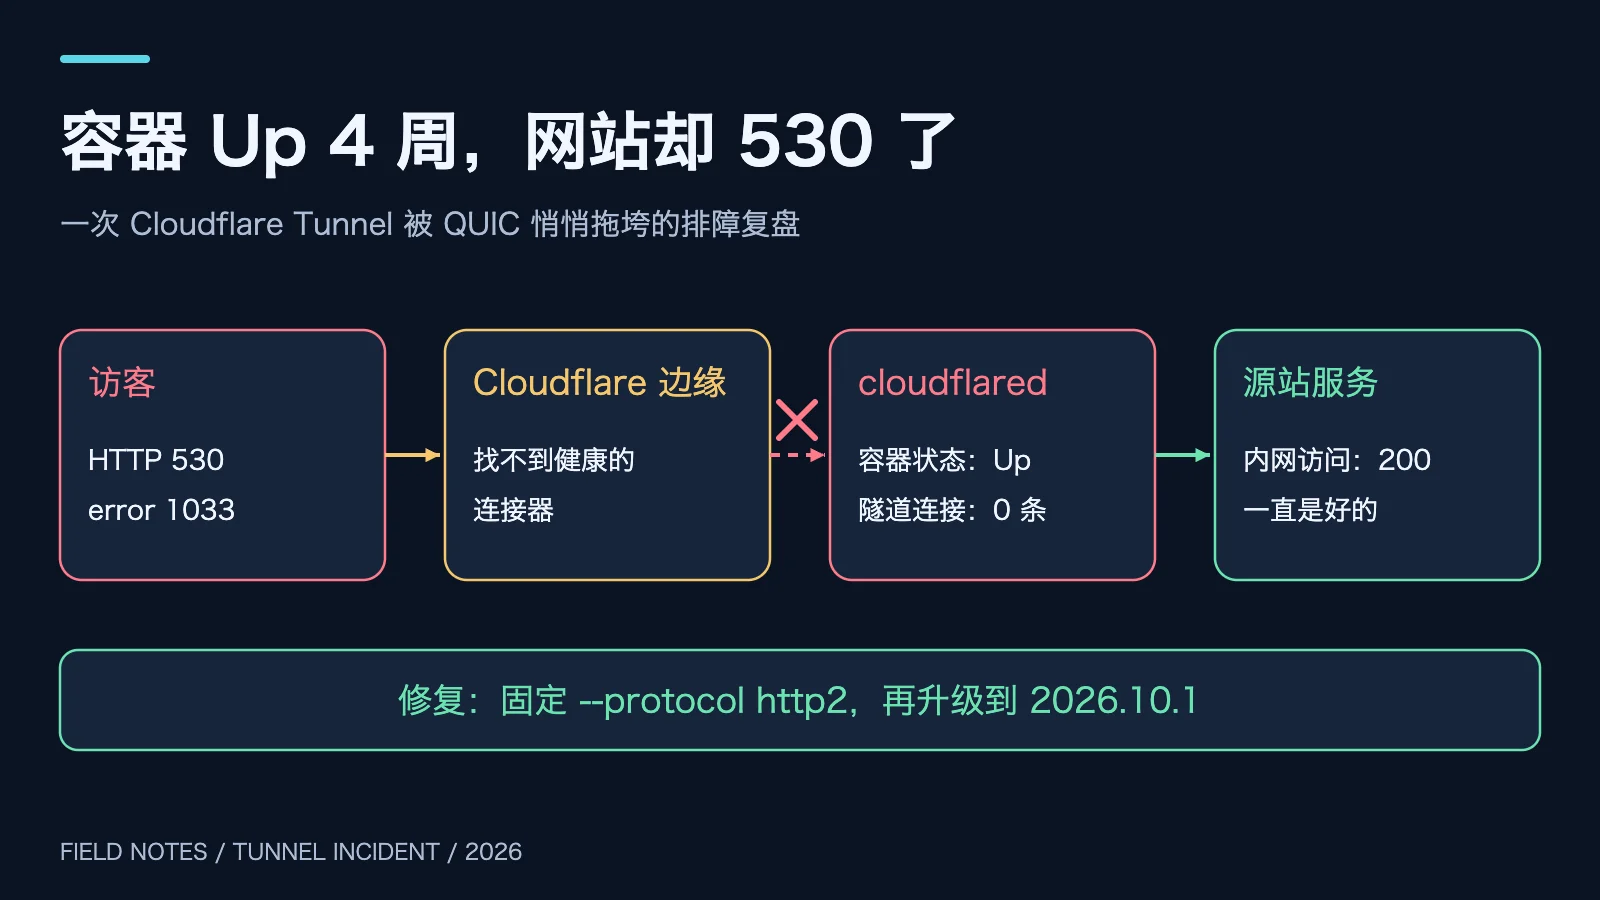
图 1:本文原创示意图。四个角色里只有一个真正出了问题,而它恰好是表面上看起来最健康的那个。
一、先说背景:一个用 Tunnel 发布出去的下载站
我在 用 Cloudflare Tunnel 把内网服务变成公网 HTTPS 那篇文章里讲过这套玩法:家里不用公网 IP,也不用在路由器上开 80/443 端口,只要在内网跑一个 cloudflared 连接器,它会主动连到 Cloudflare,公网用户的请求再顺着这条连接送回内网。
这次出问题的是一个文件下载站,跑在一台 Docker 主机上。cloudflared 则跑在另一台由 Portainer 管理的虚拟机里,以 Docker Compose 栈的方式部署,一条隧道同时挂着好几个公网域名。
为了方便阅读,文中只使用角色名:“源站主机”运行下载站,“连接器主机”运行 cloudflared。所有内网地址、计算机名称、内网域名、隧道 ID 和 Token 都已省略;日志里的边缘节点地址也只保留到网段。时间、版本号、日志原文和命令行为都来自现场记录。
二、问题表现:三个“正常”,一个“打不开”
先把现场能看到的信号摆出来:
- 公网访问下载站:HTTP 530,正文只有一行 error code: 1033,大约 5 秒后返回。
- 内网直接访问源站端口:HTTP 200,耗时 8 毫秒。
- 源站容器、连接器容器:都在运行,没有重启记录。
- 同一条隧道上的另一个代码托管站:同样是 530。
最后一条很关键。两个完全不同的服务一起挂,说明问题不在某个服务本身,而在它们共用的那一段:隧道。
先用一个生活里的场景打个比方。cloudflared 像小区门口的快递驿站,Cloudflare 边缘像城市快递总站。驿站每天一早主动给总站拉好 4 条专线,总站收到寄往小区的包裹,就顺着专线送过来,驿站再转交到你家门口。你家门一直开着(源站 200),驿站的灯也一直亮着(容器 Up),可如果 4 条专线全断了,总站手里的包裹就送不出去,只能退回给寄件人,退件单上写的就是 1033。
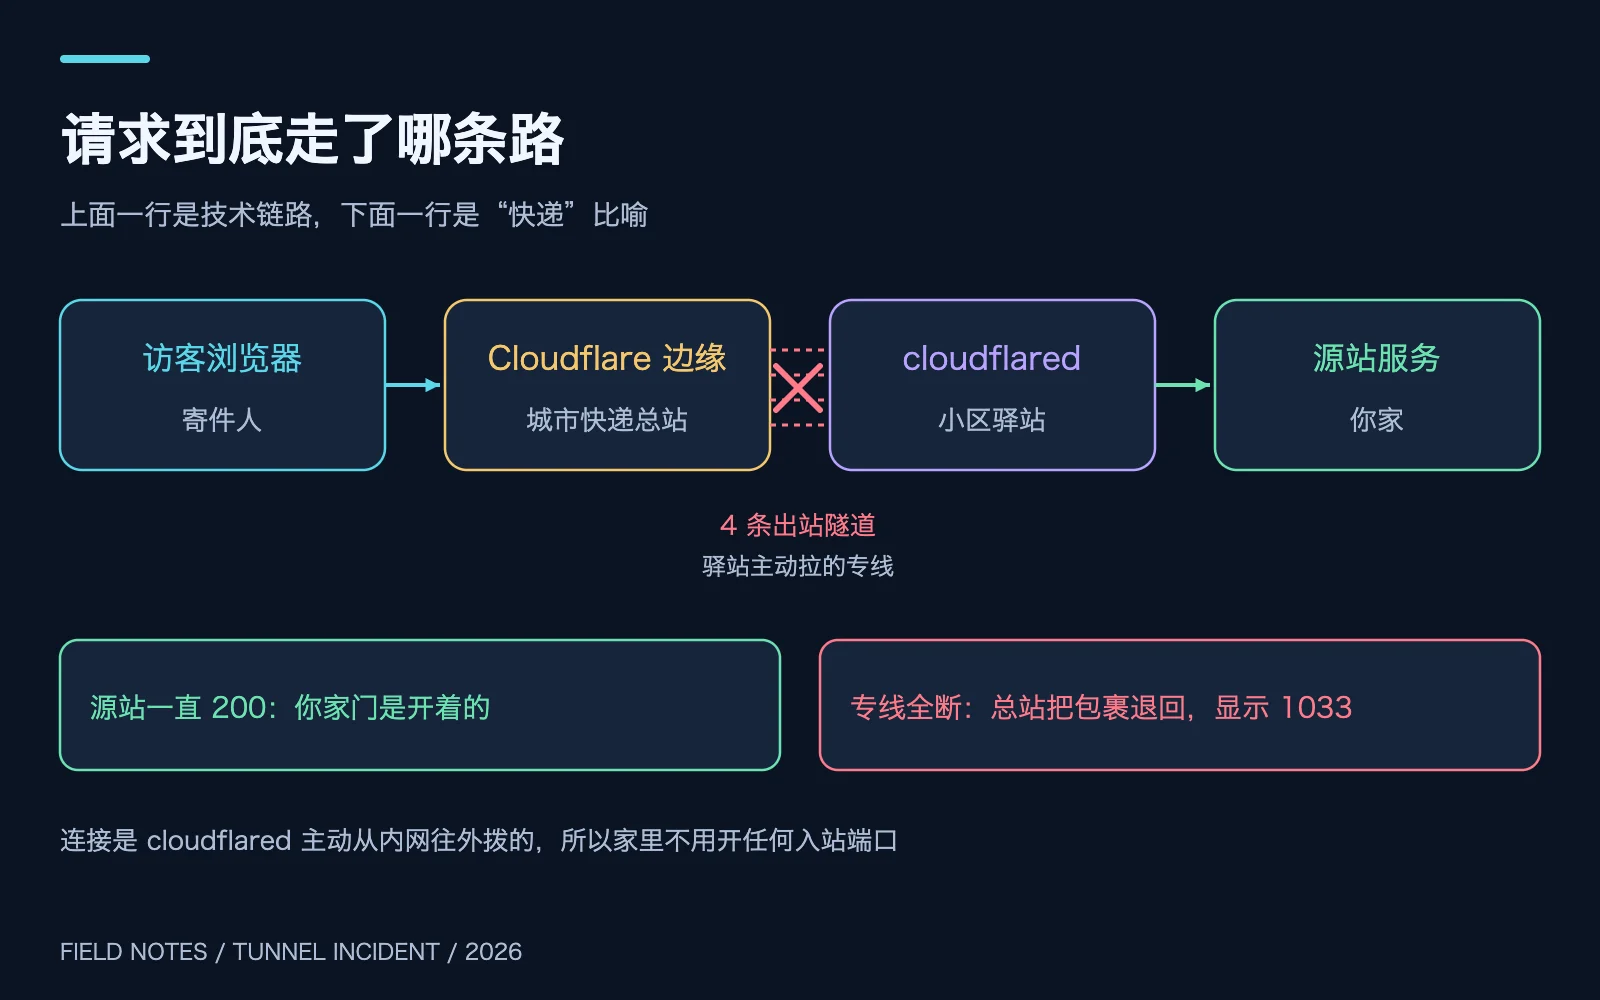
图 2:本文原创示意图。连接方向是从内网往外拨的,这也是 Tunnel 不需要开入站端口的原因。
三、530 和 1033 分别在说什么
很多人看到 5xx 第一反应是“服务器挂了”,于是去重启源站。这次如果这么做,只会白忙一场。
Cloudflare 官方文档对 530 的解释是:Cloudflare 在解析源站主机名时遇到问题,这种情况下响应正文会带一个 1XXX 错误码,要按这个具体错误码去排查。换句话说,530 只是一个“信封”,真正的信息在信封里的那张纸条上。
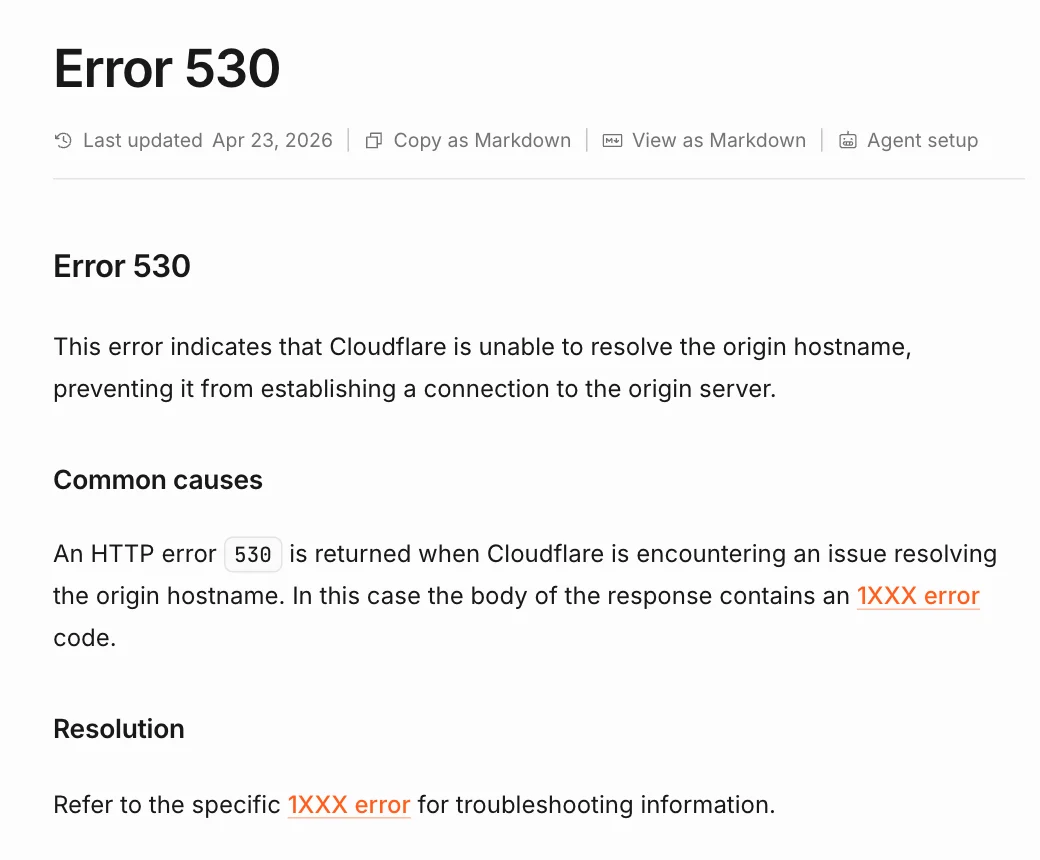
图 3:真实截图,来源 Cloudflare 官方文档 Error 530 页面。530 本身不说明原因,原因写在正文的 1XXX 错误码里。
纸条上写的是 1033。官方文档说得非常直白:1033 表示你的隧道没有连到 Cloudflare 网络,因为 Cloudflare 找不到一个健康的 cloudflared 实例来接收流量。下面的状态表也值得记住:Healthy 表示隧道通过 4 条连接接入 Cloudflare 全球网络;Down 表示曾经连上、现在断了,要检查服务是否在运行、机器是否断电、程序是否崩溃,或者网络最近有没有变化。
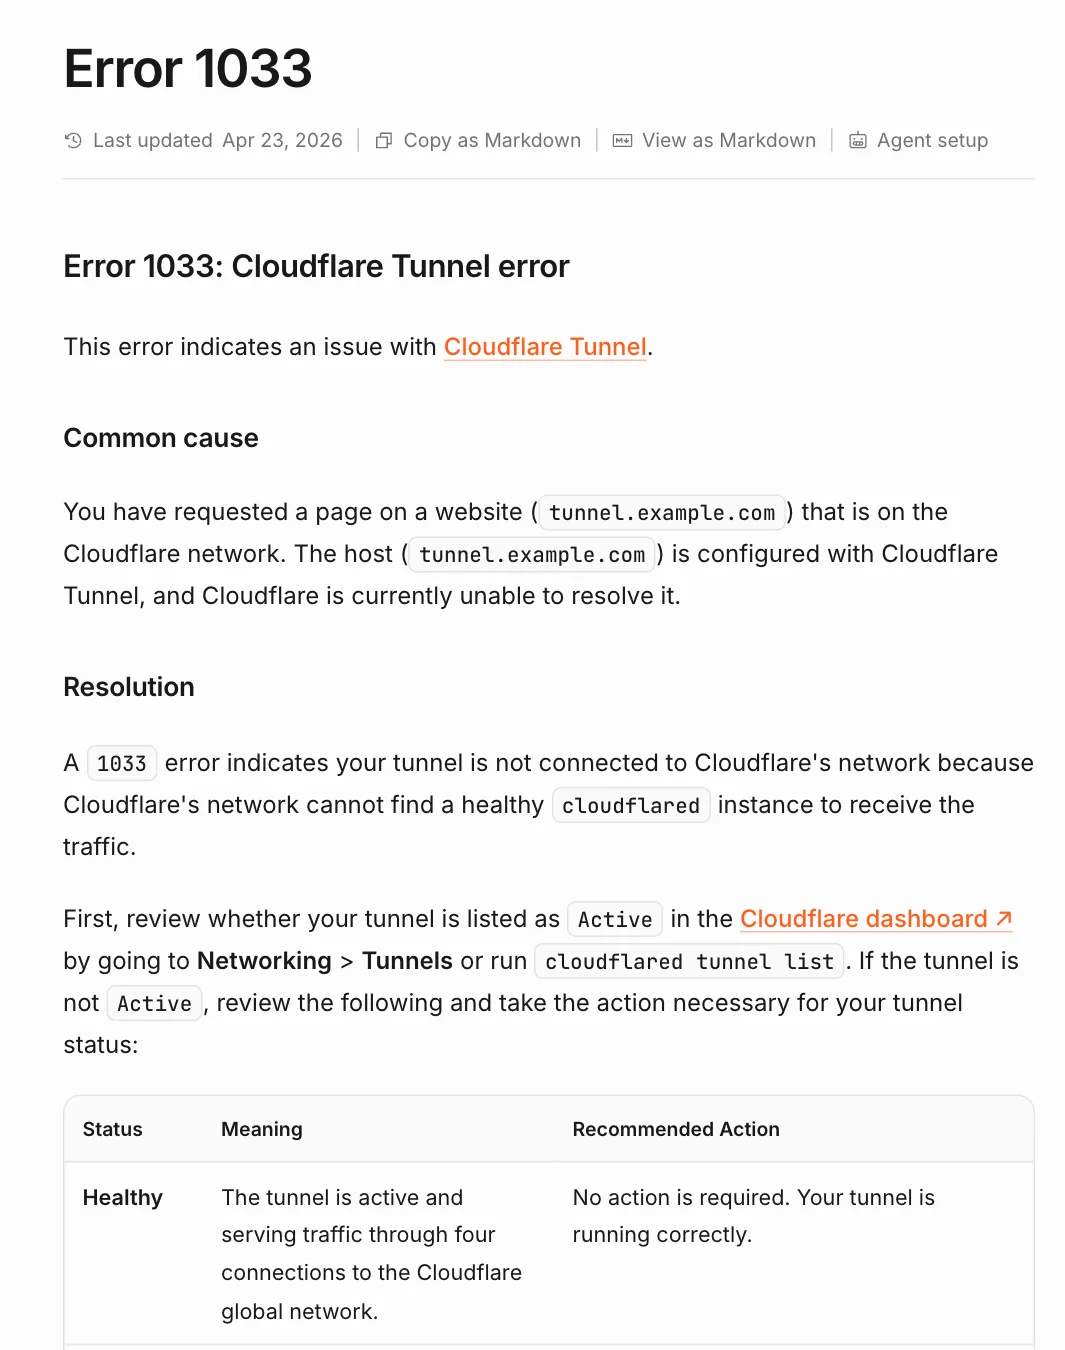
图 4:真实截图,来源 Cloudflare 官方文档 Error 1033 页面。注意 Healthy 一栏写的是“四条连接”,这正是后面判断修复是否成功的标准。
所以排查方向一下子就清楚了:不用碰源站,直接去找 cloudflared。
四、第一个坑:cloudflared 根本不在你以为的那台机器上
我先登录源站主机,docker ps、systemctl、ps 都翻了一遍,没有任何 cloudflared 进程。这在家庭实验室里很常见:服务越攒越多,当初是哪台机器负责“连隧道”,时间一长就记不清了。
找它的办法也很朴素:对内网几个网段里能 SSH 登录的机器,批量查一遍有没有 cloudflared 进程或容器。很快在一台运行 Portainer 的虚拟机上找到了它,一个以 Compose 栈部署的容器,状态 Up 4 weeks,restart 策略是 always。
这里顺手记一个经验:在 Cloudflare 后台的隧道详情页里,通常能看到每个连接器的来源 IP 和主机名。下次遇到类似情况,先看后台,比满网段找要快。
五、日志里的真相:容器活着,隧道已经死了
docker logs 往回翻,时间线非常清楚(以下时间均为 UTC):
02:01:38 WRN Failed to serve quic connection error="timeout: no recent network activity" connIndex=0
02:01:38 WRN Connection terminated error="there are no free edge addresses left to resolve to" connIndex=0
02:01:42 ERR Failed to serve quic connection error="failed to accept QUIC stream: timeout: no recent network activity" connIndex=1
02:01:44 ERR Connection terminated error="failed to accept QUIC stream: timeout: no recent network activity" connIndex=1
翻译成人话:4 条 QUIC 连接因为“一段时间没有任何网络活动”先后超时;其中一条在重连时把可用的边缘地址都试完了,报出 no free edge addresses left,然后就不再尝试。进程本身没有退出,所以 Docker 认为一切正常,也就不会触发 restart: always。
这就是“容器 Up,隧道 0 条”的由来。容器的健康只代表进程还在,不代表它还在干活。好比驿站的灯亮着、店员也在,但电话线全断了,外面的人怎么打都打不进来。
接着我做了最直觉的操作:重启容器。结果更有意思:
02:05:01 INF Starting tunnel ... Initial protocol quic
02:05:11 ERR Failed to serve quic connection error="failed to accept QUIC stream: timeout: no recent network activity"
02:05:12 WRN If this log occurs persistently, and cloudflared is unable to connect to Cloudflare Network with `quic` protocol,
         then most likely your machine/network is getting its egress UDP to port 7844 (or others) blocked or dropped.
02:05:12 INF Switching to fallback protocol http2
02:05:12 INF Tunnel server stopped
02:05:12 ERR Initiating shutdown error="failed to accept QUIC stream: timeout: no recent network activity"
02:05:13 INF Starting tunnel ... Initial protocol quic
新进程一开始还是用 QUIC,10 秒后又超时。cloudflared 自己也给出了提示:如果这条日志持续出现,多半是出口的 UDP 7844 被拦截或丢弃。然后它说“切换到备用协议 http2”,可紧接着打印的却是 Tunnel server stopped 和 Initiating shutdown。进程退出,Docker 把它拉起来,新进程又从 QUIC 开始,再超时,再退出,形成一个循环。
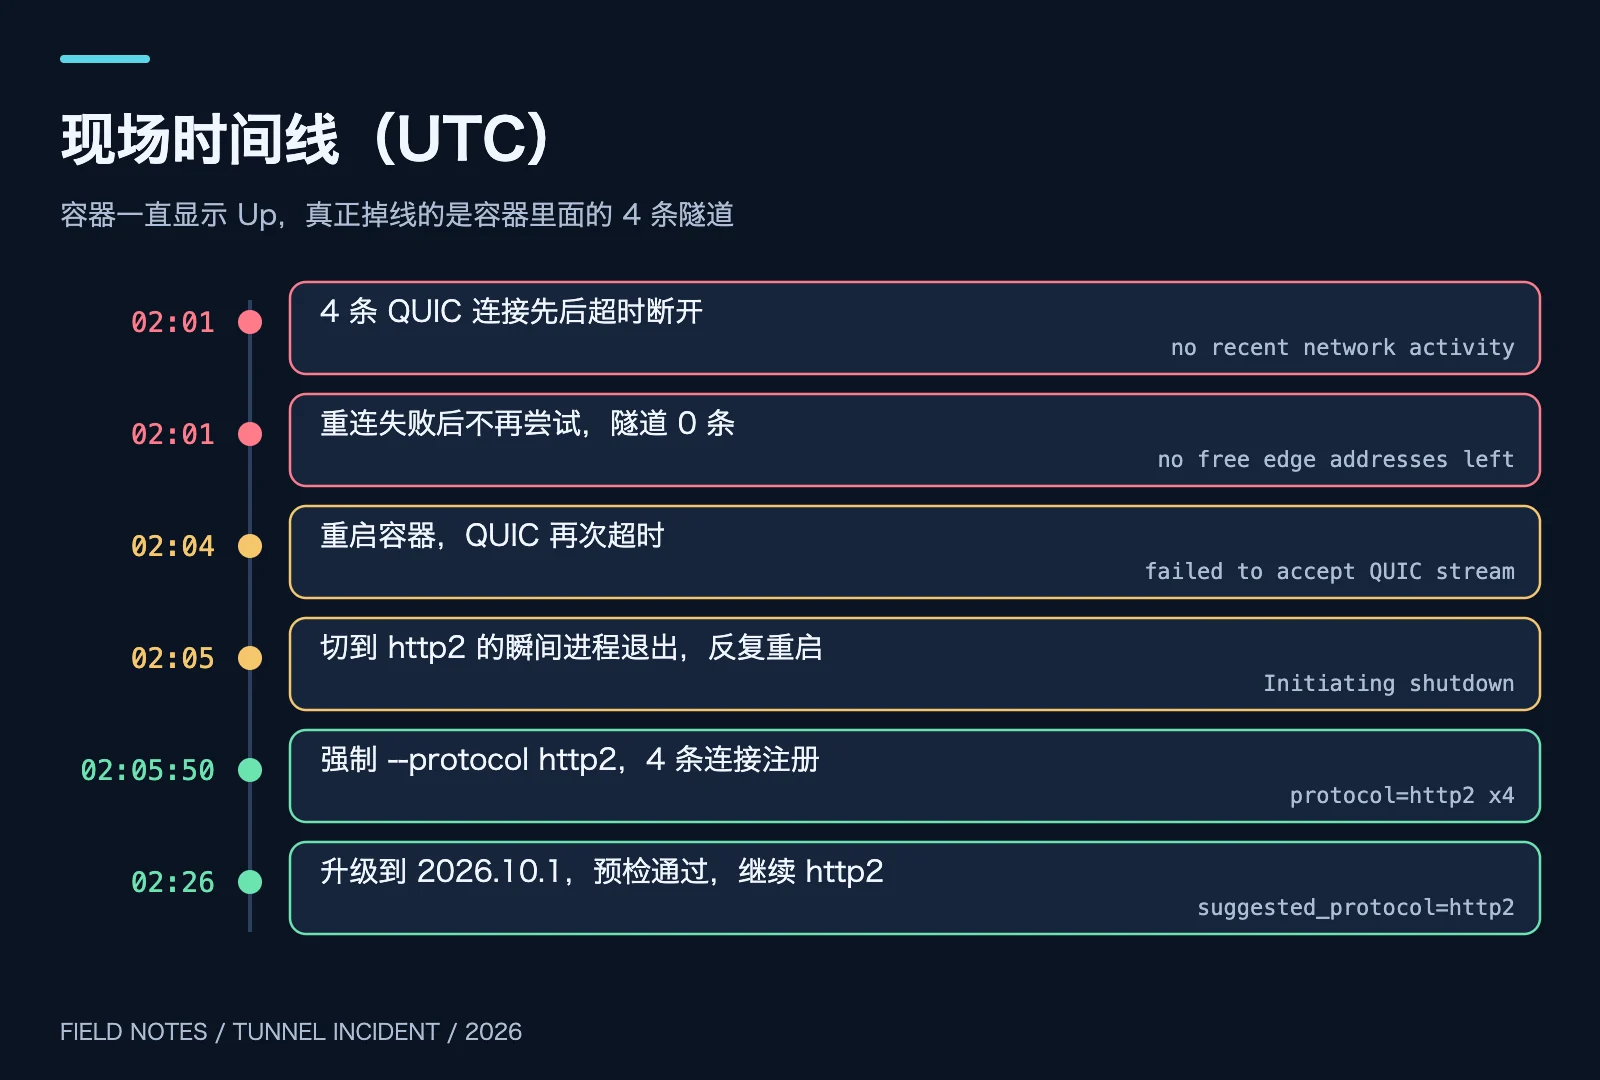
图 5:本文原创示意图,时间来自现场日志。前两步是“静默掉线”,中间两步是“重启也救不回来”。
六、QUIC 和 http2:同一个端口,两条完全不同的路
要理解为什么会这样,需要先知道 cloudflared 和 Cloudflare 之间有两种“交通方式”。
官方防火墙文档写得很明确:cloudflared 通过 7844 端口连接 Cloudflare 全球网络。使用 quic 协议时走 UDP,使用 http2 协议时走 TCP。
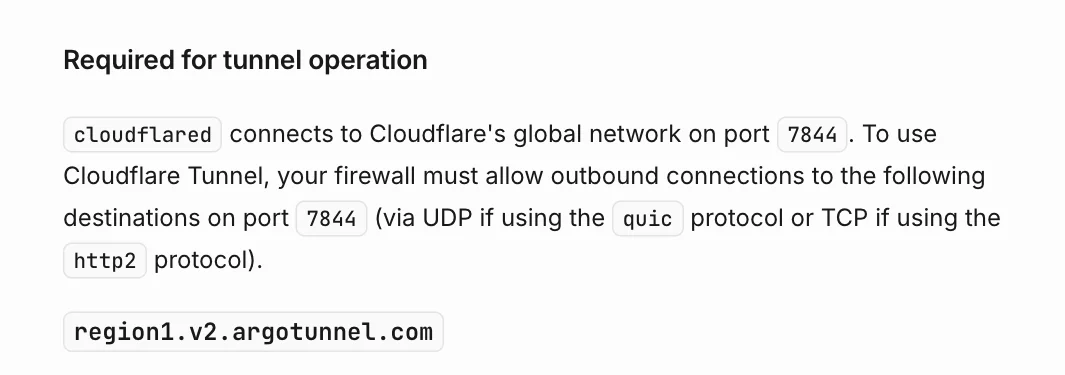
图 6:真实截图,来源 Cloudflare 官方文档 Tunnel with firewall 页面。原页面下方列有边缘节点地址表,截图时已裁掉。
再打个比方。QUIC 像高速公路上的 ETC 车道:快,切换网络时不容易断,但它依赖 UDP 这条“高速公路”本身畅通。http2 像国道:慢一点点,可它走的是 TCP,几乎所有网络环境都放行,很少被临时封闭。
UDP 天生“不打招呼”。路由器、防火墙、运营商设备对 UDP 会话往往更苛刻:空闲超时更短、高峰时更容易被丢包、某些策略还会随时间变化。一段时间收不到对方的数据包,QUIC 就会判定连接已死,这正是日志里 no recent network activity 的意思。
这里必须把证据说清楚:现场 UDP 并不是被彻底封死。升级到新版以后,cloudflared 启动时的连接预检显示 UDP Connectivity 是 pass,QUIC 连接成功。也就是说,这条 UDP 出口是“时好时坏”。持续超时的那几分钟,QUIC 就是连不上;过一阵又恢复。对于一个需要长期在线的连接器来说,“时好时坏”比“彻底不通”更危险,因为它让程序反复在两条路之间犹豫。
七、根因:网络抖了一下,旧版连接器自己摔倒了
把证据串起来,根因分两层:
第一层是触发条件。连接器主机出口的 UDP 7844 在这段时间内间歇性超时,4 条 QUIC 连接全部断开。
第二层是放大器。现场运行的是 cloudflared 2024.6.1,一个两年没更新的版本。它在 QUIC 失败后确实想回退到 http2,可在这次日志里,回退那一刻进程直接退出了;同时,在最早那次断线里,它把可用边缘地址试完以后就停止重连,进程却没退出,Docker 也就不会帮它重启。前者导致“重启也救不回来”,后者导致“没人发现它已经掉线”。
为什么镜像会旧到这个程度?Compose 文件里写的是 latest,但镜像是从一个内网私有仓库拉的。那个仓库后来迁移了,旧地址已经不存在,主机本地缓存的 latest 永远停在了 2024 年。latest 这个标签看着省心,其实只是“上次拉取时的最新”。
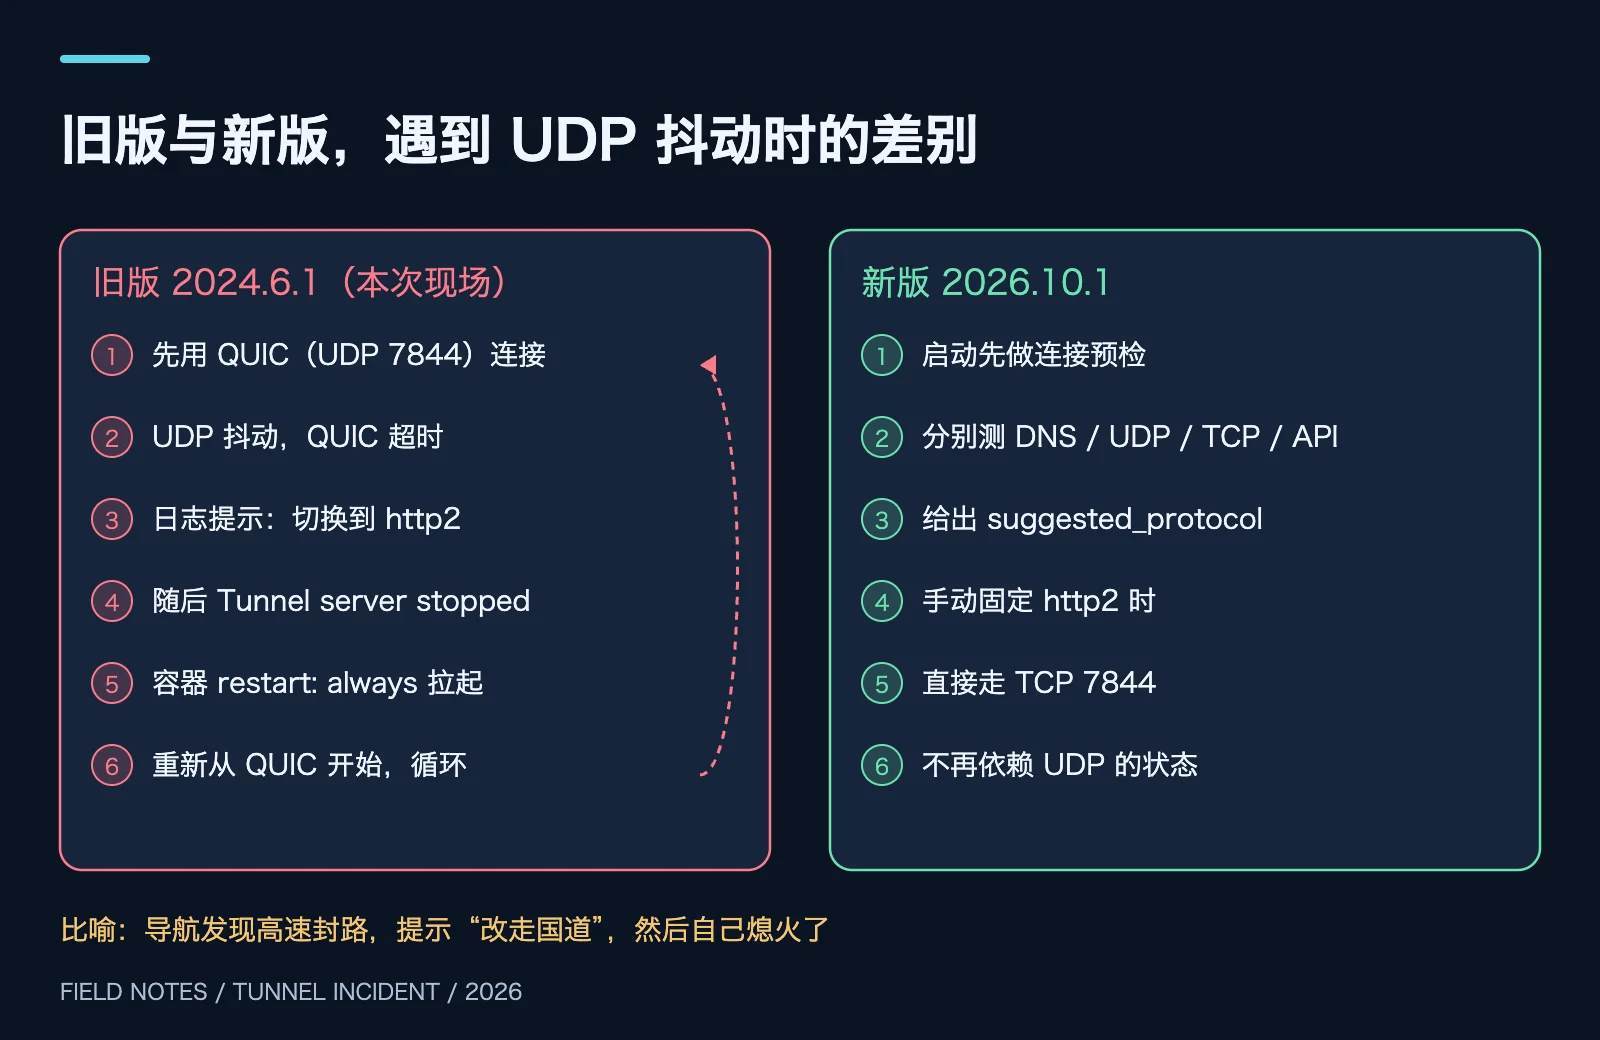
图 7:本文原创示意图。左侧步骤来自本次现场日志,右侧来自新版启动日志中的连接预检输出。
八、修复:先止血,再根治
第一步:把连接器固定到 http2
Cloudflare 的 run 参数文档里有一个 protocol 参数:可选值为 auto、http2、quic,默认 auto;auto 会先配置 quic,如果建立不了 UDP 连接,再回退到 http2。对应的环境变量是 TUNNEL_TRANSPORT_PROTOCOL。
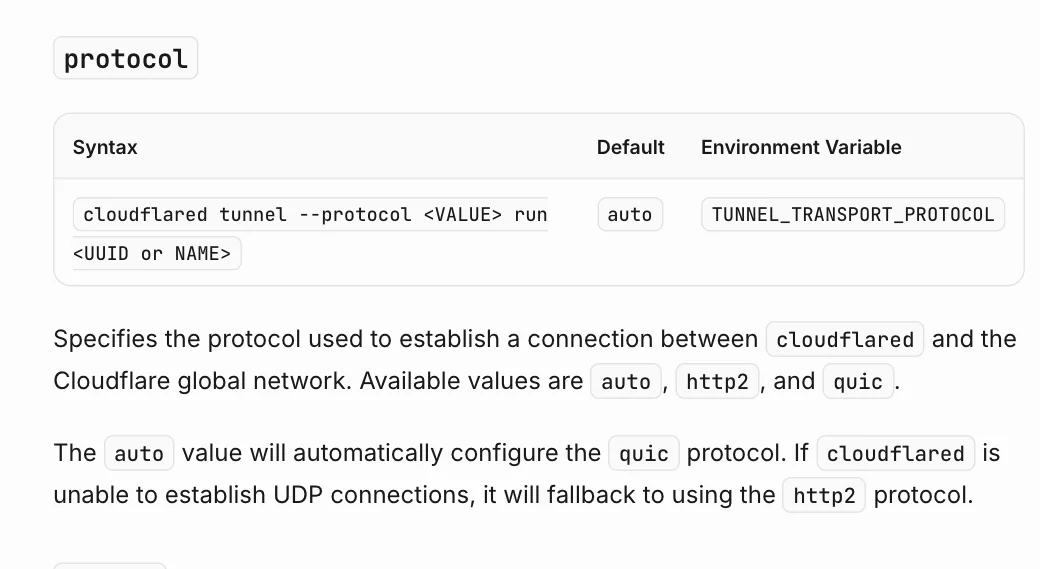
图 8:真实截图,来源 Cloudflare 官方文档 Tunnel run parameters 页面。auto 的含义就是“先试 QUIC,不行再说”。
既然 UDP 不可靠,那就别让它先试了。我在 Compose 文件的 command 里加了 –protocol http2:
services:
  cloudflared:
    image: cloudflare/cloudflared:2026.10.1
    container_name: cloudflared
    command: tunnel --no-autoupdate --protocol http2 run --token <TUNNEL_TOKEN>
    restart: always
这里有个 Portainer 用户容易踩的细节。容器标签里记录的 compose 路径是 /data/compose/编号/docker-compose.yml,那是 Portainer 容器内部的路径。宿主机上对应的是 Portainer 数据卷目录下的同名文件。要改就改这一份,否则下次在 Portainer 里重新部署这个栈,你的修改会被它自己存的版本覆盖。改之前先备份,再用同一个 project 名重建:
cp -p docker-compose.yml /root/cloudflared-compose.bak
docker compose -p cloudflared -f docker-compose.yml up -d
docker logs cloudflared 2>&1 | grep -E "Registered|protocol"
10 秒之内,4 条连接全部注册成功,日志里清一色的 protocol=http2,公网访问恢复 200,文件下载也正常。
官方排障文档的“隧道随机断开”一节,也把“用 protocol: http2 测试”列为对付 UDP 空闲超时的办法之一:
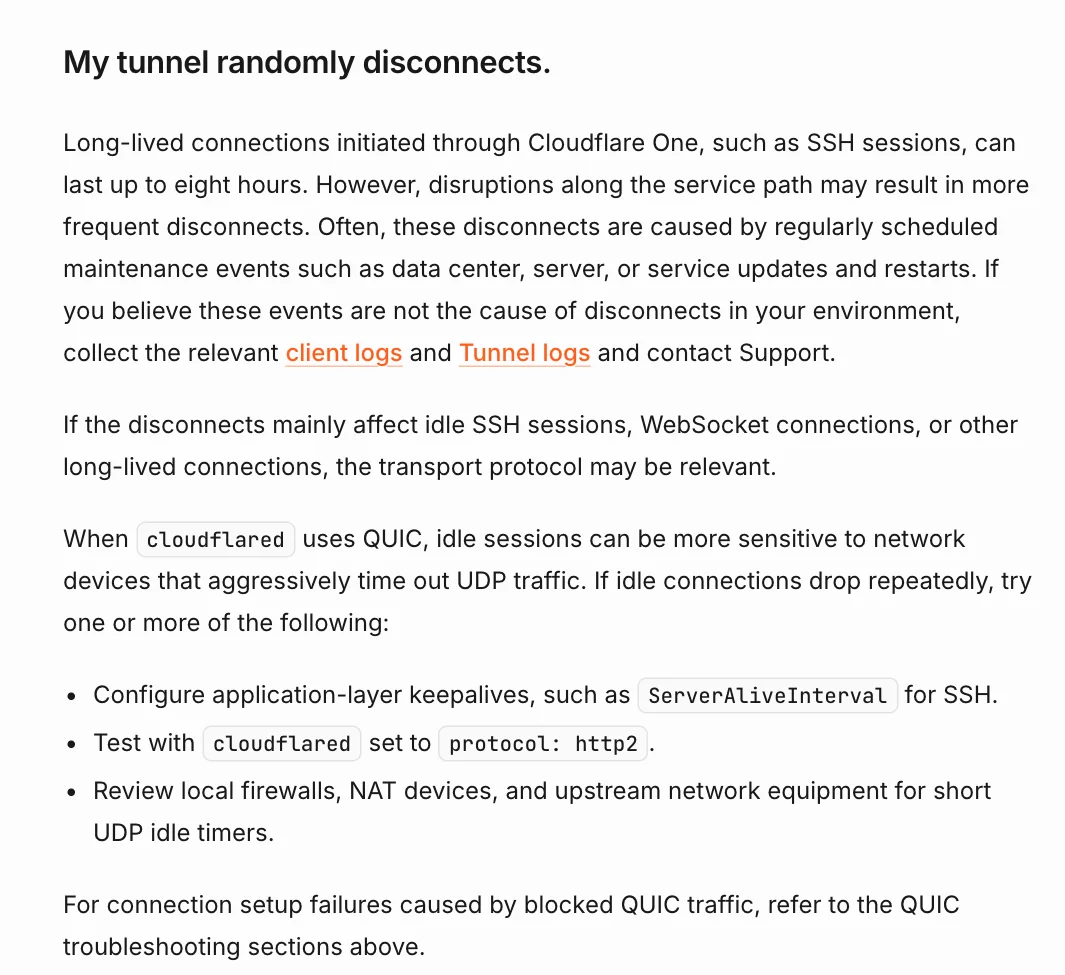
图 9:真实截图,来源 Cloudflare 官方文档 Common errors 页面。使用 QUIC 时,空闲会话对那些“积极掐断 UDP”的网络设备更敏感。
第二步:升级连接器,并且固定版本号
止血之后是根治。旧私有仓库已经不可达,新仓库在拉取某一层时返回 500,最后改用主机 Docker 已配置的镜像加速源,直接拉取 Docker Hub 上的 cloudflare/cloudflared:2026.10.1。
GitHub 上的发布页显示,2026.10.1 是写作时的最新版本:
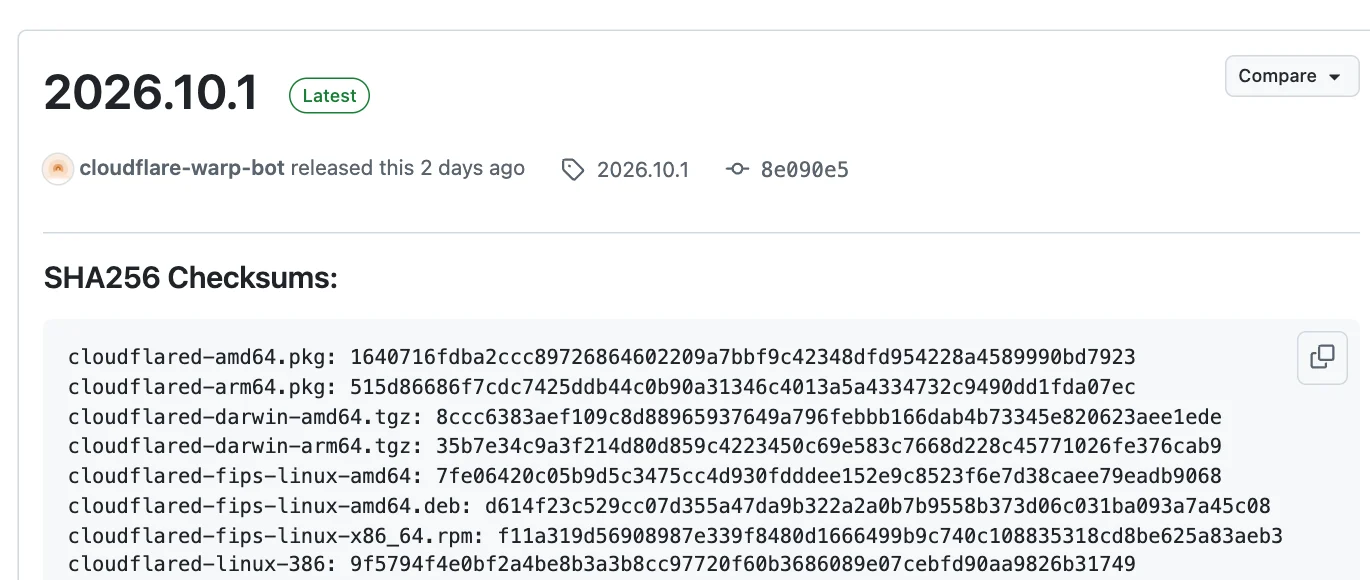
图 10:真实截图,来源 cloudflared 的 GitHub Releases 页面。页面上的 SHA256 是包内二进制文件的校验值,不是压缩包本身的,核对时别对错对象。
升级时我把 image 从 latest 改成了明确的版本号。下次想升级,改一个数字、拉取、重建,一目了然,也不会再被“永远停在某一天的 latest”坑到。
新版启动后多了一组连接预检,会分别测试 DNS 解析、UDP 连接、TCP 连接和 Cloudflare API,最后给出建议协议。因为已经固定了 http2,它的建议也是 http2。即使哪天有人把 –protocol 去掉,新版也会先测一遍再决定,不会再盲目从 QUIC 开始。
一条可以放心忽略的警告
日志里还有一行 failed to sufficiently increase receive buffer size,看起来很吓人。Cloudflare 的排障文档明确说它通常没有影响,排障时可以忽略。它来自 cloudflared 使用的 quic-go 库:库会尝试调大 UDP 缓冲区,但 Linux 默认允许的上限比较小。在高带宽场景下可以按 quic-go 文档调大 net.core.rmem_max,对这次故障没有帮助。
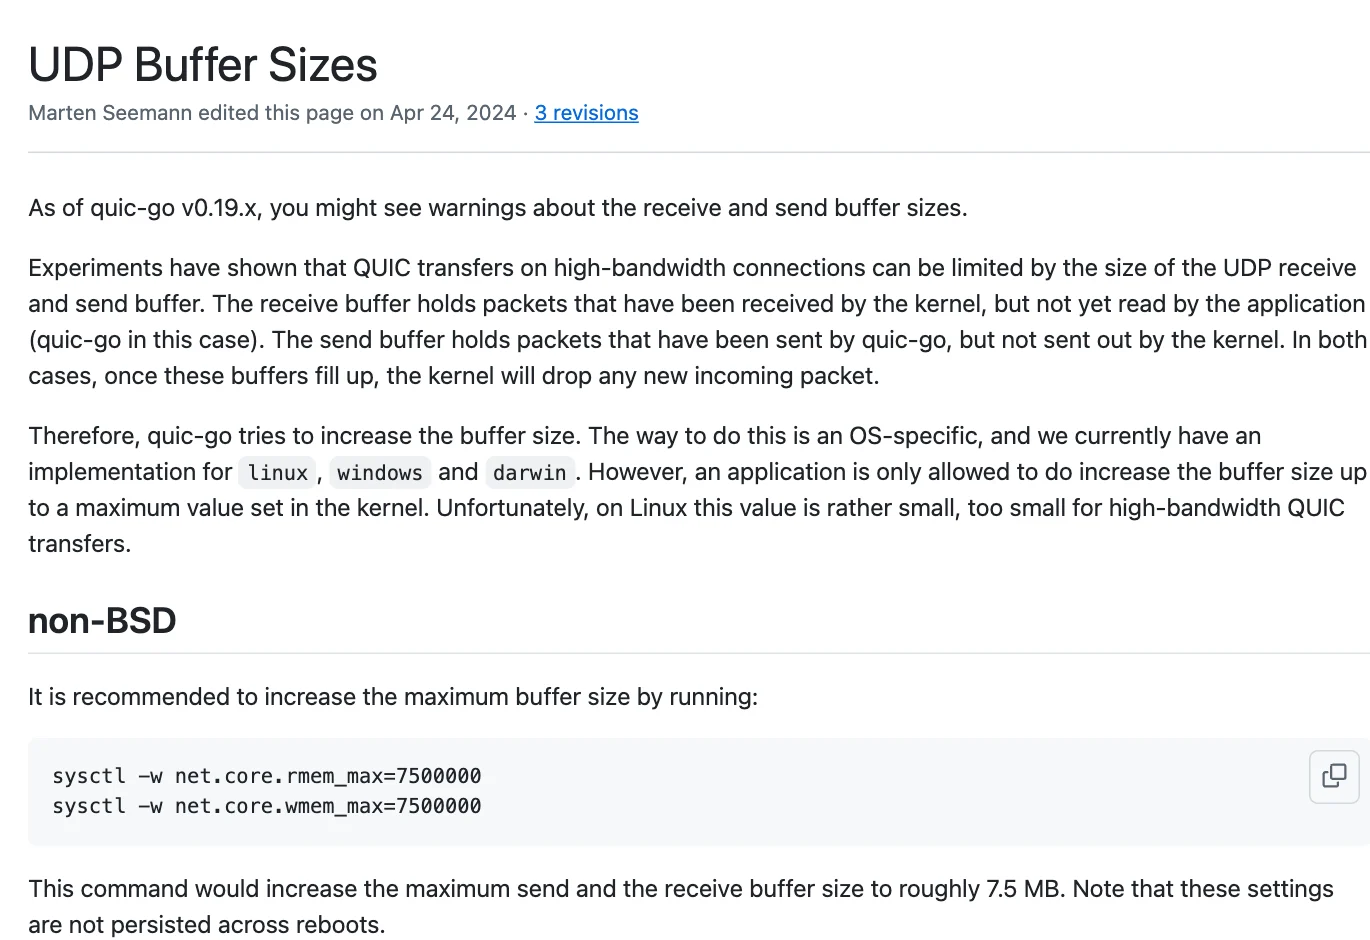
图 11:真实截图,来源 quic-go 项目 Wiki 的 UDP Buffer Sizes 页面。这行警告是性能提示,不是这次断线的原因。
九、一键脚本:先诊断,再固定 http2,失败自动回滚
为了下次不用再翻一遍日志,我把这次的排查和修复整理成了 Tunnel Doctor 下载包,包含 Windows 11、Ubuntu 26.04、macOS 27 三个入口,也可以单独查看 使用说明。三个脚本也可以分别下载:windows-11.ps1、ubuntu-26.04.sh、macos-27.command。
脚本只用系统自带工具和你已经装好的 Docker 或 cloudflared,不调用任何云端 API,不下载远程脚本,也不会读取或打印隧道 Token(日志里出现的 Token 会被替换成 <TOKEN>)。它能识别三类部署:
- Docker 和 Docker Compose 容器,包括 Portainer 栈。脚本会把 Portainer 内部的 compose 路径自动换算成宿主机路径。
- Ubuntu 上的 systemd 服务。通过 drop-in 文件设置 TUNNEL_TRANSPORT_PROTOCOL=http2,不改原始 unit。
- macOS 的 launchd 服务和 Windows 11 的系统服务。分别写入 plist 的 EnvironmentVariables 和服务注册表的 Environment 值。
方法一:人工启动,脚本自动执行
四种模式:audit 只读诊断;apply 固定 http2;upgrade 升级 compose 管理的镜像;rollback 按运行编号回滚。apply 和 upgrade 都会先备份,改完后等待日志出现 Registered tunnel connection,等不到就自动回滚。
# Windows 11:用管理员身份打开 PowerShell
powershell -NoProfile -ExecutionPolicy Bypass -File .\windows-11.ps1 -Mode Audit
powershell -NoProfile -ExecutionPolicy Bypass -File .\windows-11.ps1 -Mode Apply
powershell -NoProfile -ExecutionPolicy Bypass -File .\windows-11.ps1 -Mode Upgrade -Version 2026.10.1
powershell -NoProfile -ExecutionPolicy Bypass -File .\windows-11.ps1 -Mode Rollback -RunId RUN_ID
# Ubuntu 26.04
sudo bash ./ubuntu-26.04.sh audit
sudo bash ./ubuntu-26.04.sh apply
sudo bash ./ubuntu-26.04.sh upgrade 2026.10.1
sudo bash ./ubuntu-26.04.sh rollback RUN_ID

# macOS 27(系统级 LaunchDaemon 需要 sudo,Docker Desktop 不需要)
bash ./macos-27.command audit
bash ./macos-27.command apply
bash ./macos-27.command upgrade 2026.10.1
bash ./macos-27.command rollback RUN_ID
只想处理某一个容器或服务时,加上 –target 名称(Windows 用 -Target)。audit 的输出大致是这样:
Edge reachability (TCP 7844 is used by http2, UDP 7844 by quic):
  [OK]   TCP region1.v2.argotunnel.com:7844 reachable
Docker container: cloudflared (running restart=0)
  image: cloudflare/cloudflared:2026.10.1  version: 2026.10.1
  [OK]   transport already pinned to http2
  [WARN] token is a command-line argument, visible in ps; prefer TUNNEL_TOKEN or --token-file
  [OK]   compose file: <portainer-data>/compose/3/docker-compose.yml
  log window: registered=4 quic_failures=0 origin_errors=172
测试范围也说清楚:Ubuntu 脚本在 Ubuntu 24.04 加 Docker Compose v2 上实机跑通了诊断、两种 command 写法的固定、重复执行不改动、升级、拉取失败不改动、注册失败自动回滚和手动回滚,测试用的是独立的临时隧道,没有动生产连接器;systemd 分支没有在真实的 systemd 版 cloudflared 上执行。macOS 脚本用用户级 LaunchAgent 实机跑通了诊断、固定、幂等、自动回滚和手动回滚。Windows 脚本通过了 PowerShell 7.6 的语法解析和核心函数测试,但没有在真实 Windows 11 服务上执行,请先跑 Audit、读一遍源码再用。
方法二:交给本地 Agent 自动配置
如果你在用本地运维 Agent,把解压后的目录交给它即可,包里的 agent-prompt.txt 就是任务说明。不绑定任何一家 Agent 产品:
你已被授权检查并修复这台机器上的 Cloudflare Tunnel 连接器(cloudflared)。
1. 先阅读 README.txt 和当前系统对应的脚本源码,确认它做什么、不做什么。
2. 识别当前系统,只运行对应脚本的 audit 模式,整理结论:源站是否正常、TCP 7844 是否可达、
   连接器版本、是否已固定协议、日志里有没有 QUIC 超时。
3. 只有日志出现 QUIC/UDP 失败,或没有任何 Registered tunnel connection 时,才运行 apply。
4. apply 后确认出现 4 条 Registered tunnel connection(protocol=http2),并从公网访问一次确认不再是 530。
5. 连接器版本超过一年时,先问我要升级到哪个版本,得到回复后再运行 upgrade。
6. 失败时用脚本打印的运行编号执行 rollback,并再次 audit 核对。
约束:不要读取、打印或改写隧道 Token;不要改 Cloudflare 后台路由;不要关闭证书校验;
不要处理与 cloudflared 无关的容器或服务;报告中不要出现内网 IP、计算机名和内网域名。
十、下次遇到 530,按这个顺序查
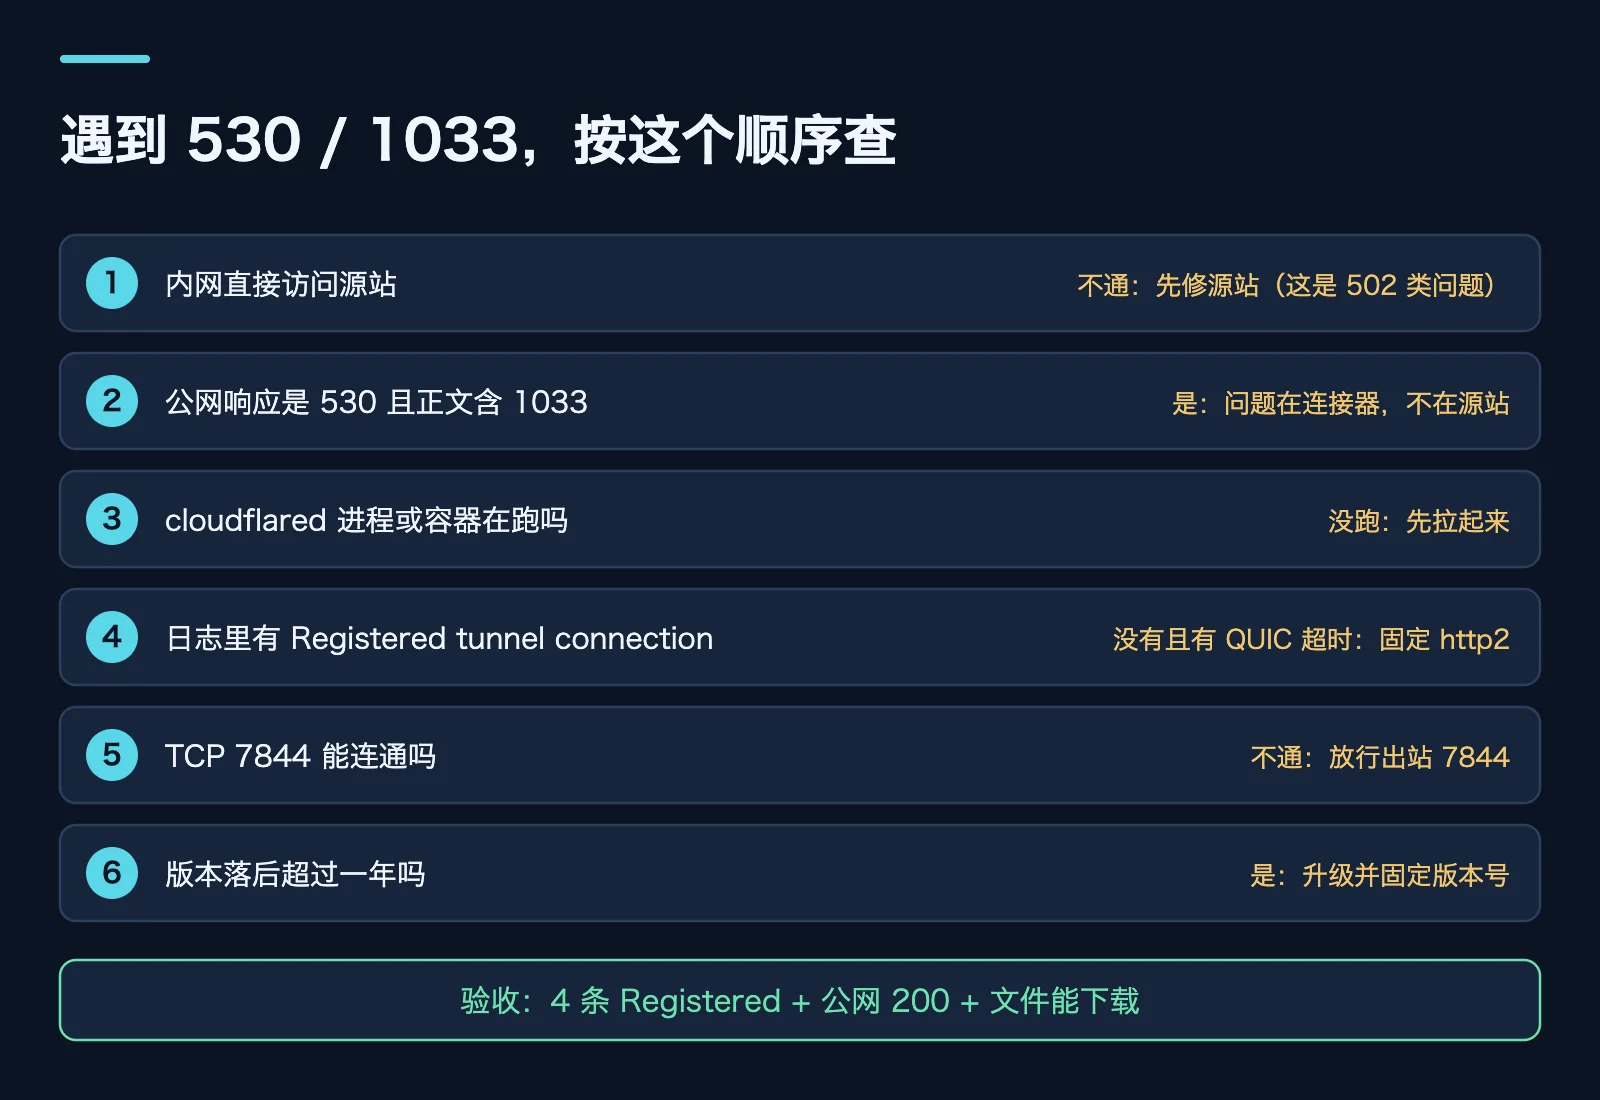
图 12:本文原创示意图。前两步只花一分钟,却能决定接下来该查源站还是查连接器。
这张清单的核心只有一句:530 加 1033,先查连接器,不查源站。连接器在跑,就看日志里有没有 Registered tunnel connection;没有、而且满屏 QUIC 超时,就固定 http2;TCP 7844 也不通,就该去放行防火墙出站了。
最后,这次排障顺带暴露了几个值得收拾的小问题:
- 隧道 Token 写在命令行参数里,在主机上用 ps 就能看到明文。新版支持 –token-file,或者用 TUNNEL_TOKEN 环境变量传入。
- 同一条隧道上还挂着一个早已下线的旧域名,源站拒绝连接,日志里不停出现扫描 .php 文件的请求。不用的路由应该在后台删掉。
- 最该补的是监控。容器 Up 不等于隧道在线,应该监控的是“公网能不能访问”,或者 cloudflared 指标里的已注册连接数。
Q&A:几个容易想歪的问题
固定 http2 会不会变慢?
对个人下载站、网页这类场景,基本感觉不到。QUIC 的优势主要在弱网和网络切换时更稳、握手更快。在 UDP 本身不稳定的网络里,能稳定连上的 http2 反而更快,毕竟连不上的 QUIC 速度是零。需要注意的是,官方文档提到 http2 不支持后量子密钥协商,对安全要求特别高的场景要自己权衡。
为什么不直接把 UDP 7844 修好,非要固定协议?
能修当然更好,但家庭网络的 UDP 抖动往往不在你的控制范围内,可能是运营商设备,也可能是上游某台网关的会话超时策略。固定 http2 是把“依赖一个不可控的条件”换成“依赖一个几乎处处成立的条件”。等你确认 UDP 稳定了,删掉这个参数就能回到 auto。
容器 restart: always,为什么没自动恢复?
因为最早那次掉线时进程没有退出。Docker 的重启策略只管进程死没死,不管它还在不在干活。后来手动重启那次倒是一直在重启,可每次都从 QUIC 开始,又在同一个地方退出。
多跑几个 cloudflared 副本能避免这种事吗?
能降低风险。Cloudflare 支持同一条隧道挂多个连接器副本,放在不同机器上,一台掉了另一台还能接住。但如果几台机器共用同一个出口,UDP 一抖,所有副本会一起受影响。副本解决单机故障,固定协议解决出口不稳,两件事最好都做。
latest 标签到底能不能用?
能用,但要明白它的含义:本地的 latest 是“你上次拉取时的最新”,不会自己更新。尤其是从私有仓库或镜像加速源拉取时,源一旦失效,latest 就永远停在那一天。生产环境建议写死版本号,升级时主动改。
1033 一定是连接器的问题吗?
绝大多数情况是。官方文档也提到一个例外:如果隧道显示 Active,还要检查 DNS 记录是否指向正确的隧道地址。FedRAMP High 账户如果用了普通的 cfargotunnel.com 子域,即使隧道健康也会返回 1033。普通个人账户一般不会遇到。
参考资料与配图来源
本文 7 张真实截图均由浏览器打开官方原文后截取、裁切,含有完整 IP 地址的表格已经裁掉;其余 5 张为本文原创示意图,提供中英文两个版本。日志内容来自现场,隧道 ID、Token 和内网地址已经脱敏。
- Cloudflare Docs:Error 530
- Cloudflare Docs:Error 1033
- Cloudflare Docs:Tunnel with firewall
- Cloudflare Docs:Tunnel run parameters
- Cloudflare Docs:Common errors
- quic-go Wiki:UDP Buffer Sizes
- cloudflared GitHub Releases
相关旧文:用 Cloudflare Tunnel 把内网服务变成公网 HTTPS、SmartDNS 与 AdGuard Home 的三层陷阱。这两次排障都在提醒同一件事:看到一个绿色的“正常”之后,再沿着真实请求走一遍。