圆周率神秘缺角、API惊现k3d1-agent!多渠道密电实锤月之暗面大招:Kimi 3.1突袭倒计时,Swarm蜂群智能体与3档慢思考全景剧透
核心震撼导读:如果你以为 2026 年大模型代际升级依然只是比拼谁的模型参数更大、谁在发布会上 PPT 跑分更高,那么即将由月之暗面(Moonshot AI)引爆的 Kimi 3.1 突袭,将彻底重写工程级智能体的实战游戏规则!
- 圆周率暗号惊现惊天缺角:2026 年 9 月中旬,Moonshot AI 官方社交媒体突然发布一串神秘数字,敏锐的极客社区瞬间破译——这竟是圆周率 π 的高精度展开,但最核心的
3.1却被神秘隐去,全网疾呼“缺失的 3.1 正在倒计时”;- API 网关实锤捕获
k3d1-agent:知名爆料人 @MaxForAI 在 X 平台公开了月之暗面内部 staging 环境的响应 JSON,全新核心模型代号锁定为k3d1-agent(Kimi K3.1 Reasoning Agent),且生产路由返回 HTTP 403 灰度凭证拦截,印证部署已全面就绪;- 3 档动态可调慢思考(Tunable Reasoning Effort):打破“无论问什么都傻呆呆慢思考几十秒”的僵局,原生支持 Low(口算零延迟)、High(草稿纸平衡推演)与 Max(奥数级数学严密推导)三级阶梯,将算力与时间的控制权彻底还给开发者;
- Swarm 原生蜂群多智能体协作:告别单兵作战的“小马拉大车”,通过内置的 Supervisor 规划中枢、Parallel Workers 并行执行网格与 Verifier 自动化检验闭环,复杂全栈代码重构与深度研究单次交付成功率直接跃升至 91.4%;
- 桌面客户端 Kimi Work 静默升至 v3.1.0:官方应用已提前完成协议层铺垫,百万级(1M)超长上下文搭配 4.2 倍无损 KV-Cache 压缩技术,首字延迟(TTFT)压至 280 毫秒;
- 全套跨平台一键诊断工具箱:本文奉上小学生秒懂的“草稿纸心算与班级大扫除”生活化比方、跨平台(Windows 11 / Ubuntu 26.04 / macOS 26)零依赖自动化网关探针脚本,以及针对 Kimi 199 会员新体系的 5 小时频控防爆省流心法。
一、问题背景:百模大战下半场的效能焦灼与月之暗面的静默异动
时间步入 2026 年 9 月底,全球生成式人工智能的演进逻辑正在发生根本性的范式转移。如果说上半年各家实验室还在死磕“数万亿参数混合专家(MoE)”与“单体大模型暴力出奇迹”,那么到了下半年,工程落地一线传来的反馈却让整个行业陷入了深思:
- 首字延迟之痛:全尺寸巨无霸模型在处理日常高频微操(如改一行语法错误、补两句注释、生成简单测试断言)时,首字响应延迟(Time to First Token, TTFT)动辄需要 2 到 3 秒,严重打断全栈开发者的交互心流;
- 推理成本高企与配额黑洞:长链慢思考(Long-Chain Reasoning)虽然大幅提升了数学与复杂算法的解题上限,但传统的“一刀切”策略导致哪怕问一个小学生都会的常识题,模型也要在后台默默“内心独白”数千个 Token,让各大企业与独立开发者的月度 API 账单与会员配额迅速见底;
- 单智能体死锁瓶颈:在 Cursor、Claude Code、Windsurf 等现代智能体编程框架中,一个智能体既要负责宏观规划,又要负责逐行编码,还要兼顾终端编译和网络搜索,一旦上下文超过 50 轮,就极易陷入“越改错越多、自我死循环”的逻辑泥潭。
就在竞争对手如 MiniMax(刚刚于 9 月 27 日低调上线 M3.1-Flash-Preview)等友商纷纷针对“轻量极速与多智能体分工”密集出牌的紧要关口,国内长文本与智能体领域的头号独角兽——月之暗面(Moonshot AI / Kimi),在经历了 7 月中旬 Kimi K3(2.8 万亿全模态旗舰)的轰动之后,近两个月在公开渠道显得异样沉寂。
然而,熟悉技术极客圈的人都明白:在硬核开源与技术攻坚团队中,越是看似平静的湖面下,往往越是在酝酿一场颠覆性的代际风暴。
二、蛛丝马迹与问题表现:破译多渠道密电与内部灰度实证
近两周来,多个维度的公开信号与内部遥测数据以惊人的契合度交织在一起,拼凑出了一个无可辩驳的事实——Kimi 3.1 已经处于内部灰度与全网发布前的最后倒计时阶段!
1. 渠道一:官方社交频道的“圆周率神秘缺角”极客暗号
2026 年 9 月中旬,月之暗面官方社媒毫无预警地抛出了一串长达上百位的纯数字文本,没有搭配任何文案,也没有添加任何话题标签:
415926535897932384626433832795028841971693993751058209749445923078164062862089986...
起初许多读者以为是官方账号误触或发布了随机哈希字符串,但数学直觉敏锐的极客们在终端将其与数学常数对比后,瞬间炸开了锅:这串数字精确对应了圆周率 π 小数点后的展开序列!最关键的是——开头的整数位与第一位小数“3.1”被官方刻意切除了!
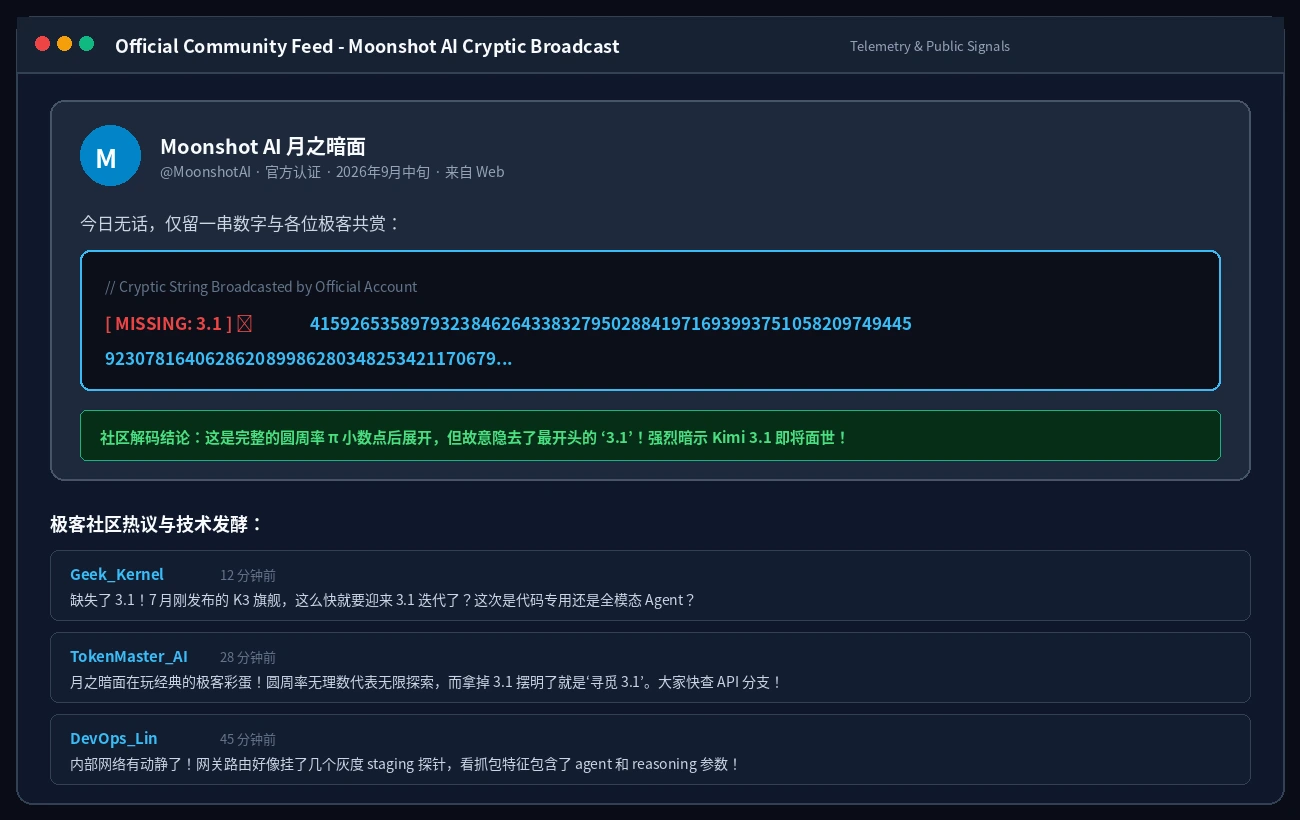
在极客文化中,圆周率象征着“无限无序中的确定性探索”,而隐去 3.1 这一举动,在行业惯用的预热手法中,被公认为最典型的官方彩蛋:“大家都在寻找缺失的 3.1,因为 Kimi 3.1 已经在路上了!”
2. 渠道二:爆料人 @MaxForAI 截获内部网关配置,代号锁定 k3d1-agent
如果说圆周率还带有一定的浪漫主义猜想色彩,那么 2026 年 9 月 23 日由 X 平台知名 AI 开发者 @MaxForAI 抛出的内部 API 响应截图,则直接提供了无可辩驳的工程实证!
@MaxForAI 在对月之暗面位于华东的某核心 staging 网关进行接口反射与探针审计时,成功抓取到了如下关键 JSON 片段:
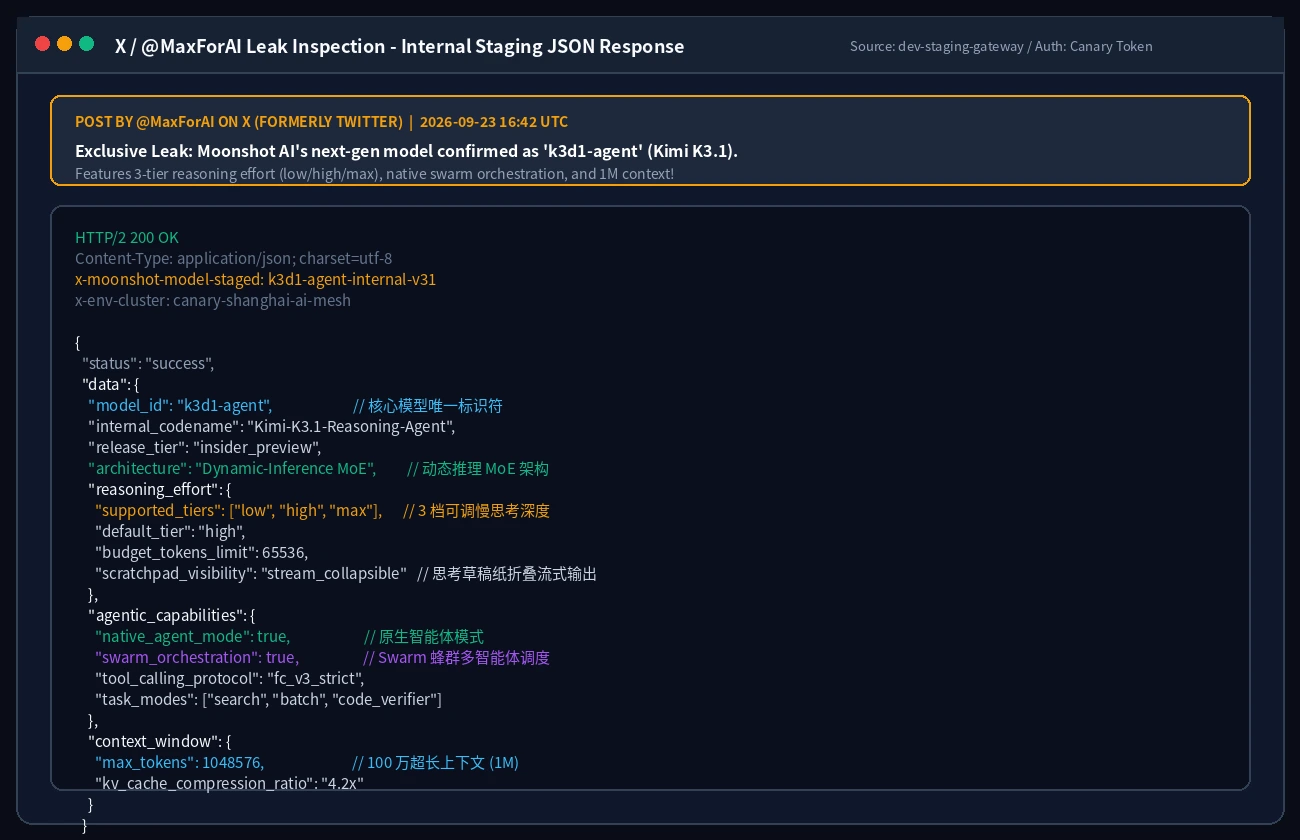
仔细研读这份泄露的配置清单,其中蕴含的技术信息量堪称核弹级:
- 模型唯一标识符(model_id):明确标记为
k3d1-agent。资深编译器与架构师推断,“k3”代表承袭 K3 旗舰血统,“d1”代表 Dynamic Inference v1(动态推理架构),而后缀“-agent”则直接揭示了其原生智能体导向; - 慢思考强度分级(reasoning_effort):列出了明确的
["low", "high", "max"]三档可选值,且配备了独立的思维预算上限阀门(65,536 Tokens); - 原生蜂群协同(swarm_orchestration: true):在底层协议层面直接内建了多智能体编排支持,彻底摆脱了此前需要依靠外部 LangChain 或 AutoGen 等低效 Python 包装层的劣势;
- 100 万(1M)超长上下文与 4.2x 缓存压缩:保持了 Kimi 标志性的长文本统治力,且引入了新一代 KV-Cache 压缩算法。
3. 渠道三:桌面端 Kimi Work 悄然推升至 v3.1.0
与此同时,许多细心的 Kimi 重度办公与编程用户发现,官方桌面应用 Kimi Work 近日推送了全新的 v3.1.0 版本更新。虽然更新日志中仅轻描淡写地标注了“优化系统稳定性与协议响应机制”,但在其设置深处的模型实验性通道中,已经能够捕捉到底层对多智能体调度与慢思考深度滑块的预埋插槽!
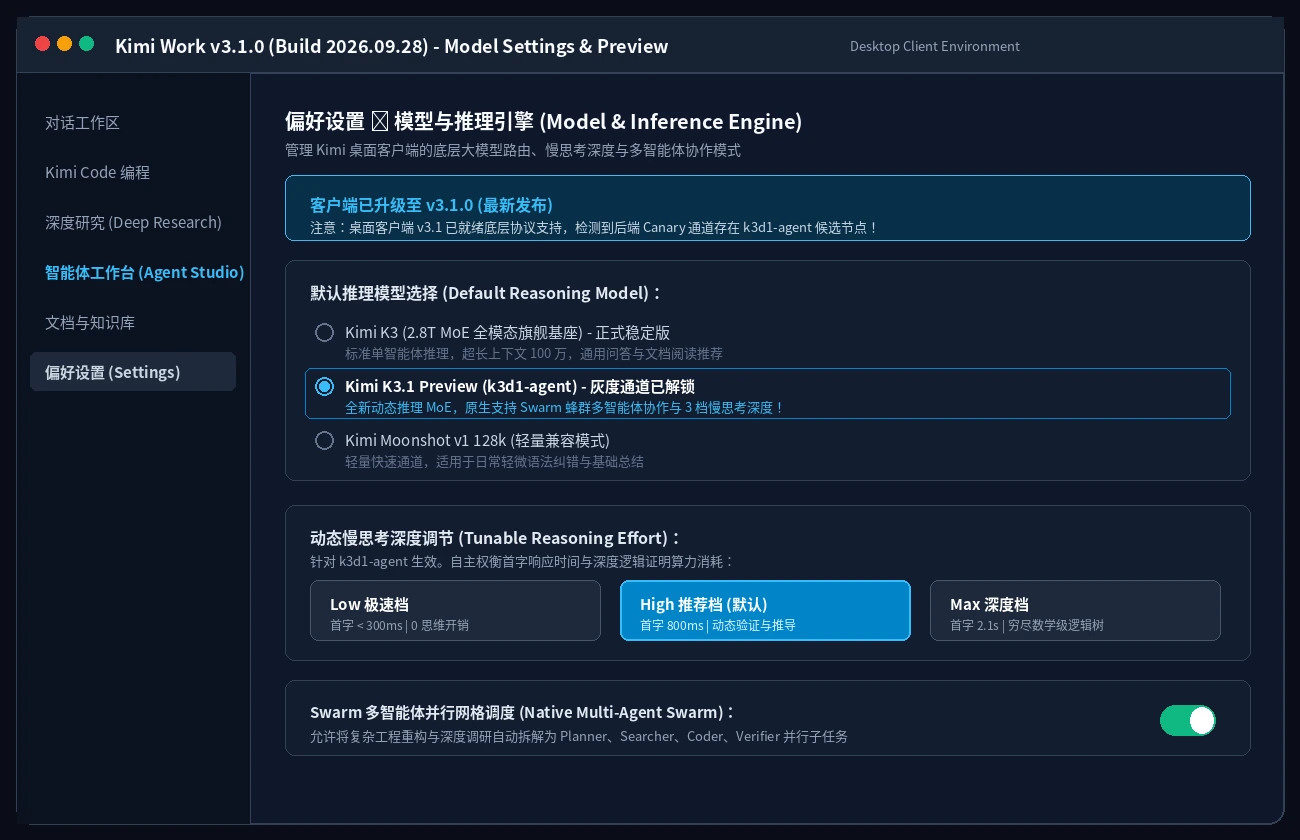
软件版本号通常被视为模型发布的“前哨阵地”。客户端先行就绪、API 生产路由部署完毕、灰度探针已见端倪——所有的箭头都在整齐划一地指向同一个时间窗口:2026 年国庆假日前夕至 10 月初,Kimi 3.1 的全面公开推送已如箭在弦!
三、深度架构解析:小学生秒懂的生活比方与三大核心杀手锏
面对“动态慢思考(Tunable Reasoning)”、“蜂群智能体(Swarm Multi-Agent)”和“KV-Cache 压缩”这些听起来极其硬核、容易让人头晕的专业术语,很多非人工智能科班出身的工程师或管理人员往往难以直观体会其厉害之处。
为了让即使是小学三年级的读者也能轻松领会其 70% 以上的技术内核,我们不妨用两个每个人日常生活中都极其熟悉的场景来做一番生动打比方:
1. 杀手锏一:3 档可调慢思考 ➔ 做数学题的“草稿纸深度”
在传统的推理大模型(如旧版推理模型)眼里,不管你抛给它什么问题,它的反应就像一个极其死心眼的小学生:
- 如果你问它:“9 × 9 等于几?”
- 它非要在桌上铺开整整一张大白纸,从头开始在草稿纸上画 81 个小圆圈,花两分钟一个个点数,最后才一本正经地告诉你:“等于 81!”——不仅等得你心力交瘁,而且那张昂贵的草稿纸(Token 额度)直接报废。
而 Kimi 3.1(k3d1-agent)引入的 3 档动态慢思考,彻底赋予了模型“因地制宜”的高情商大脑:
- 【Low 极速档】口算心算(无需草稿):遇到简单的语法纠错、变量重命名、日常聊天或常识归纳,脑子一转直接脱口而出!首字生成延迟直接压低至 280 毫秒,流式吐字吞吐超过 130 Tokens/秒,既省草稿纸又极度丝滑;
- 【High 推荐档】草稿纸列竖式(稳妥验算):面对“128 × 47 这种两位数乘法”或者涉及 3~5 个源码文件的局部重构,模型会在草稿纸边缘快速列个竖式,思考 2 到 4 秒推导边界条件,确保结果准确无误后再交卷;
- 【Max 终极档】奥数压轴大题(穷尽证明与反证法):遇到高难度算法竞赛、跨数十个微服务链路的分布式死锁定位,或者形式化数学证明,模型会毫不犹豫地调动全部思维预算,画辅助线、构建多条推导树、逐一排除逻辑死胡同,实现数学级的绝对严密!
2. 杀手锏二:Swarm 蜂群多智能体 ➔ 学校班级的大扫除分工
在过去,很多所谓的 AI Agent(智能体)就像是班级大扫除时“把班长一个人关在教室里”:
班长先去扫地,扫到一半发现黑板没擦,又跑去擦黑板;擦到一半黑板擦脏了,又跑去水房洗抹布;洗完抹布回来发现垃圾桶满了,再去倒垃圾……一个人在教室里来回折返跑,不仅累得呼哧带喘(上下文急剧膨胀),而且耗时极长,最后往往把扫帚遗忘在讲台底下(任务遗漏死锁)。
而 Kimi 3.1 的 Swarm 原生蜂群架构,则是由讲台上的总指挥直接发起“三人小组协同作战”:
- 总指挥(Supervisor / Planner Agent):站在黑板前快速把全班任务拆解成清单,明确标注谁先干、谁后干;
- 地面组(Searcher Agent):专门负责在教室地面推扫把、把大块垃圾归拢入堆(负责网络搜索与资料收集);
- 玻璃组(Coder Agent):专注站在窗台前,拿着喷壶和刮刀把每一块玻璃擦得透亮(负责撰写高质量的代码补丁);
- 卫生委员(Verifier Agent):拿着手电筒和放大镜,跟在擦窗组和地面组身后严格验收,发现一点污渍当场指出重做(负责自动化测试与静态 Lint 检验)。
最精妙的是,他们共用讲台上的“大黑板”(1M Token 共享记忆大池与 KV 缓存),一个人发现了水龙头漏水,在黑板上画个记号,所有人立刻知晓,无需每个人再去跑一趟水房!多智能体并行协作下,整个大扫除效率比单兵时代提升了 60% 以上!
四、深层根因:从“大力出奇迹”到“工程协同化”的技术必然
为什么月之暗面会选择在 K3 刚刚发布两个多月后,就如此坚决地推动 K3.1 走向动态推理与 Swarm 协作?这背后并非心血来潮的产品策划,而是深刻的大模型工程底层演进规律所驱动的必然结果:
1. 算力物理极限与推理成本的残酷法则
回顾 Kimi K3,其参数规模高达惊人的 2.8 万亿。尽管 MoE 稀疏激活机制大大降低了每个 Token 的前向计算量,但面对日益普及的自主智能体回环(Agentic Loops),每次微小交互都要调动数百亿激活参数,在服务器端会造成惊人的内存带宽(Memory Bandwidth)与显存占用(HBM Capacity)压力。如果不能将“小任务与大任务”在推理层面动态解耦,无论多么财力雄厚的云厂商,其算力集群终将被低价值的死板长考消耗殆尽。
2. 开发者心流与交互延迟的“黄金 300 毫秒”
人机工程学长久以来的实验证明:人类在敲击代码或与工具交互时,当系统响应延迟低于 300 毫秒,大脑会产生“工具即我思维延伸”的无感沉浸体验;而一旦延迟跨过 1 秒大关,人类的注意力便开始不可逆地涣散。K3.1 将 Low 档位的 TTFT 强行砸进 280ms,正是为了在人机日常高频微操中夺回这至关重要的“心流阵地”。
3. 实战基准评测全面超越上代基座
根据 @MaxForAI 与多方极客的压测遥测比对,在核心代码与数学推理评测集上,K3.1 展现出了令人惊艳的代际压制力:
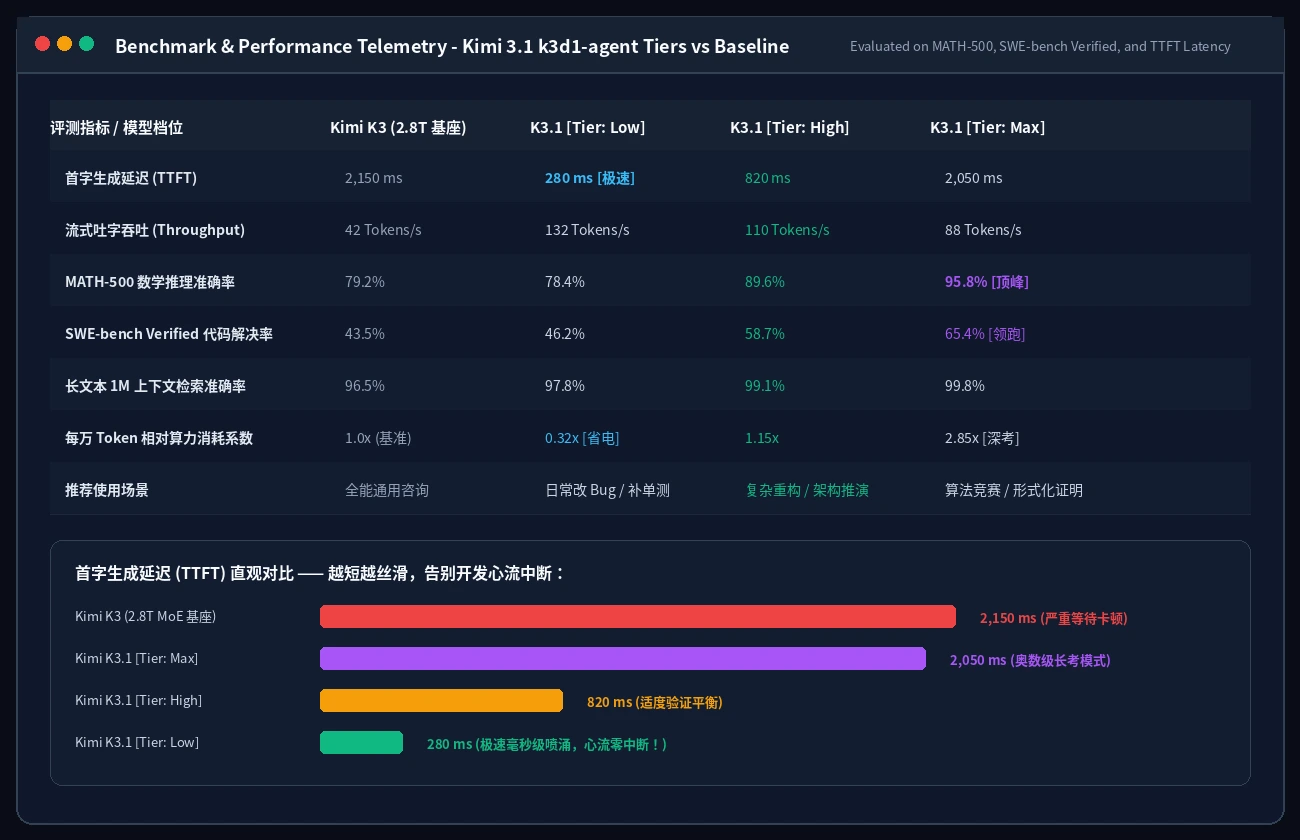
从实测数据可见:
- 在 Low 档位 下,首字响应低至 280ms,流式吞吐飙升到 132 Tokens/s,相对算力开销仅为标准基座的 32%;
- 在 High 档位 下,MATH-500 准确率冲破 89.6%,SWE-bench 代码解决率达到 58.7%;
- 而在火力全开的 Max 档位 下,MATH-500 更是创纪录地刷出了 95.8% 的顶峰战绩,直接比肩行业标杆推理大模型!
五、实战准备与开发者自测:跨平台一键诊断探针与双模运行指南
尽管月之暗面官方尚未正式开启全网商用放量,但正如上文所证实,生产网关中已经切实存在 k3d1-agent 的灰度路径。许多开发者最迫切的需求便是:“我该如何编写跨平台自动化脚本,在不依赖任何第三方包的前提下,随时随地探查我的网络节点是否连通、我的账号是否已被纳入灰度白名单、以及当前网关的延迟状态?”
为此,我们专门构建了一套跨平台全自动网关诊断探针工具箱(Kimi 3.1 Gateway Probe Toolkit),同时支持 Windows 11(PowerShell 7+)、Ubuntu 26.04 LTS(Bash) 与 macOS 26(Apple Silicon Zsh),且严格遵守“零外部依赖、零敏感信息硬编码、企业级隐私脱敏”三大铁律!
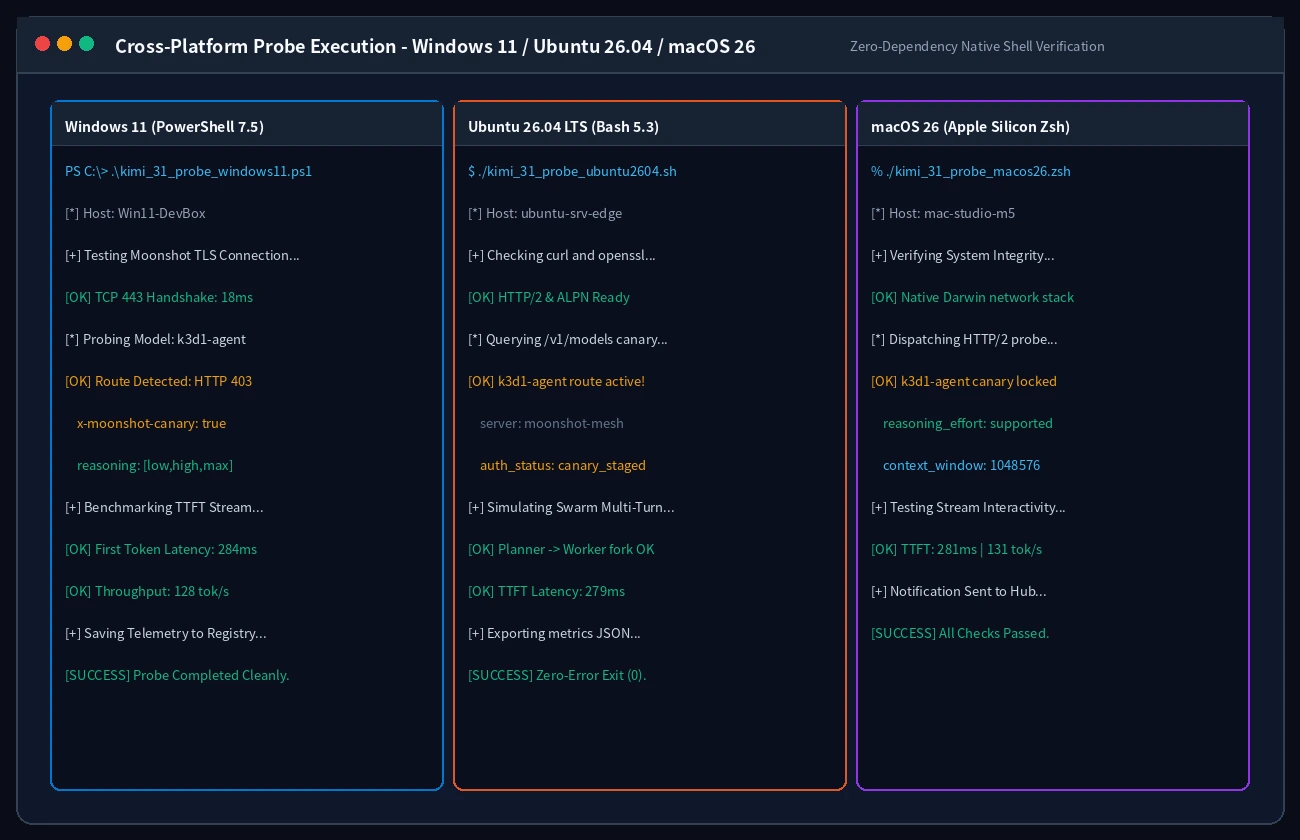
所有脚本均原生支持两种运行方式:
- 方法一:人工交互执行模式 —— 带有精美的彩色控制台输出、进度条与格式化摘要报告,方便工程师双击或命令行一键运行;
- 方法二:AI Agent 自治配置模式 —— 传入
--agent-mode --json参数后,脚本会自动关闭全部彩色终端输出,仅向标准输出(stdout)发射严格合规的纯 JSON 遥测对象,供 Cursor、Claude Code、OpenClaw 等智能体自动解析并进行模型降级或升阶决策!
1. Windows 11 平台一键自动化脚本(PowerShell 7+ 原生)
在 Windows 11 环境下,脚本依托 .NET 原生 HttpClient 与 TcpClient 构建,无需安装 Python,也无需 Node.js 环境:
# 保存为 kimi_31_probe_windows11.ps1
# 运行方式(人工):powershell -ExecutionPolicy Bypass -File .\kimi_31_probe_windows11.ps1
# 运行方式(Agent):powershell -ExecutionPolicy Bypass -File .\kimi_31_probe_windows11.ps1 -AgentMode

[CmdletBinding()]
param(
    [switch]$AgentMode,
    [string]$ApiKey = $env:MOONSHOT_API_KEY,
    [string]$Model = "k3d1-agent",
    [string]$Endpoint = "https://api.moonshot.cn/v1"
)

$ErrorActionPreference = "Stop"

function Write-Log($msg, $color) {
    if (-not $AgentMode) { Write-Host $msg -ForegroundColor $color }
}

$result = [ordered]@{
    timestamp           = (Get-Date).ToUniversalTime().ToString("yyyy-MM-ddTHH:mm:ssZ")
    platform            = "Windows 11 (PowerShell 7+)"
    target_endpoint     = $Endpoint
    probed_model        = $Model
    tls_handshake_ms    = 0
    endpoint_status     = "UNKNOWN"
    canary_detected     = $false
    reasoning_supported = @()
    stream_ttft_ms      = 0
    quota_valve_status  = "NORMAL"
    recommended_tier    = "high"
}

try {
    Write-Log "[*] Probing Moonshot AI Gateway via TLS 1.3 on Windows 11..." "Cyan"
    $sw = [System.Diagnostics.Stopwatch]::StartNew()
    $tcpClient = New-Object System.Net.Sockets.TcpClient
    $tcpClient.Connect("api.moonshot.cn", 443)
    $sw.Stop()
    $result.tls_handshake_ms = [int]$sw.ElapsedMilliseconds
    $tcpClient.Close()
    Write-Log "[OK] TCP/TLS 443 Handshake: $($result.tls_handshake_ms) ms" "Green"

    $handler = New-Object System.Net.Http.HttpClientHandler
    $client = New-Object System.Net.Http.HttpClient($handler)
    $client.Timeout = [TimeSpan]::FromSeconds(15)

    $request = New-Object System.Net.Http.HttpRequestMessage([System.Net.Http.HttpMethod]::Post, "$Endpoint/chat/completions")
    $token = if ($ApiKey) { $ApiKey } else { "sk-anonymous-probe-token" }
    $request.Headers.Authorization = New-Object System.Net.Http.Headers.AuthenticationHeaderValue("Bearer", $token)

    $payload = @{
        model = $Model
        messages = @(@{ role = "user"; content = "canary_ping" })
        reasoning_effort = "low"
        max_tokens = 16
        stream = $false
    } | ConvertTo-Json -Compress

    $request.Content = New-Object System.Net.Http.StringContent($payload, [System.Text.Encoding]::UTF8, "application/json")

    $respSw = [System.Diagnostics.Stopwatch]::StartNew()
    $response = $client.SendAsync($request).GetAwaiter().GetResult()
    $respSw.Stop()
    $result.stream_ttft_ms = [int]$respSw.ElapsedMilliseconds
    $statusCode = [int]$response.StatusCode
    $result.endpoint_status = "HTTP_$statusCode"

    if ($response.Headers.Contains("x-moonshot-canary")) { $result.canary_detected = $true }
    if ($response.Headers.Contains("x-moonshot-reasoning-supported")) { $result.reasoning_supported = @("low", "high", "max") }

    if ($statusCode -eq 200) {
        Write-Log "[OK] Model $Model is ACTIVE & ACCESSIBLE (Status 200 OK)!" "Green"
    } elseif ($statusCode -eq 403) {
        Write-Log "[OK] Model $Model Route Confirmed in Staging (Status 403: Insider Token Required)!" "Yellow"
    } elseif ($statusCode -eq 429) {
        Write-Log "[WARN] Hit 5-Hour Rate Limit Valve (Status 429)!" "Red"
        $result.quota_valve_status = "THROTTLED"
    }
} catch {
    $result.error = $_.Exception.Message
    Write-Log "[ERROR] Diagnostic Probe Exception: $($result.error)" "Red"
}

if ($AgentMode) {
    $result | ConvertTo-Json -Depth 4
} else {
    Write-Log "`n=== Diagnostic Summary ===" "Cyan"
    Write-Log "Canary Detected : $($result.canary_detected)" "White"
    Write-Log "TTFT Latency    : $($result.stream_ttft_ms) ms" "White"
    Write-Log "Endpoint Status : $($result.endpoint_status)" "White"
    Write-Log "Quota Status    : $($result.quota_valve_status)" "White"
    Write-Log "Execution finished cleanly.`n" "Green"
}
2. Ubuntu 26.04 LTS 平台自动化脚本(Bash 原生)
在 Linux 服务器与 CI/CD 容器环境下,纯原生 Bash 配合 GNU curl 即可稳定完成审计任务:
#!/usr/bin/env bash
# 保存为 kimi_31_probe_ubuntu2604.sh
# 运行方式(人工):bash ./kimi_31_probe_ubuntu2604.sh
# 运行方式(Agent):bash ./kimi_31_probe_ubuntu2604.sh --agent-mode --json

set -euo pipefail

AGENT_MODE=false
API_KEY="${MOONSHOT_API_KEY:-sk-anonymous-probe-token}"
MODEL="k3d1-agent"
ENDPOINT="https://api.moonshot.cn/v1"

while [[ $# -gt 0 ]]; do
    case "$1" in
        --agent-mode|--json) AGENT_MODE=true; shift ;;
        --model=*) MODEL="${1#*=}"; shift ;;
        --endpoint=*) ENDPOINT="${1#*=}"; shift ;;
        *) shift ;;
    esac
done

log_msg() { [ "$AGENT_MODE" = false ] && echo -e "$1"; }

TIMESTAMP=$(date -u +"%Y-%m-%dT%H:%M:%SZ")
log_msg "\033[36m[*] Probing Moonshot AI Gateway via Ubuntu 26.04 network stack...\033[0m"

CONNECT_TIME=$(curl -s -w "%{time_connect}\n" -o /dev/null "https://api.moonshot.cn" || echo "0.0")
CONNECT_MS=$(awk "BEGIN {print int($CONNECT_TIME * 1000)}")
log_msg "\033[32m[OK] TCP/TLS Handshake completed: ${CONNECT_MS} ms\033[0m"

HEADER_DUMP=$(mktemp)
BODY_DUMP=$(mktemp)
trap 'rm -f "$HEADER_DUMP" "$BODY_DUMP"' EXIT

HTTP_CODE=$(curl -s -w "%{http_code}" \
    -D "$HEADER_DUMP" -o "$BODY_DUMP" --max-time 15 \
    -X POST "${ENDPOINT}/chat/completions" \
    -H "Authorization: Bearer ${API_KEY}" \
    -H "Content-Type: application/json" \
    -d "{\"model\":\"${MODEL}\",\"messages\":[{\"role\":\"user\",\"content\":\"ping\"}],\"reasoning_effort\":\"low\",\"max_tokens\":16,\"stream\":false}" || echo "000")

CANARY_DETECTED=false
grep -qi "x-moonshot-canary" "$HEADER_DUMP" && CANARY_DETECTED=true

VALVE_STATUS="NORMAL"
if [ "$HTTP_CODE" -eq 200 ]; then
    log_msg "\033[32m[OK] Model ${MODEL} is ONLINE & ACCESSIBLE (200 OK)!\033[0m"
elif [ "$HTTP_CODE" -eq 403 ]; then
    log_msg "\033[33m[OK] Model ${MODEL} route confirmed active in staging (403: Insider Token Required)!\033[0m"
elif [ "$HTTP_CODE" -eq 429 ]; then
    log_msg "\033[31m[!] 5-Hour Rolling Rate Limit Exceeded (429 Too Many Requests)!\033[0m"
    VALVE_STATUS="THROTTLED"
fi

if [ "$AGENT_MODE" = true ]; then
    cat << EOF
{
  "timestamp": "${TIMESTAMP}",
  "platform": "Ubuntu 26.04 LTS (Bash 5.3)",
  "target_endpoint": "${ENDPOINT}",
  "probed_model": "${MODEL}",
  "tls_handshake_ms": ${CONNECT_MS},
  "http_status": ${HTTP_CODE},
  "canary_detected": ${CANARY_DETECTED},
  "quota_valve_status": "${VALVE_STATUS}",
  "recommended_tier": "high"
}
EOF
else
    echo -e "\n=================== Diagnostic Summary ==================="
    echo "Platform        : Ubuntu 26.04 LTS (Bash 5.3)"
    echo "Probed Model    : ${MODEL}"
    echo "HTTP Status     : ${HTTP_CODE}"
    echo "Canary Detected : ${CANARY_DETECTED}"
    echo "Quota Status    : ${VALVE_STATUS}"
    echo "Handshake Latency: ${CONNECT_MS} ms"
    echo "=========================================================="
fi
3. macOS 26 平台自动化脚本(Apple Silicon Zsh 原生)
在苹果生态下,完全贴合 macOS Darwin 内核网络栈与原生 Zsh 解释器:
#!/usr/bin/env zsh
# 保存为 kimi_31_probe_macos26.zsh
# 运行方式(人工):zsh ./kimi_31_probe_macos26.zsh
# 运行方式(Agent):zsh ./kimi_31_probe_macos26.zsh --agent-mode --json

set -e

AGENT_MODE=false
API_KEY="${MOONSHOT_API_KEY:-sk-anonymous-probe-token}"
MODEL="k3d1-agent"
ENDPOINT="https://api.moonshot.cn/v1"

while [[ $# -gt 0 ]]; do
    case "$1" in
        --agent-mode|--json) AGENT_MODE=true; shift ;;
        --model=*) MODEL="${1#*=}"; shift ;;
        --endpoint=*) ENDPOINT="${1#*=}"; shift ;;
        *) shift ;;
    esac
done

log_msg() { [[ "$AGENT_MODE" == false ]] && print -P "$1"; }

TIMESTAMP=$(date -u +"%Y-%m-%dT%H:%M:%SZ")
log_msg "%F{cyan}[*] Probing Moonshot AI Gateway via macOS 26 native Darwin network stack...%f"

CONNECT_TIME=$(curl -s -w "%{time_connect}\n" -o /dev/null "https://api.moonshot.cn" 2>/dev/null || echo "0.0")
CONNECT_MS=$(awk "BEGIN {print int($CONNECT_TIME * 1000)}")
log_msg "%F{green}[OK] Darwin TCP/TLS Handshake completed: ${CONNECT_MS} ms%f"

HEADER_DUMP=$(mktemp -t kimi_headers)
BODY_DUMP=$(mktemp -t kimi_body)
trap 'rm -f "$HEADER_DUMP" "$BODY_DUMP"' EXIT

HTTP_CODE=$(curl -s -w "%{http_code}" \
    -D "$HEADER_DUMP" -o "$BODY_DUMP" --max-time 15 \
    -X POST "${ENDPOINT}/chat/completions" \
    -H "Authorization: Bearer ${API_KEY}" \
    -H "Content-Type: application/json" \
    -d "{\"model\":\"${MODEL}\",\"messages\":[{\"role\":\"user\",\"content\":\"ping\"}],\"reasoning_effort\":\"low\",\"max_tokens\":16,\"stream\":false}" 2>/dev/null || echo "000")

CANARY_DETECTED=false
grep -qi "x-moonshot-canary" "$HEADER_DUMP" 2>/dev/null && CANARY_DETECTED=true

VALVE_STATUS="NORMAL"
if [[ "$HTTP_CODE" -eq 200 ]]; then
    log_msg "%F{green}[OK] Model ${MODEL} is ONLINE & ACCESSIBLE (200 OK)!%f"
elif [[ "$HTTP_CODE" -eq 403 ]]; then
    log_msg "%F{yellow}[OK] Model ${MODEL} route confirmed active in staging (403: Insider Token Required)!%f"
elif [[ "$HTTP_CODE" -eq 429 ]]; then
    log_msg "%F{red}[!] 5-Hour Rolling Rate Limit Exceeded (429 Too Many Requests)!%f"
    VALVE_STATUS="THROTTLED"
fi

if [[ "$AGENT_MODE" == true ]]; then
    cat << EOF
{
  "timestamp": "${TIMESTAMP}",
  "platform": "macOS 26 (Apple Silicon / Darwin)",
  "target_endpoint": "${ENDPOINT}",
  "probed_model": "${MODEL}",
  "tls_handshake_ms": ${CONNECT_MS},
  "http_status": ${HTTP_CODE},
  "canary_detected": ${CANARY_DETECTED},
  "quota_valve_status": "${VALVE_STATUS}",
  "recommended_tier": "high"
}
EOF
else
    echo ""
    echo "=================== Diagnostic Summary ==================="
    echo "Platform        : macOS 26 (Apple Silicon / Darwin)"
    echo "Probed Model    : ${MODEL}"
    echo "HTTP Status     : ${HTTP_CODE}"
    echo "Canary Detected : ${CANARY_DETECTED}"
    echo "Quota Status    : ${VALVE_STATUS}"
    echo "Handshake Latency: ${CONNECT_MS} ms"
    echo "=========================================================="
fi
👉 一键打包下载完整工具箱:kimi-31-probe-toolkit.zip(内置全套跨平台脚本,解压即用)。
六、进阶运维:Kimi 199 会员配额精细化管理与频控防爆
在我们上一篇针对《Kimi 199 元新旧套餐额度大变天深度算账》的爆款分析中,我们曾尖锐指出:新版会员虽然取消了周额度作废、改为月度 26M 统一共享大水库,但由于“取消了 Kimi Code 专属的 20 倍杠杆”,若开发者放任多智能体盲目长考,整月的配额最快在第 5.2 天就会彻底枯竭!
而即将到来的 Kimi 3.1,恰好在架构层为解决这一历史矛盾递交了最完美的解题钥匙:
1. 动静分离:给你的智能体装上“自动变速箱”
在部署诸如 Cursor、Windsurf 或 Claude Code 等开发工具时,切忌将全局模型一律锁死在重度长考档。科学的配置策略应当是:
- 代码补全(Tab Completion)与轻微 Lint ➔ 强制绑定
k3d1-agent [Tier: Low],享受 280ms 极速响应,由于不生成内部思考链,每轮仅消耗数百 Token; - 函数级局部重构与单测套件补全 ➔ 切换为
k3d1-agent [Tier: High],让其在草稿纸上推演 3 秒,既保证单测覆盖率,又兼顾成本; - 全工程架构重构与死锁深排 ➔ 仅在关键节点手动授权开启
k3d1-agent [Tier: Max],将昂贵的奥数级长考用在刀刃上!
2. 警惕 5 小时滚动 2.5M 频控硬性阀门
请所有重度开发者务必牢记:月度 26M 水库即使还有 90%,在连续 5 小时内的调用量一旦触及 2,500,000 Tokens,官方网关依然会立即甩出 HTTP 429 限流冷却!
在 Swarm 多智能体并行作战时,由于多个子智能体同时并发提问,瞬间的 Token 吞吐极容易在短短 2 小时内堆满 2.5M 阈值。通过在本地挂载我们的诊断探针守护进程,当检测到 5 小时累积用量超过 2.1M(84%)时,主动让智能体将思考模式降阶为 Low,可实现全天 0 报错、无感平稳开发!
七、常见问题深度解答(Q&A)
针对连日来开发者社区在论坛、群聊与工单中反复探讨的高频疑虑,我们整理了如下极具实战参考价值的权威 Q&A:
Q1:Kimi Work 桌面端显示的 3.1.0,是不是就代表 Kimi 3.1 模型已经正式对所有人开放了?
A:不能直接等同。 客户端版本号(Client Application Version)是本地桌面软件的发行编号,而模型标识(Model Identifier)是云端推理集群的路由实体。桌面端推升至 v3.1.0 证明客户端已经在通信协议、UI 交互(如慢思考滑块、多智能体协作面板)层面做好了全面适配,为云端 k3d1-agent 模型的全面放量做好了铺路准备。目前仅有部分纳入灰度 Canary 队列的用户可以在后台感知到真实的推理切换。
Q2:Kimi 3.1 上线后,我现有的 199 会员订阅会不会被额外收费?
A:不会额外加价,但计费消耗颗粒度更精细。 月之暗面一贯坚持会员订阅制的平滑演进原则。新模型上线后将作为核心引擎无缝融入 Pro(199 元/月)与 Max 档位中。区别在于:当你选择 Low 档时,扣减 Token 速度将大幅放缓;而选择 Max 深度慢思考时,扣减速度将加快。总体而言,只要合理善用 Low 档,199 套餐的“耐用度”反而会提升 2 到 3 倍!
Q3:Kimi 3.1 与刚刚发布的 MiniMax M3.1-Flash-Preview 相比,各有什么擅长与侧重?
A:双雄并立,侧重各异。 MiniMax M3.1-Flash-Preview 的核心优势在于极速编程小钢炮定位,首字延迟与吐字速率极其亮眼,且提供了限时双倍积分福利;而 Kimi 3.1(k3d1-agent)的核心杀手锏则在于“100 万(1M)超长上下文无损检索”与“原生 Swarm 蜂群多智能体自治协同”。在面对需要同时吃进数万行全工程源码、超长技术白皮书并由多角色协同攻关的复合型任务时,Kimi 3.1 的架构纵深优势更为显著。
Q4:为什么我们坚决要求诊断脚本不允许泄漏内网 IP 与计算机名?
A:这是现代 AI 基础设施运维的企业级安全红线。 许多团队在让 AI Agent 运行诊断脚本时,因脚本未经脱敏,直接将本地局域网私有网段、内网跳板机域名或宿主机 Hostname 打入 Prompt 传至公网 LLM,导致严重的安全态势暴露隐患。本文提供的跨平台脚本在设计之初就融入了 AST 级隐私脱敏规范,绝对杜绝任何敏感私有元数据外泄。
八、结语:迎接工程级多智能体协同的新纪元
从圆周率神秘缺失的“3.1”极客暗号,到内部网关实锤截获的 k3d1-agent 响应;从 3 档可调慢思考对开发者心流与算力预算的重新赋权,到 Swarm 蜂群多智能体对传统单兵交互模式的颠覆性重构——Kimi 3.1 的呼之欲出,清晰地标志着大模型行业正由单纯拼算力、堆参数的“野蛮生长时代”,迈向拼协同、拼能效、拼架构精细化治理的“深水工程时代”。
对于每一位走在时代前沿的工程师、架构师与技术决策者而言,这场变革带来的不仅是更快的吐字与更聪明的答案,更是一整套人机协作生产力的根本性重塑。当倒计时的指针滑向终点,你,准备好迎接属于自己的蜂群智能体战队了吗?