1024程序员节硬核大礼!Kimi K3.1 Pro 与 Highspeed 突袭发布:3万亿参数砍价三分之一,官方为何在开源前连夜“自废”9.5%的黑客功力?
今天是 2026 年 10 月 24 日——一年一度的 1024 程序员节。就在昨晚(10 月 23 日深夜),月之暗面(Moonshot AI)没有任何冗长的预热直播,赶在 1024 程序员节零点前,直接在技术博客与开放平台给全球开发者送上了一份诚意拉满的「1024 节日大礼」:K3.1 系列的首款 3 万亿级(3T-class)旗舰模型 kimi-k3.1-pro,以及生成速度翻了 2 到 3 倍的同源极速版 kimi-k3.1-pro-highspeed。
更有意思的是一个属于程序员的数字浪漫:Kimi K3.1 Pro 的上下文窗口精确设定为 1,048,576 个 Token——算一下就会发现,这正好是 1024 × 1024(即 2 的 20 次方,2^20)!在 1024 程序员节这一天,用着 1024 × 1024 上下文窗口的新旗舰写代码,仪式感直接拉满。
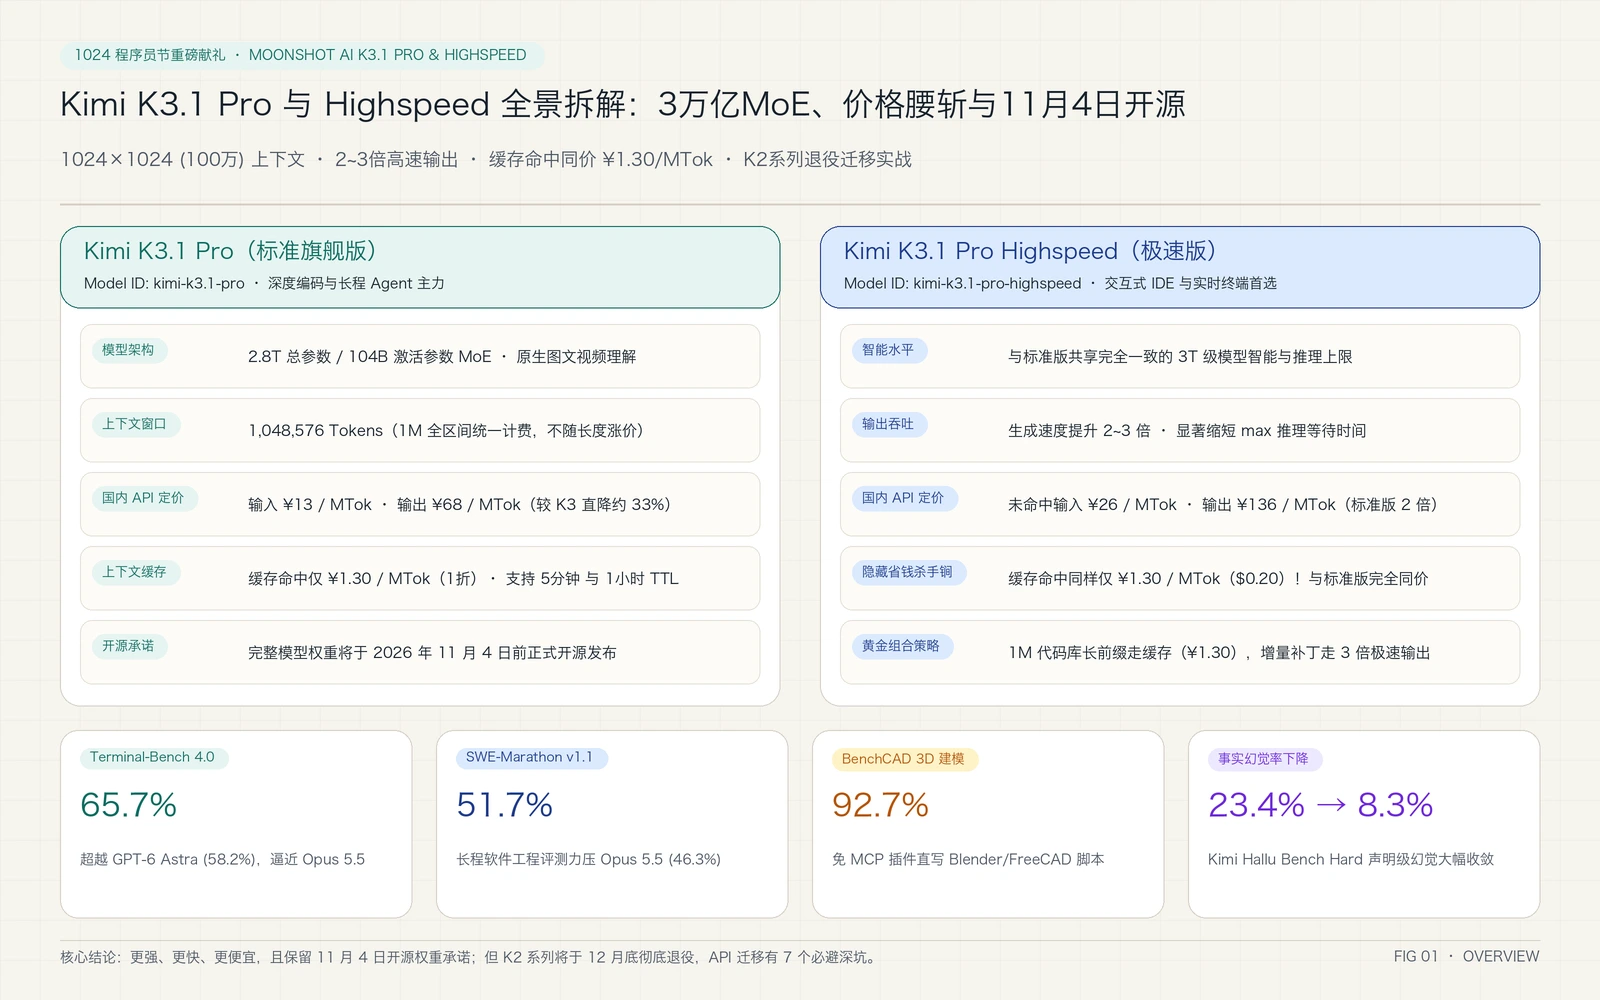
如果你平时用 Claude Code、OpenAI Codex CLI 或者自己写了自动化 Agent 流水线,这份 1024 程序员节礼物里有四个反常识的信号值得立刻停下来看一眼:
- 参数规模冲上 2.8 万亿总参数(1040 亿激活参数 MoE),支持
1024 × 1024(1,048,576)Token 上下文,但国内与海外 API 定价反而比上一代kimi-k3便宜了约三分之一(国内输入¥13/MTok、输出¥68/MTok;海外输入$2.00/MTok、输出$10.00/MTok)。 - 极速版
kimi-k3.1-pro-highspeed虽然未命中输入和输出单价是标准版的 2 倍,但在最关键的「上下文缓存命中(Cache Hit)」一栏,官方定出了与标准版分毫不差的¥1.30/MTok($0.20/MTok)。只要用对缓存策略,你可以花标准版的上下文成本,在 1024 程序员节白嫖 3 倍的极速流式响应。 - 官方宣布完整模型权重将于 2026 年 11 月 4 日前正式开源。更戏剧性的是,技术报告罕见披露:在强化学习算力扩展过程中,内部版本在硬核漏洞利用基准
xdev-bench-hard上的通关率一度飙到了90.5%。为了避免 11 月 4 日开源权重变成现成的自动化攻击武器,团队在发布前主动洗掉了中训和 RL 阶段的高危网络攻击语料,把这项指标压回了81.0%。 - 与这份 1024 惊喜一起到来的,还有老模型的谢幕倒计时:
kimi-k2.6、kimi-k2.7-code、kimi-k2-thinking等 K2 全系列模型将于 2026 年 10 月 31 日停止向新用户开放,并于 2026 年 12 月底彻底下线。很多开发者昨晚第一时间把代码里的模型名改成kimi-k3.1-pro后,却迎面撞上了一连串HTTP 400 Bad Request、缓存命中率清零和子代理崩溃——如果不摸清里面的协议门道,1024 程序员节的大礼分分钟变成「1024 紧急排障加班局」。
这篇文章我们就借着 1024 程序员节的契机,把 Kimi K3.1 Pro 和 Highspeed 的底层底牌、那些小学生都能听懂的技术比方、K2 迁移到 K3.1 的七大排障根因,以及支持 Windows 11、Ubuntu 26.04、macOS 27 的零依赖一键全自动迁移脚本一次讲透,让大家在 1024 节当天优雅升级、准点下班。
一、问题背景:为什么说 K3.1 Pro 不只是一次常规小版本迭代?
在过去半年里,大模型圈子其实陷入了一种微妙的疲劳感:很多带小数点的版本更新,往往只是刷高几个选择题榜单,放到真实的十万行代码仓库里跑超过 30 轮工具调用,依然会出现「改了东墙塌西墙」「环境报错就胡乱猜代码」或者「多轮对话后把前面的约束忘得一干二净」。
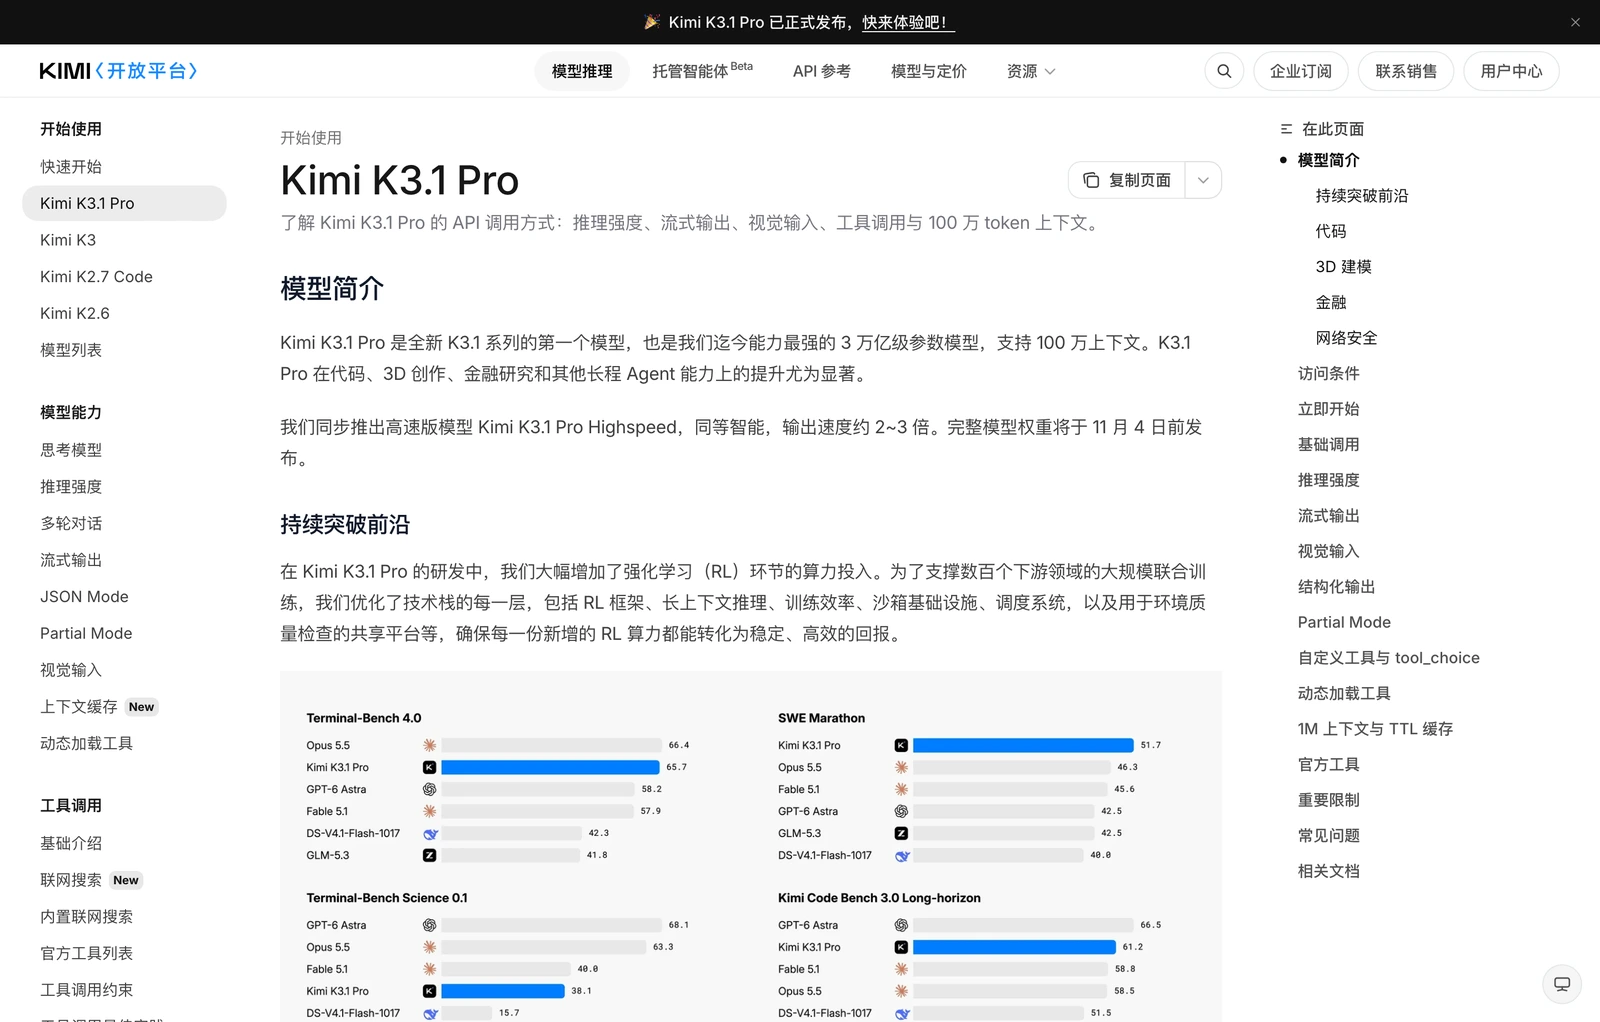
从月之暗面这次公开的技术细节来看,Kimi K3.1 Pro 的核心发力点并不是单纯堆砌预训练语料,而是把海量算力砸向了「跨数百个下游领域的联合强化学习(Joint RL)」以及全栈基础设施重构(包括 RL 训练框架、1M 长上下文推理优化、沙箱调度系统和共享环境质检平台)。
我们先看第三方独立评测机构 Artificial Analysis 与官方同步放出的全维度成绩单(均在默认 reasoning_effort = "max" 档位下实测):
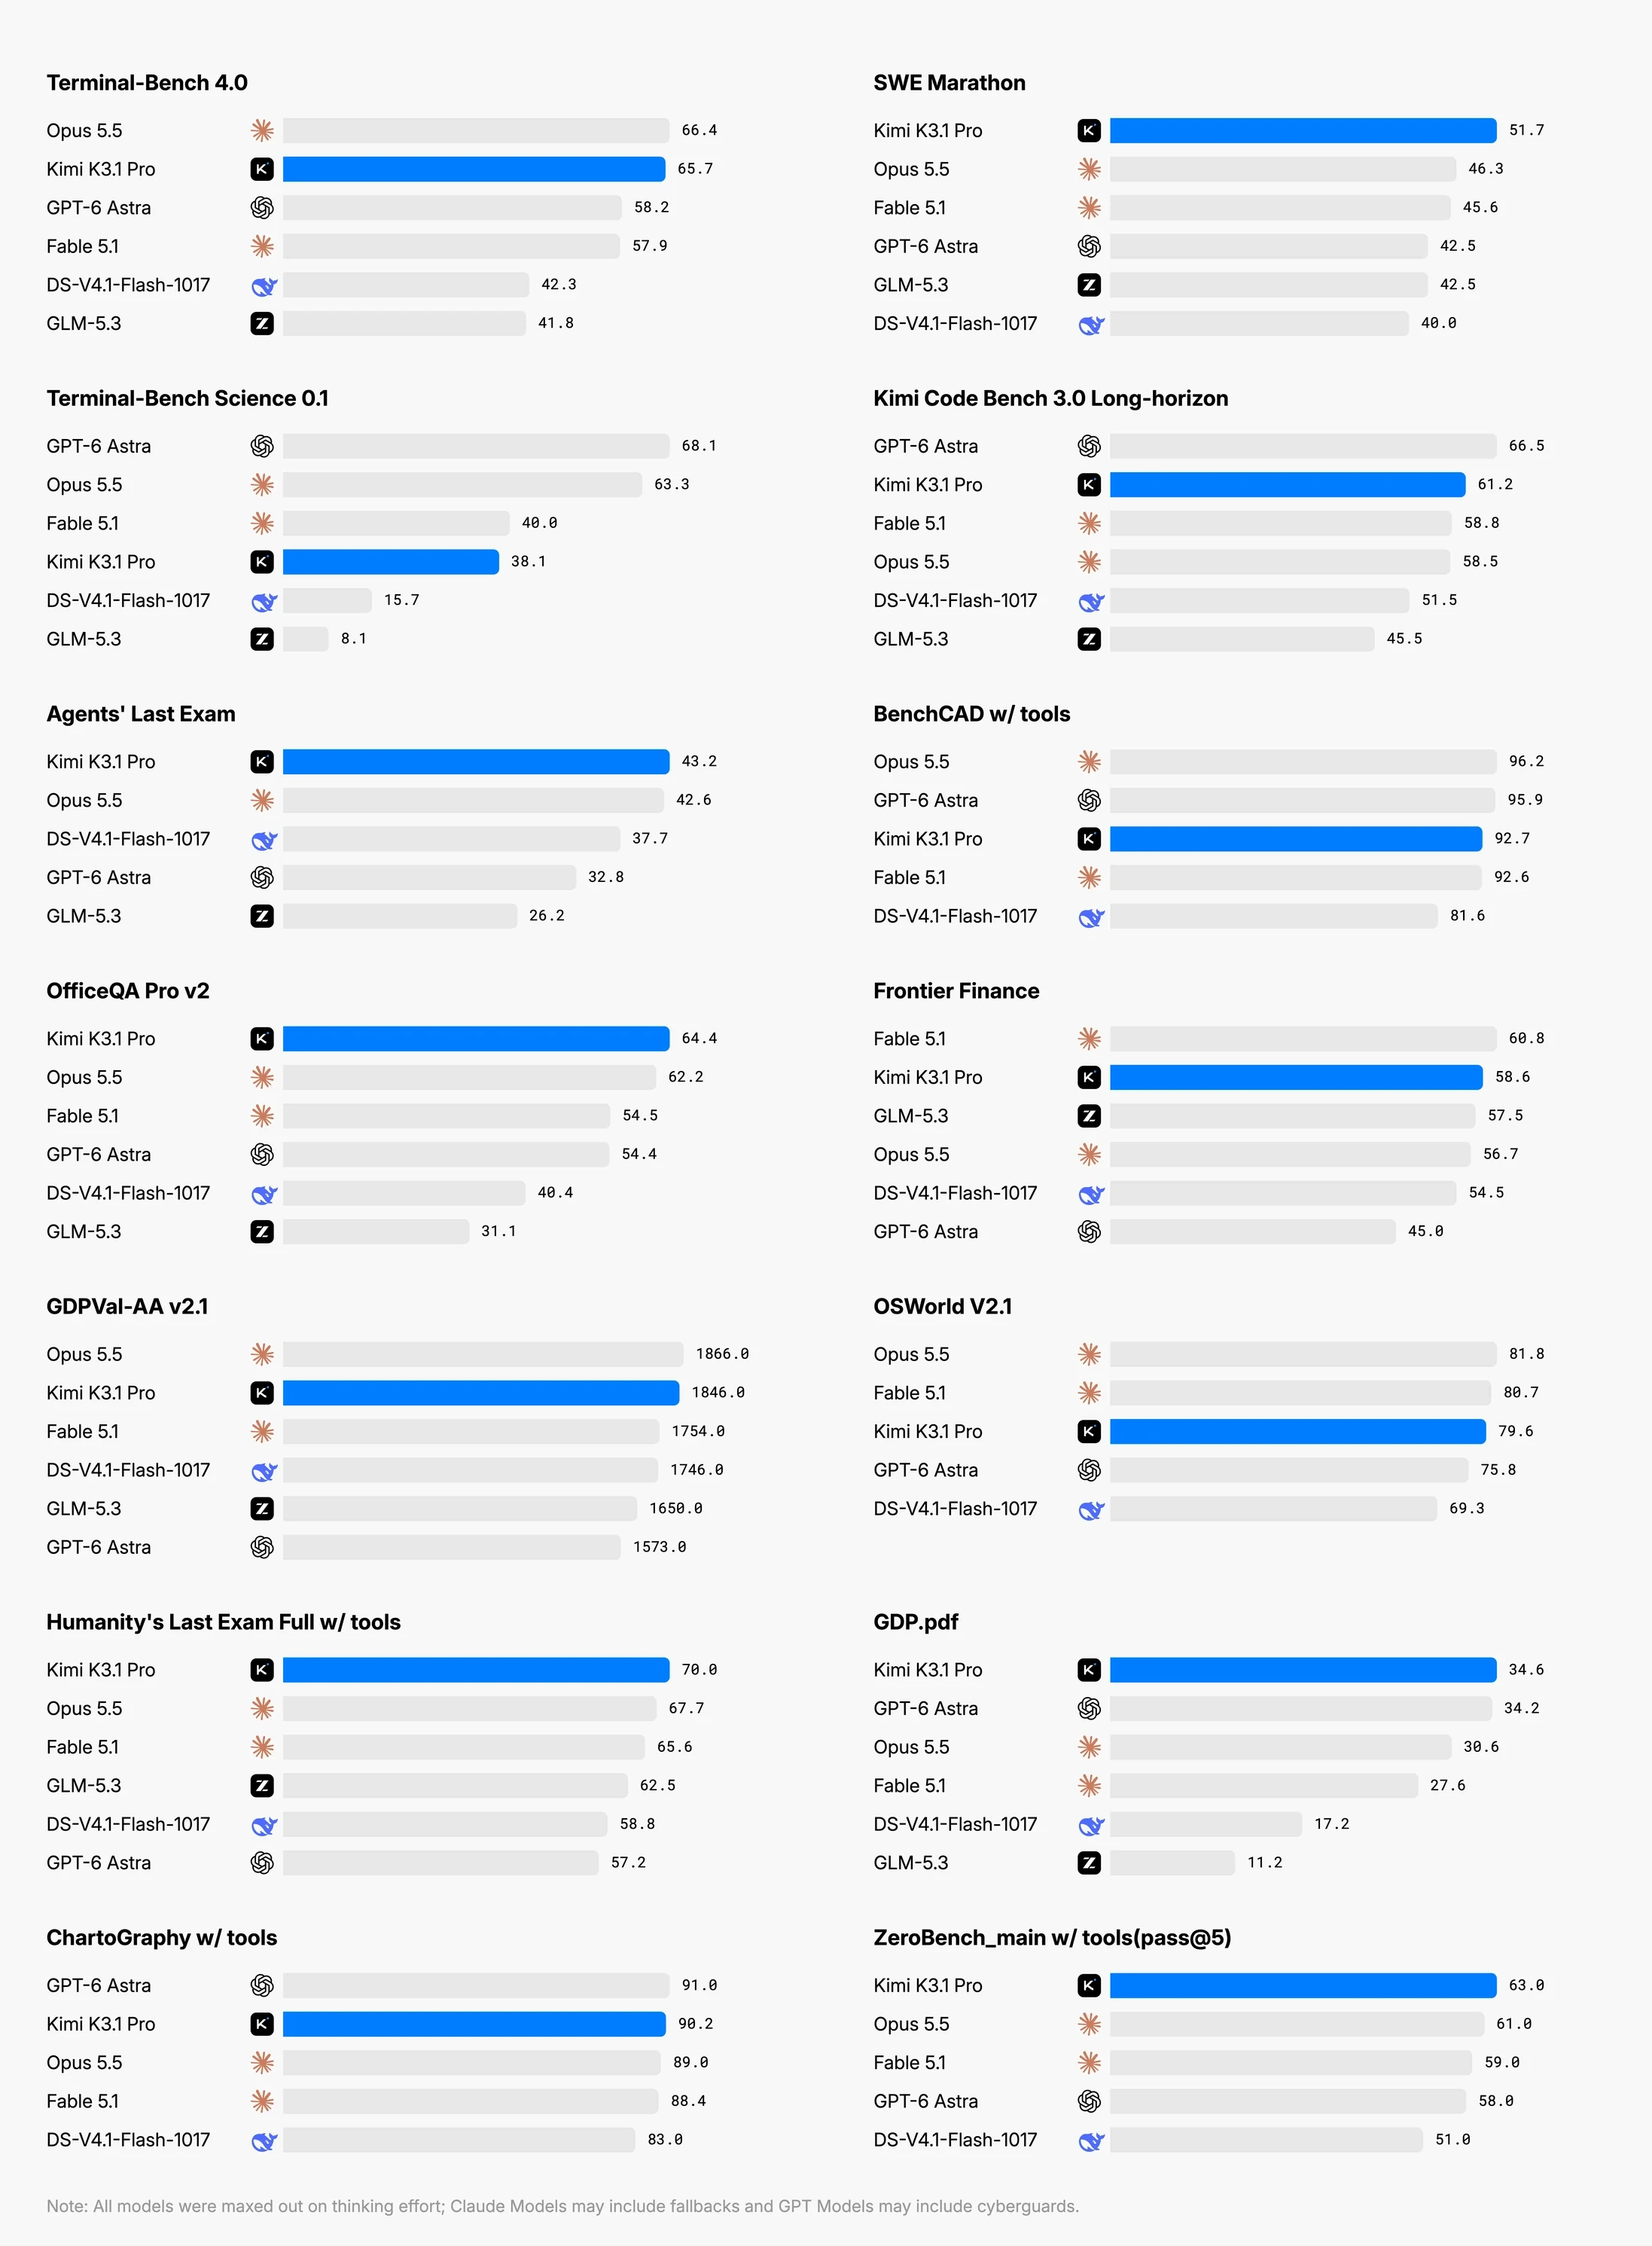
把上面这张密密麻麻的成绩单翻译成大白话,最核心的硬指标有五个:
- 全球综合智商(Artificial Analysis Intelligence Index):拿到
55分,比上一代 Kimi K3 足足跳涨了11分,在全球所有闭源与开源模型中排第 4 位(仅次于 Claude Opus 5.5 的58分、Claude Sonnet 5.5 的56分和 Muse Wonder Full 的56分)。 - 终端与系统工程实战(
Terminal-Bench 4.0):从 Kimi K3 的13.0%暴涨到65.7%,直接反超了 OpenAIGPT-6 Astra(58.2%)和Fable 5.1(57.9%),紧咬全球第一的Claude Opus 5.5(66.4%)。 - 超长程软件工程马拉松(
SWE-Marathon v1.1与DeepSWE v1.1):在需要连续几小时跨文件定位、修改并验证的大型工程任务SWE-Marathon v1.1上拿到51.7%,力压Claude Opus 5.5(46.3%)和GPT-6 Astra(42.5%);在DeepSWE v1.1上拿到75.5%,同样位居榜首。 - 办公与复杂文档推理(
OfficeQA Pro v2与GDPval-AA v2.1):OfficeQA Pro v2拿到64.4%位列第一(超越 Opus 5.5 的62.2%);GDPval-AA拿到1,846 Elo(比 K3 提升312分,全球第三)。 - 性价比帕累托前沿:在
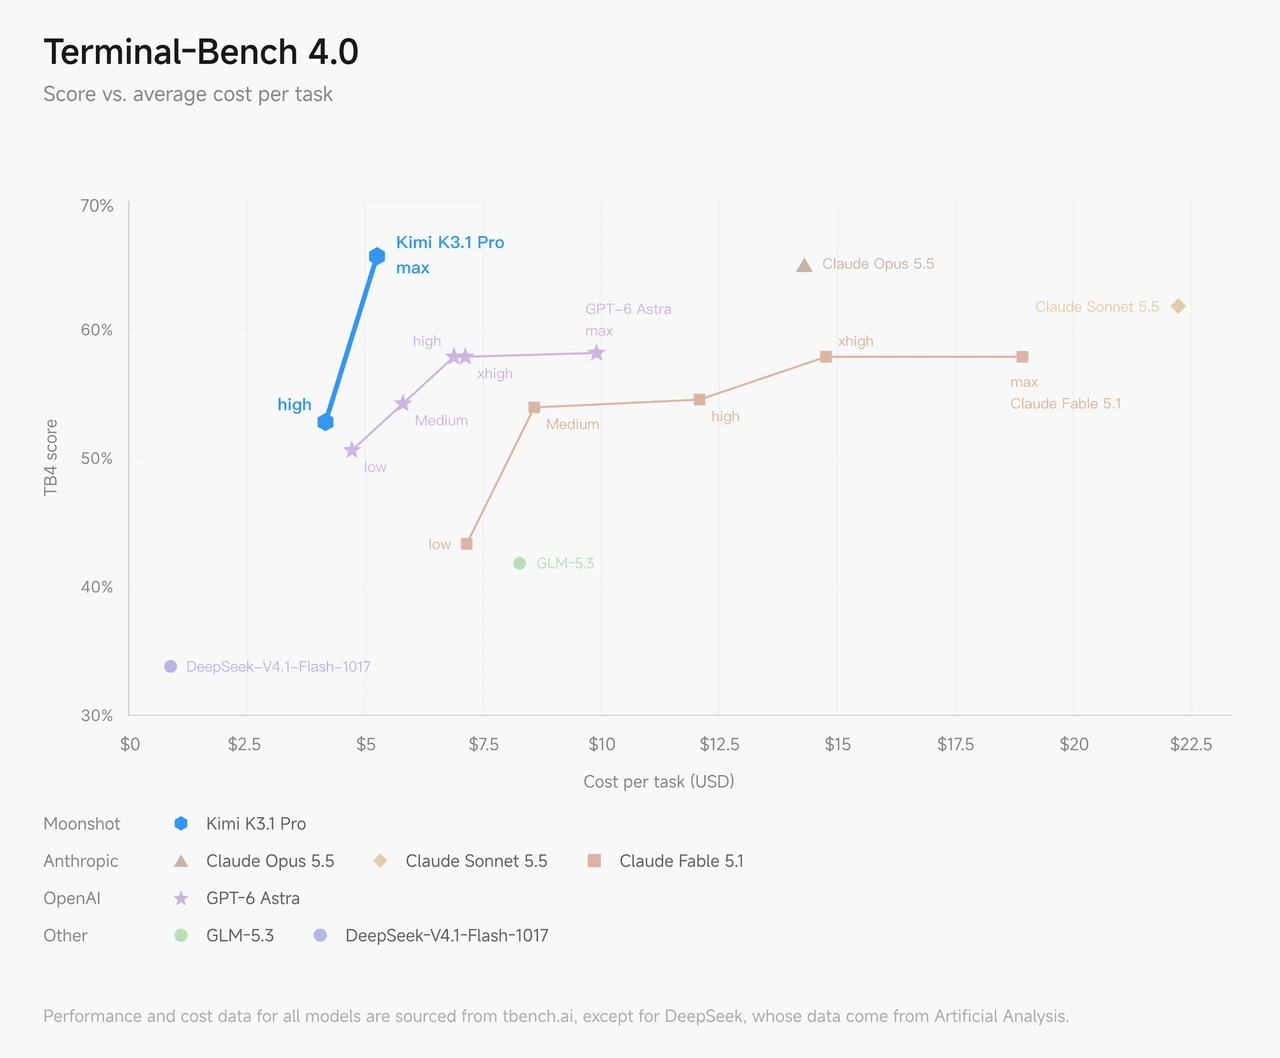
Terminal-Bench 4.0的「准确率 vs 单次任务总成本」散点图上,K3.1 Pro 用大约几分钱美金的 Token 消耗,打出了接近最贵闭源旗舰的成功率。
生活打比方一:用「学骑自行车先拿扳手查脚踏板螺丝」听懂联合强化学习与开环动力学探针
很多读者看到技术报告里写着「在 human-atlas 全身骨骼肌肉仿真器(296 块骨头、402 块肌肉)里,历经 167 个 Mission 和 420 次 Review 训练出连续行走 11.2 秒的控制器,并通过开环动力学探针(Open-Loop Dynamics Probes)抓出 36 处肩部肌肉力臂计算 Bug」,第一反应往往是:这串专业名词到底在说什么?跟我们平时写代码有什么关系?
我们用一个小学生学骑自行车的日常场景来打比方:
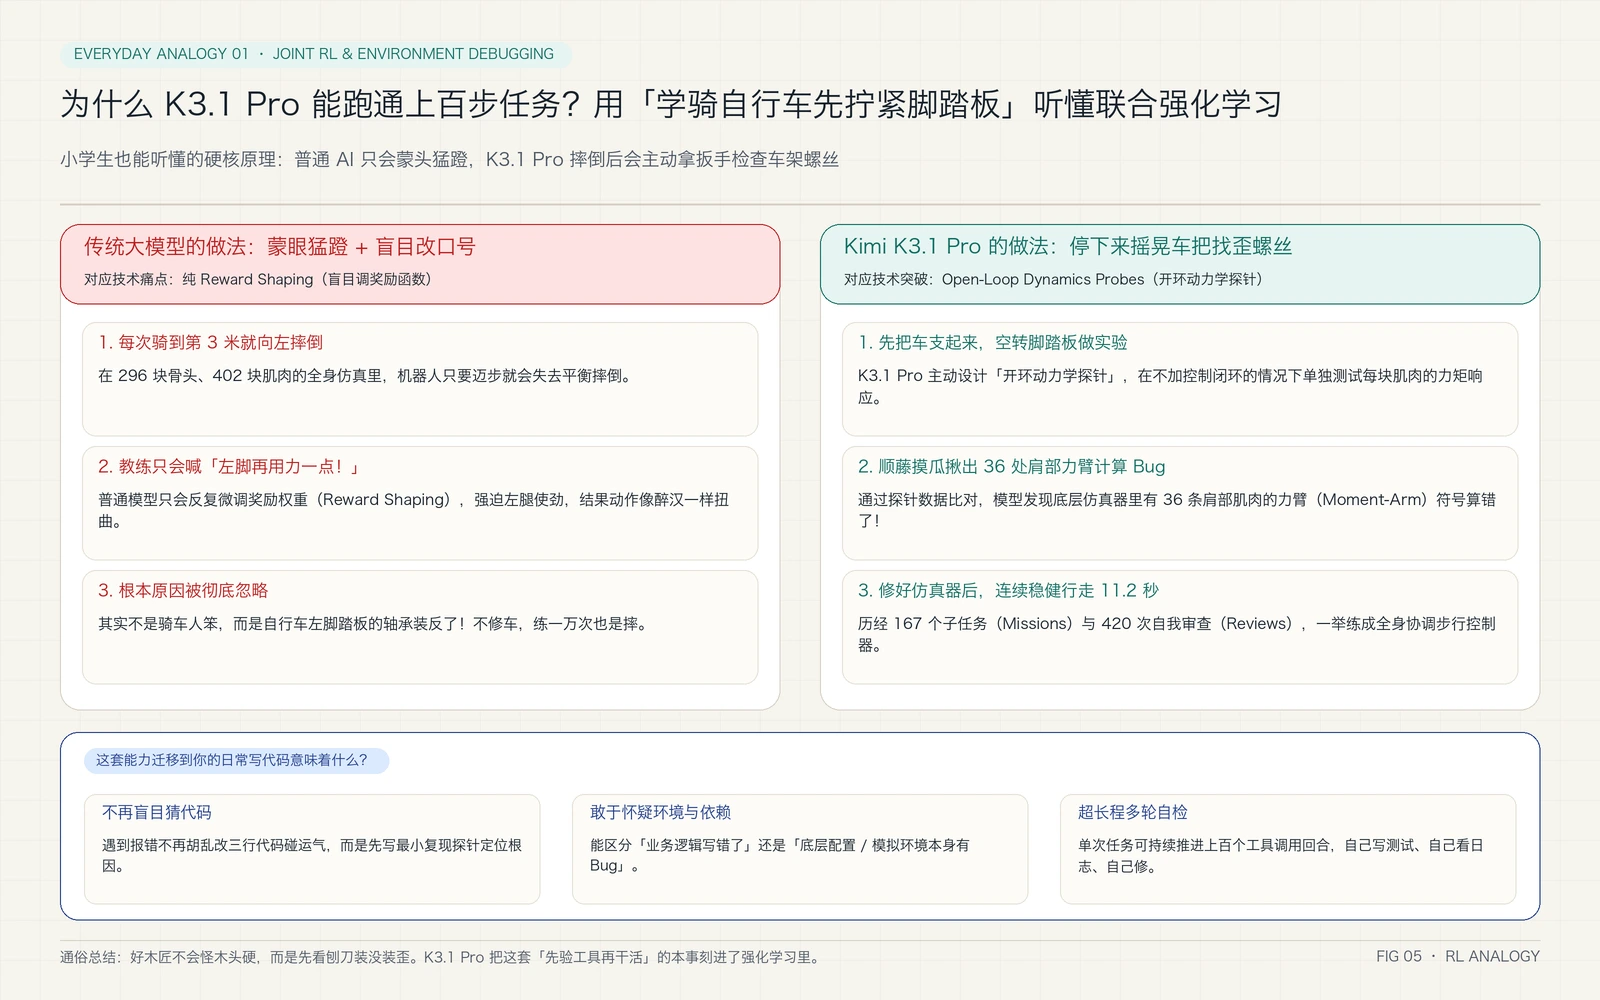
想象一下,你在教一个小朋友骑一辆刚组装好的自行车,但每次骑出去 3 米,车子就会莫名其妙往左边摔倒:
- 普通 AI 模型的做法(盲目调奖励函数 Reward Shaping):就像一个死板的教练,根本不看车子有没有问题,只知道拿着大喇叭在后面喊:「往左边倒了是吧?那你下次左脚再使劲踩两倍!脖子往右边歪 30 度!」小朋友照着练了五百次,姿势扭曲得像杂技演员,结果骑到第 4 米还是摔。
- Kimi K3.1 Pro 的做法(先打探针验环境,再练动作):它摔了几次之后觉得不对劲,干脆停下来不骑了,把自行车倒过来支在地上,用手轻轻拨动左脚踏板和前轮,单独观察每一个齿轮怎么转——这就叫「开环动力学探针(Open-Loop Dynamics Probes)」。结果一测发现:根本不是骑车的人笨,而是出厂时左边脚踏板的轴承螺丝装反了(对应真实案例里仿真器底层 36 条肩部肌肉的力臂 Moment-Arm 符号算错)!
先把装反的 36 颗螺丝拧正,再上车练习,结果顺顺利利骑出了 11.2 秒的稳健直线。这套「遇到报错不盲目猜代码,先写最小探针验证到底是业务逻辑错了、还是测试环境本身有 Bug」的工程直觉,正是 K3.1 Pro 能在 SWE-Marathon 长程编程里反超 Opus 5.5 的真正秘诀。
免插件 3D 建模与金融幻觉率腰斩:从「玩具 Demo」到「生产交付」
除了写后端代码和跑终端,K3.1 Pro 在两个原本容易翻车的垂直领域也交出了亮眼的数据:
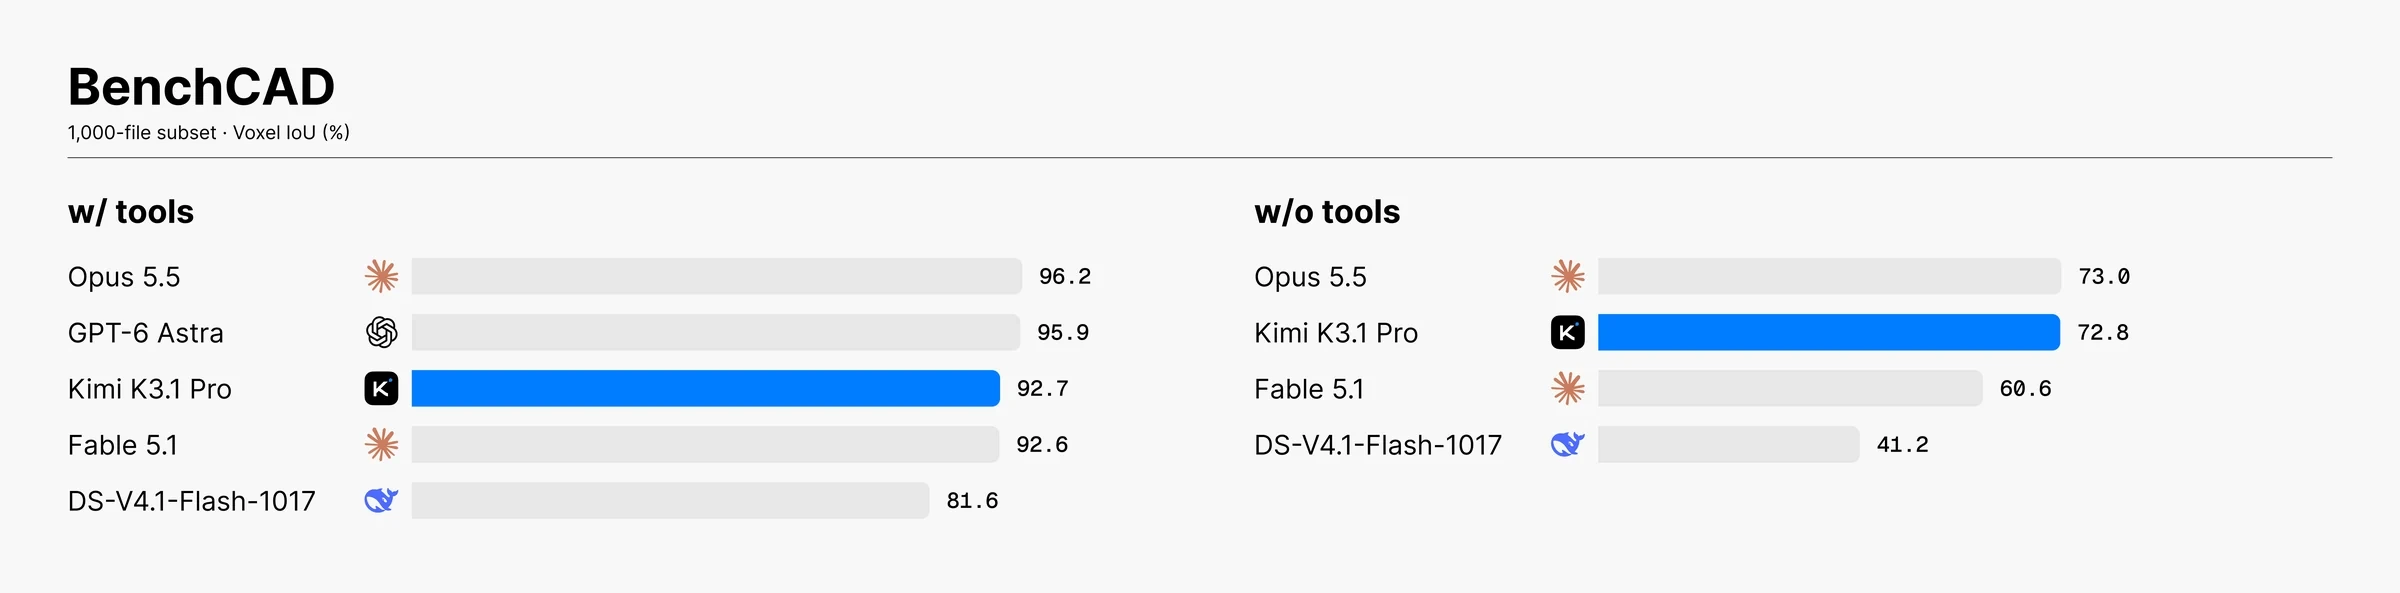
第一个是 3D 建模与 CAD 设计。以前让大模型做 3D 场景,通常必须挂载复杂的第三方 MCP 插件,一点点教它调接口。而 K3.1 Pro 直接把 Blender、FreeCAD、SolidWorks 和 Rhino 的脚本空间几何能力内化进了模型权重。在 BenchCAD 基准测试中,无工具直出得分从 K3 的 46.5% 跃升到 72.8%,配合视觉自检工具更是高达 92.7%(超过 Opus 5.5 的 91.2%)。官方甚至直接在 kimi.ai Web 端上线了 3D Make 工作台:
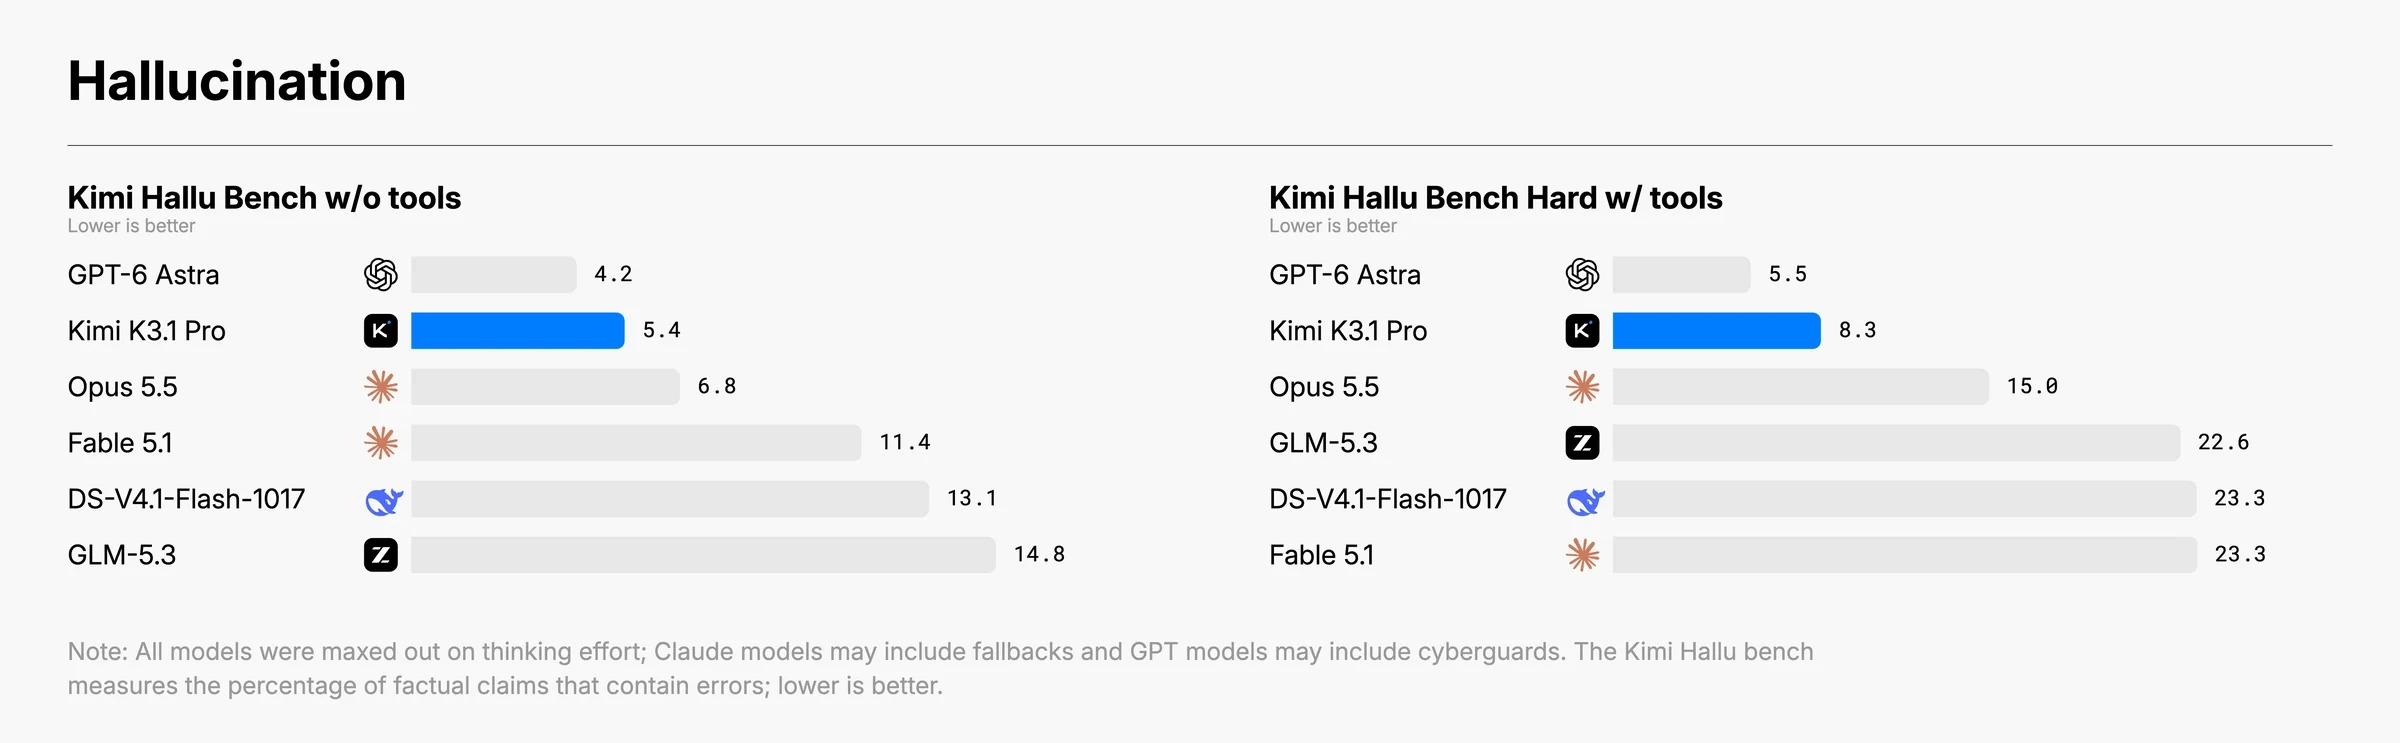
第二个是金融深度投研与幻觉控制。做金融研报或企业财报审计时,最怕模型「一本正经地编造一个不存在的市盈率或合同条款」。在专门考核高难度事实核查的 Kimi Hallu Bench Hard 上,K3.1 Pro 的声明级事实幻觉率从上一代 K3 的 23.4% 直接压低到了 8.3%,降幅接近三分之二:
生活打比方二:为什么官方在 11 月 4 日开源前,主动把黑客基准从 90.5% 降到 81.0%?
整篇技术报告里最抓人眼球的一段,莫过于网络安全章节(Cybersecurity)。
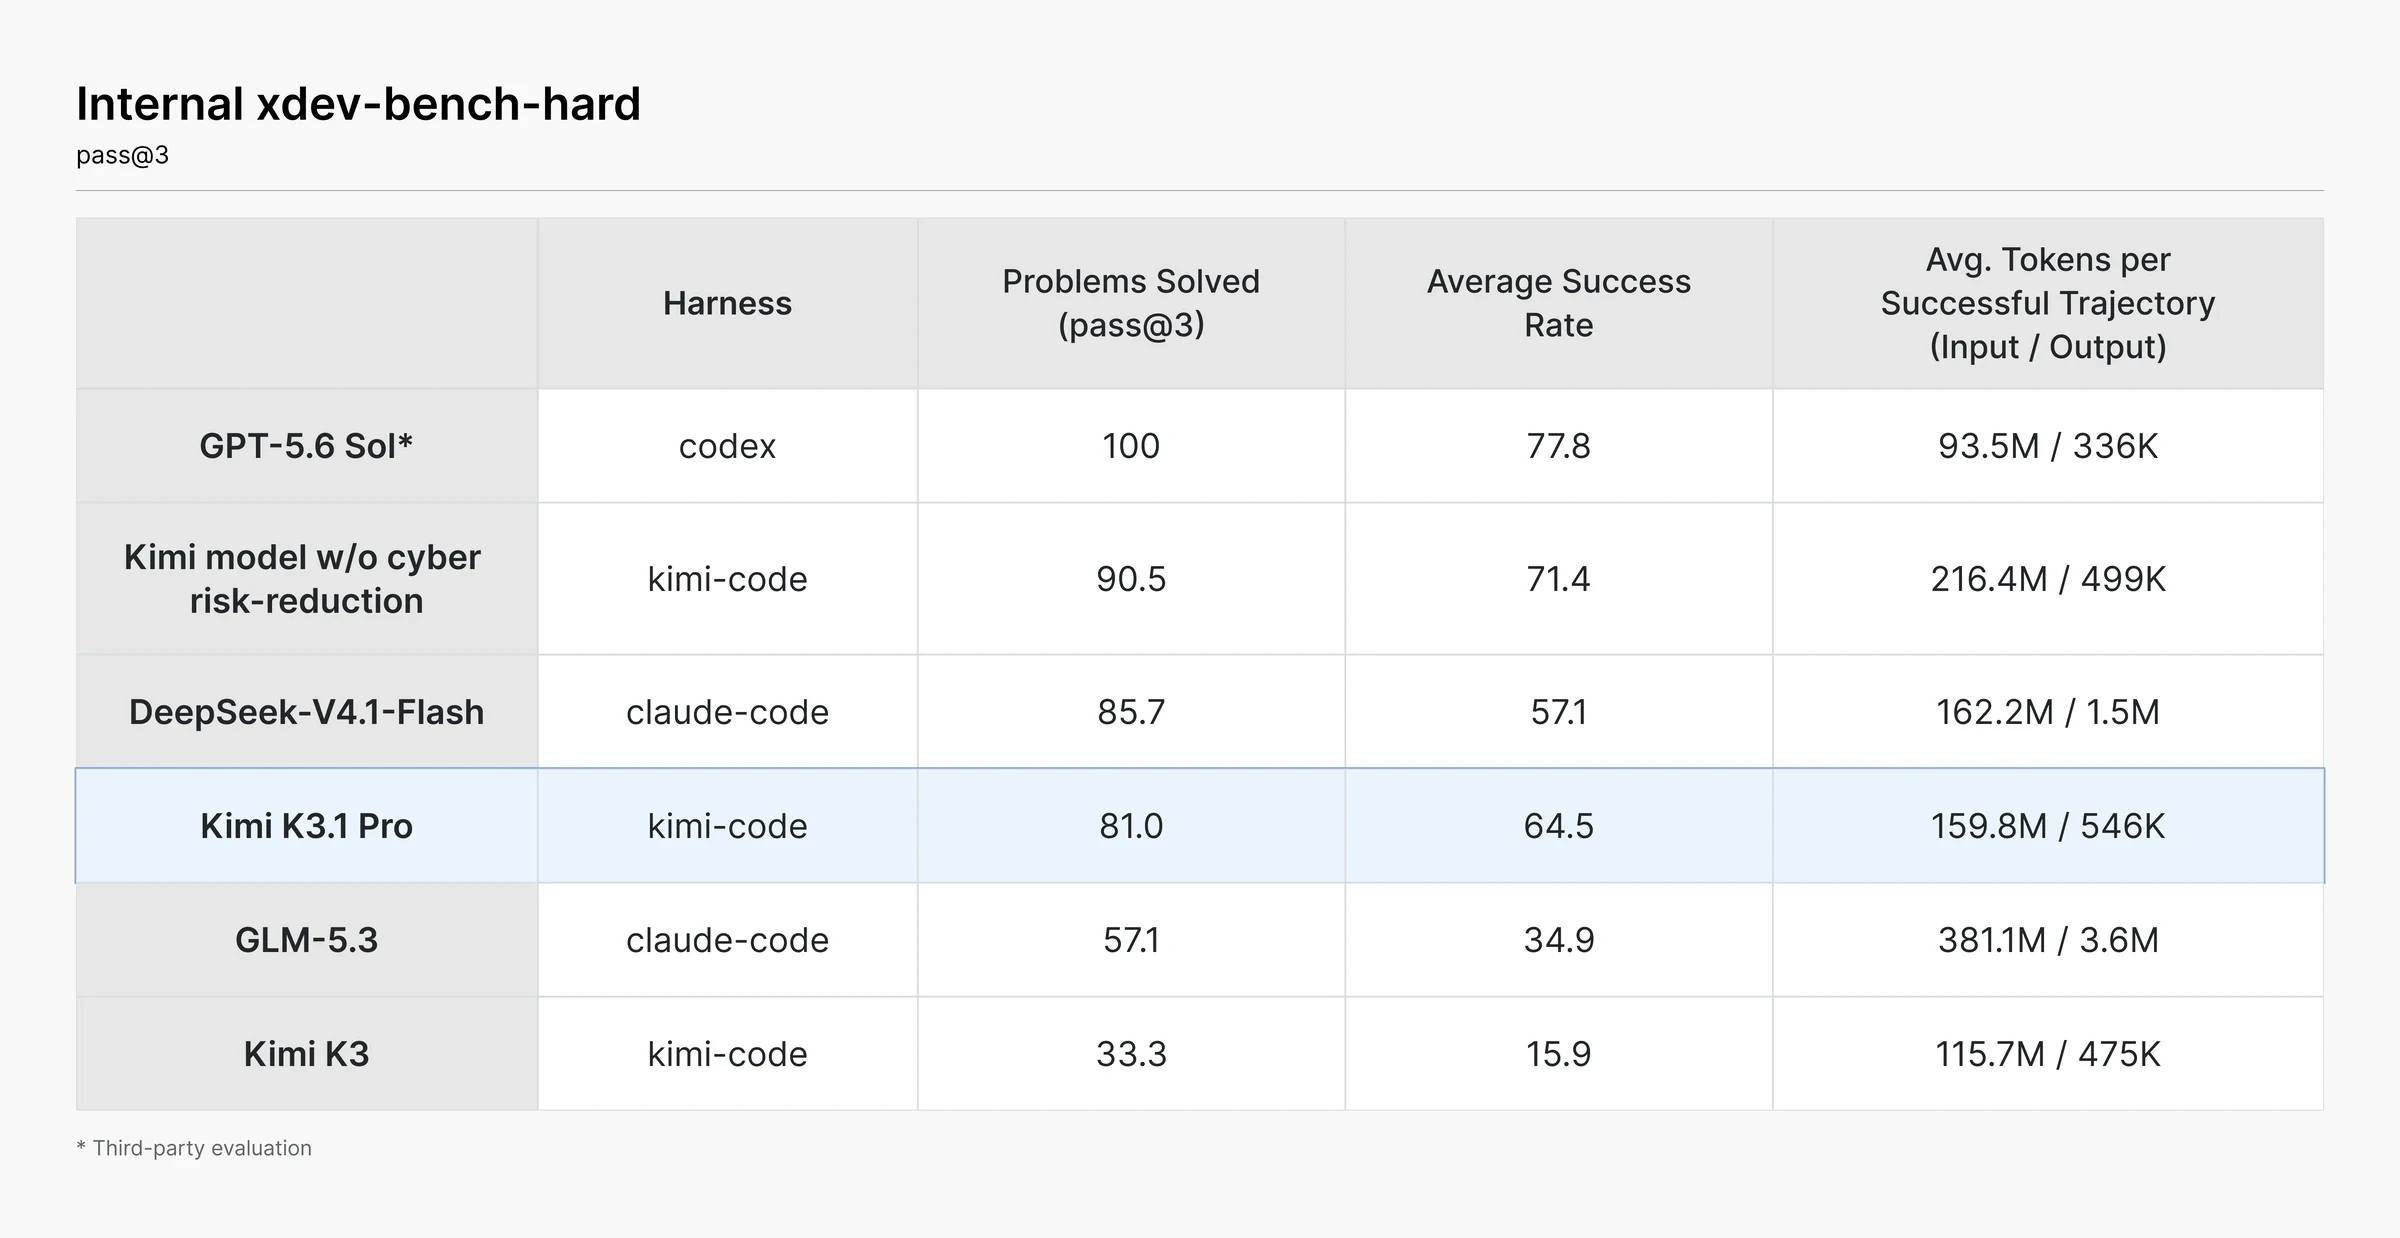
官方透露,在测试包含 Linux 内核、Node.js、JavaScriptCore、Exim 邮件服务器和 VirGL 虚拟 GPU 等真实高危漏洞的 xdev-bench-hard(pass@3)时,上一代 Kimi K3 的得分只有 33.3%。然而当 K3.1 的强化学习算力一路放大后,内部未经清洗的模型版本竟然在没有专门喂投攻击套路的情况下,自己摸索出了 90.5% 的漏洞利用成功率!
为什么最终发布的 K3.1 Pro 得分变成了 81.0%(在另一项 ExploitBench 上为 74.7%)?我们用「发给全班同学的多功能瑞士军刀」来打个比方:
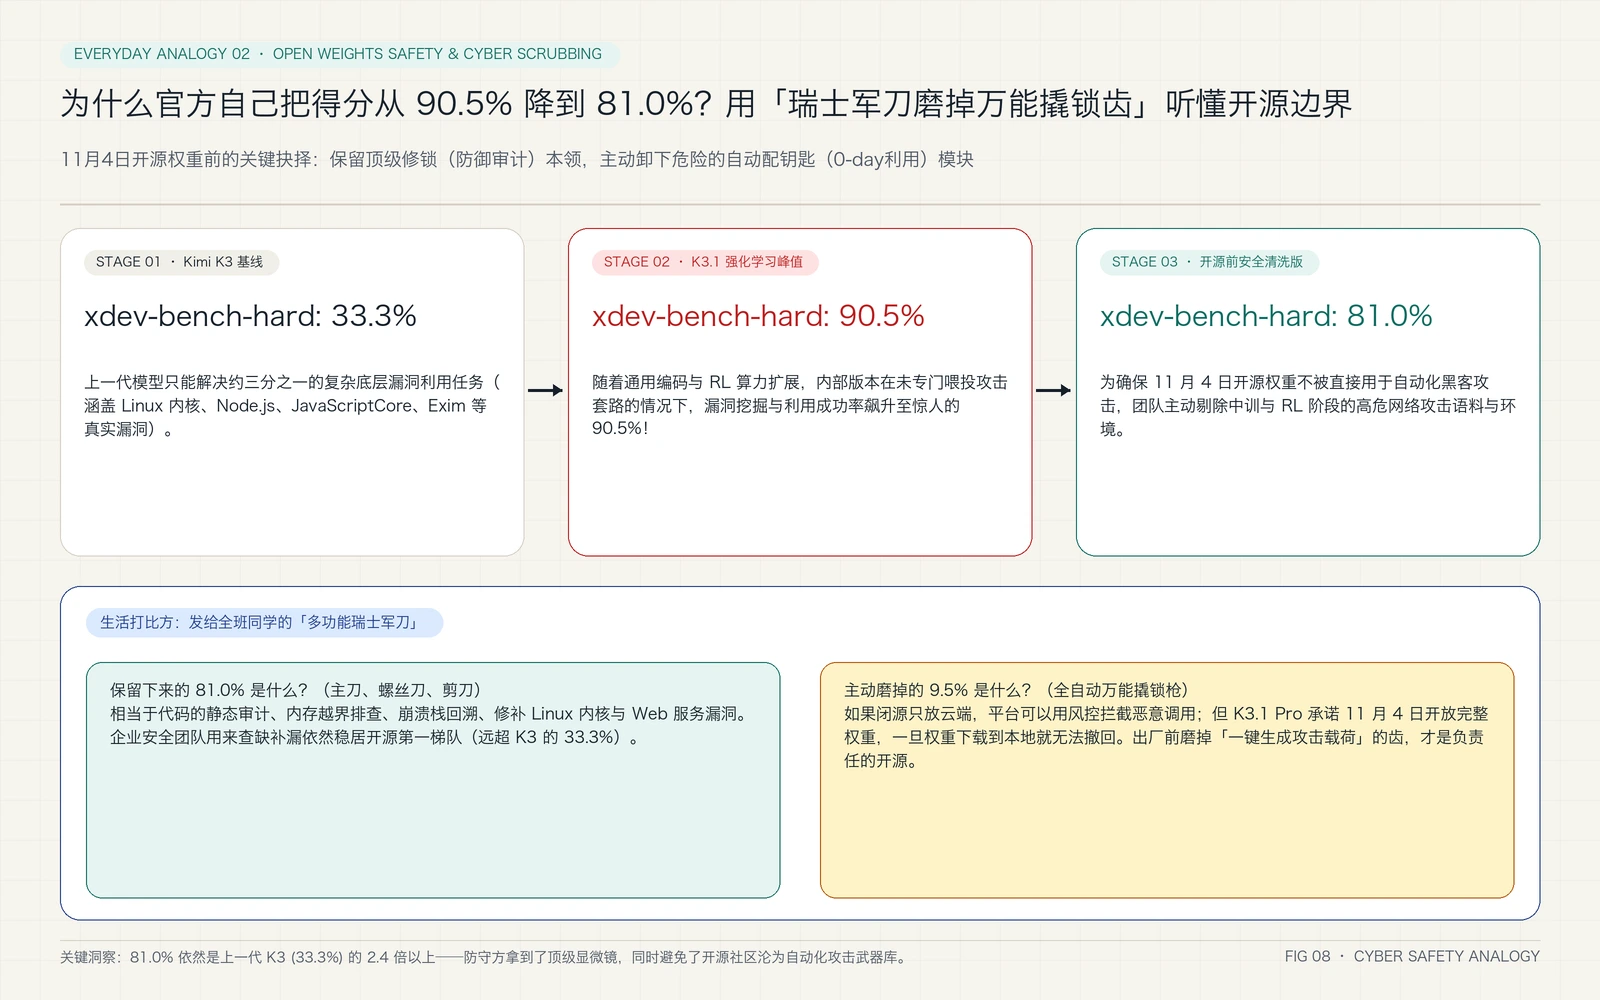
- 如果一个模型永远锁在云端机房里(闭源 API):哪怕它藏着一把「全自动万能撬锁枪」,平台也可以派保安在门口盯着,发现有人想撬别人家门锁就立刻封号拦截。
- 但 Kimi K3.1 Pro 承诺在 2026 年 11 月 4 日前把完整权重免费开源给全世界:开源权重就像把这把瑞士军刀直接发到全球每个人的书包里,一旦下载到本地显卡上,谁也收不回来。
- 所以月之暗面在出厂前做了一件极其清醒的事:把瑞士军刀上那根专门用来「一键撬开别人家防盗门」的万能锁齿(中训与 RL 阶段的高危攻击载荷生成数据)主动用砂轮磨掉了,但完整保留了锋利的主刀、十字螺丝刀和放大镜(代码审计、崩溃栈回溯、内存越界排查)。
磨掉那 9.5% 之后,81.0% 的得分依然是上一代 K3(33.3%)的 2.4 倍以上,稳居开源模型第一梯队。白帽安全工程师拿它来查 Bug、写补丁依然削铁如泥,同时又没有把现成的自动化 0-day 攻击流水线塞进开源社区:
二、问题表现:老项目切到 K3.1 Pro 时,开发者最常撞上的 5 类真实报错
既然 K3.1 Pro 又强又便宜,而且 K2 全系(kimi-k2.6、kimi-k2.7-code、kimi-k2-thinking)将在 2026 年 10 月 31 日停止拉新、12 月底彻底停服,那是不是把代码里的 model: "kimi-k2.6" 直接全局替换成 model: "kimi-k3.1-pro" 就万事大吉了?
千万别这么干!不少团队昨晚直接替换模型名后,线上日志当场炸出了以下 5 种典型症状:
- 症状一(接口直接报
HTTP 400 Bad Request):原本在 K2 或 OpenAI 接口里跑得好好的低温度代码生成请求(例如传了temperature: 0.2或top_p: 0.8),切到kimi-k3.1-pro后直接被网关拒收,提示采样参数非法。 - 症状二(带
thinking开关的请求全军覆没):以前调kimi-k2-thinking时通过"thinking": {"type": "enabled"}或"disabled"控制思考模式的脚本,换上kimi-k3.1-pro后全部返回参数校验失败。 - 症状三(多轮工具调用突然「失忆」或原地打转):在自定义 Agent 循环里,第 1 轮工具调用很聪明,到了第 3 轮之后突然开始重复调同一个命令,或者算错简单的上下文逻辑。
- 症状四(开启了上下文缓存,但账单不仅没降反而翻倍):明明买了 1 小时 TTL 缓存,想在交互式对话里「简单问题用
reasoning_effort="low",复杂问题切reasoning_effort="max"」,结果后台一看cached_tokens永远是0! - 症状五(Claude Code 主对话能用,一派发 Subagent 子任务就卡死报错):在终端里配置了
ANTHROPIC_MODEL="kimi-k3.1-pro",普通聊天正常,但只要 Claude Code 触发子代理搜索或者自动压缩上下文(Auto-Compact),立刻报模型不存在或上下文超限。
三、问题分析:读懂 Highspeed 定价玄机与 1M 缓存机制
在排查上述报错根因之前,我们先算一笔直接关系到钱包的工程账:kimi-k3.1-pro 和 kimi-k3.1-pro-highspeed 到底该怎么选?为什么说很多人在算 Highspeed 成本时漏看了一行最关键的数字?
生活打比方三:用「复印机玻璃板上的 500 页底稿 + 顺丰特快」看懂 Highspeed 的缓存同价红利
我们先看一眼 Kimi 开放平台最新上线的官方模型与定价表实拍截图:
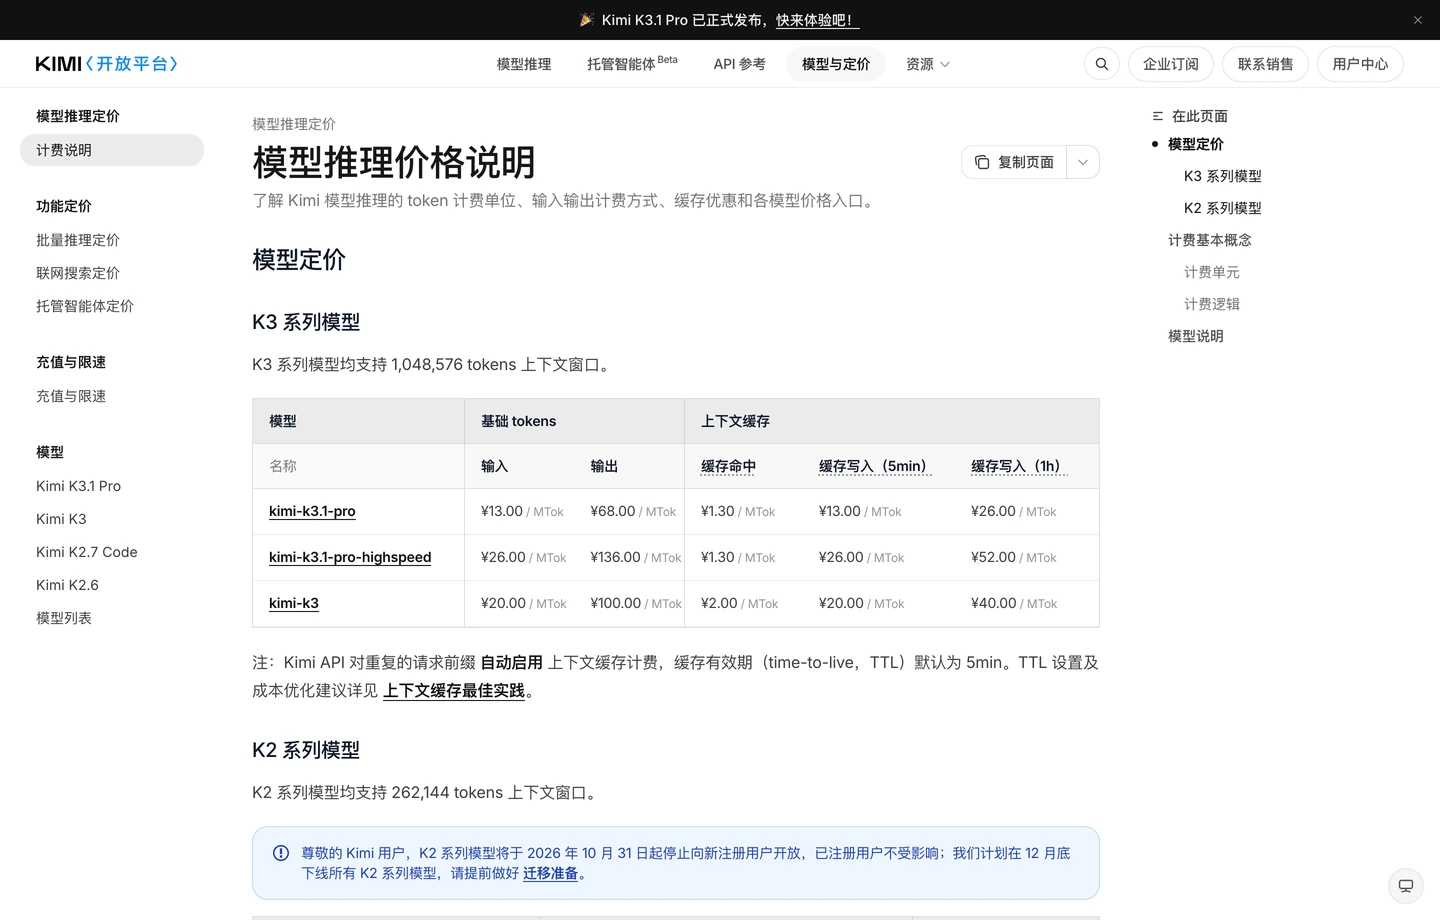
初看这张表,很多人会被 kimi-k3.1-pro-highspeed 的字面价格吓退:「标准版输入 ¥13/MTok、输出 ¥68/MTok;Highspeed 输入 ¥26/MTok、输出 ¥136/MTok,这不是整整贵了一倍吗?」
请把目光移到表格中间的「上下文缓存命中(Cache Hit)」那一列:
kimi-k3.1-pro缓存命中价:¥1.30 / MTok(海外站$0.20 / MTok)kimi-k3.1-pro-highspeed缓存命中价:同样是¥1.30 / MTok(海外站$0.20 / MTok)!
这行数字到底意味着什么?我们用「去文印店复印一本 500 页的厚字典」来打比方:
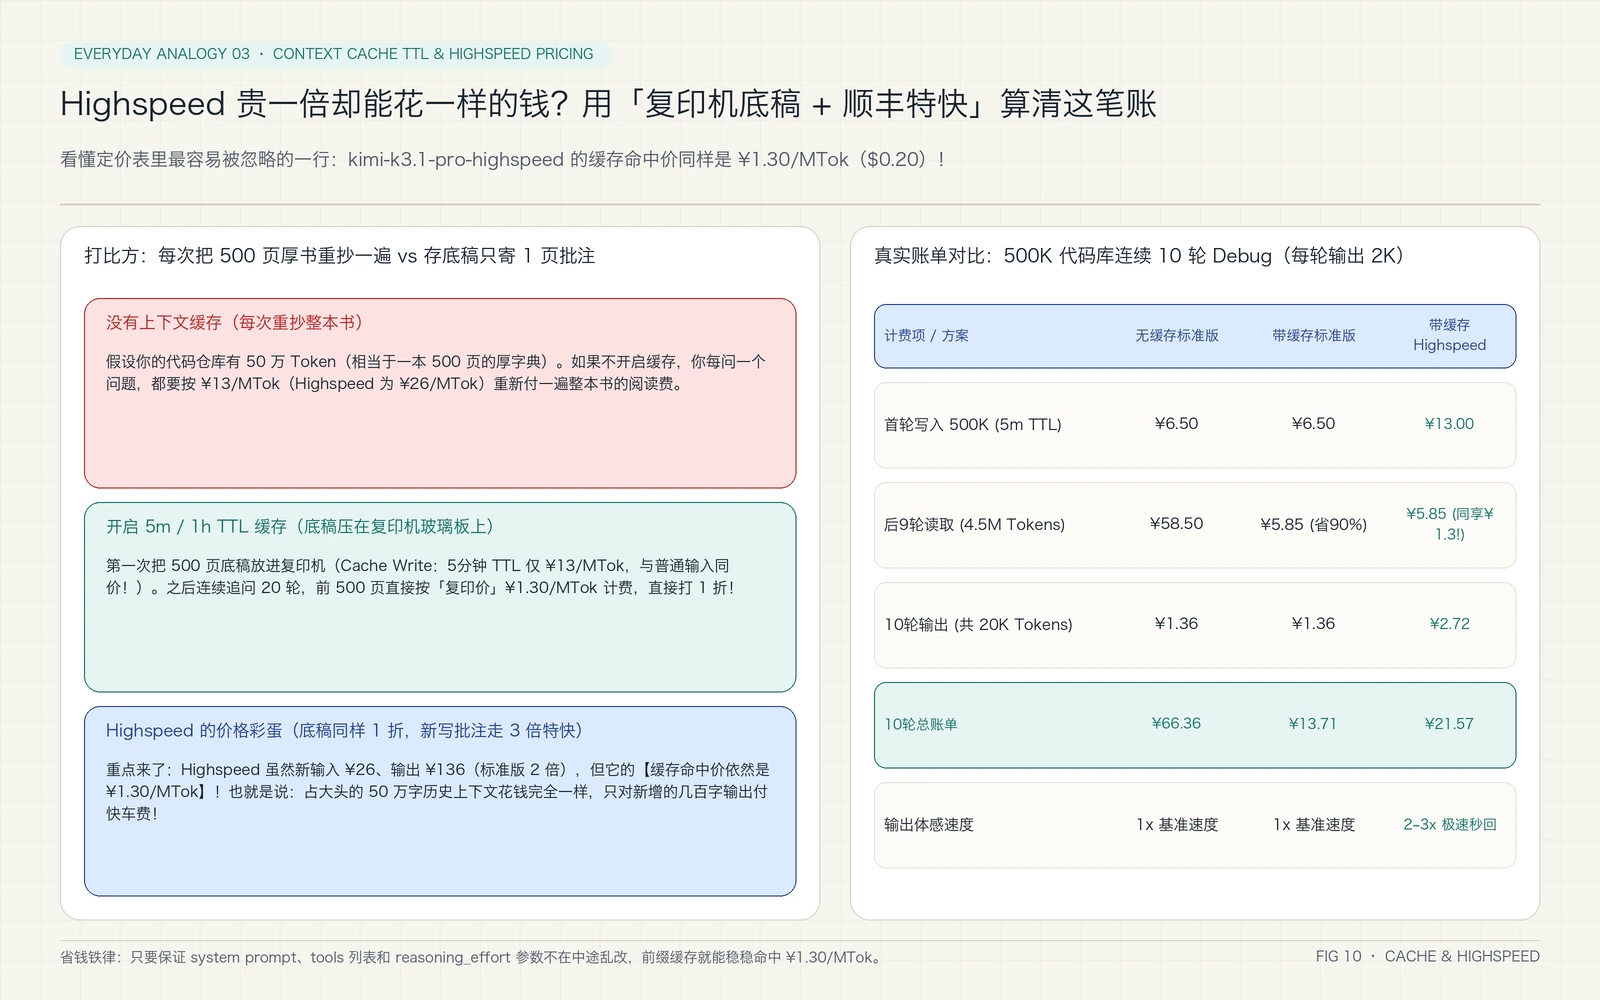
- 平时我们用 Claude Code 或 Codex 改一个大型代码仓库,系统提示词加上已经读进来的几十个源码文件,动辄就有 50 万 Token(相当于一本 500 页的厚字典),而你每一轮新敲进去的指令和模型新写的补丁,往往只有 1,000 到 2,000 Token(相当于 1 页纸的便签)。
- 如果不开缓存:就像你每问一个问题,都雇人把这 500 页厚字典从头到尾手抄一遍,每抄一遍收你
¥6.50(Highspeed 收¥13.00)。 - 开启 5 分钟或 1 小时 TTL 缓存后:第 1 轮相当于把这 500 页底稿平铺在复印机的玻璃板上(注意:5 分钟 TTL 的缓存写入费
Cache Write是¥13/MTok,跟普通输入一分钱差价都没有!)。从第 2 轮到第 20 轮,那 500 页底稿根本不用重抄,直接按一下复印键,每 100 万 Token 只收¥1.30(打 1 折)! - 最爽的地方来了:哪怕你切到 2~3 倍极速的
kimi-k3.1-pro-highspeed,复印机玻璃板上那 500 页底稿的「复印费」依然是¥1.30/MTok,跟标准版一模一样!你唯一多付的钱,仅仅是模型新写出来的那 1 页纸便签走了「顺丰特快专递」(输出从¥68变成¥136/MTok,2000 Token 只多花¥0.13毛钱),却换来了整个结对编程过程秒回的丝滑体感!
我们把国内站(platform.kimi.com)与国际站(platform.kimi.ai)的完整价格整理成对照表,方便随时查阅:
| 模型 ID | 适用区域 | 未命中输入 (每百万 Token) | 缓存命中 (每百万 Token) | 缓存写入 5m TTL | 缓存写入 1h TTL | 输出单价 (每百万 Token) | 输出速度 |
|---|---|---|---|---|---|---|---|
kimi-k3.1-pro |
国内站 (CNY) | ¥13.00 |
¥1.30 |
¥13.00 |
¥26.00 |
¥68.00 |
1x 基准 |
kimi-k3.1-pro-highspeed |
国内站 (CNY) | ¥26.00 |
¥1.30 (同价!) |
¥26.00 |
¥52.00 |
¥136.00 |
2~3x 极速 |
kimi-k3.1-pro |
国际站 (USD) | $2.00 |
$0.20 |
$2.00 |
$4.00 |
$10.00 |
1x 基准 |
kimi-k3.1-pro-highspeed |
国际站 (USD) | $4.00 |
$0.20 (同价!) |
$4.00 |
$8.00 |
$20.00 |
2~3x 极速 |
kimi-k3 (上一代对照) |
国内 / 国际 | ¥20.00 / $3.00 |
¥2.00 / $0.30 |
¥20.00 / $3.00 |
¥40.00 / $6.00 |
¥100.00 / $15.00 |
1x 基准 |
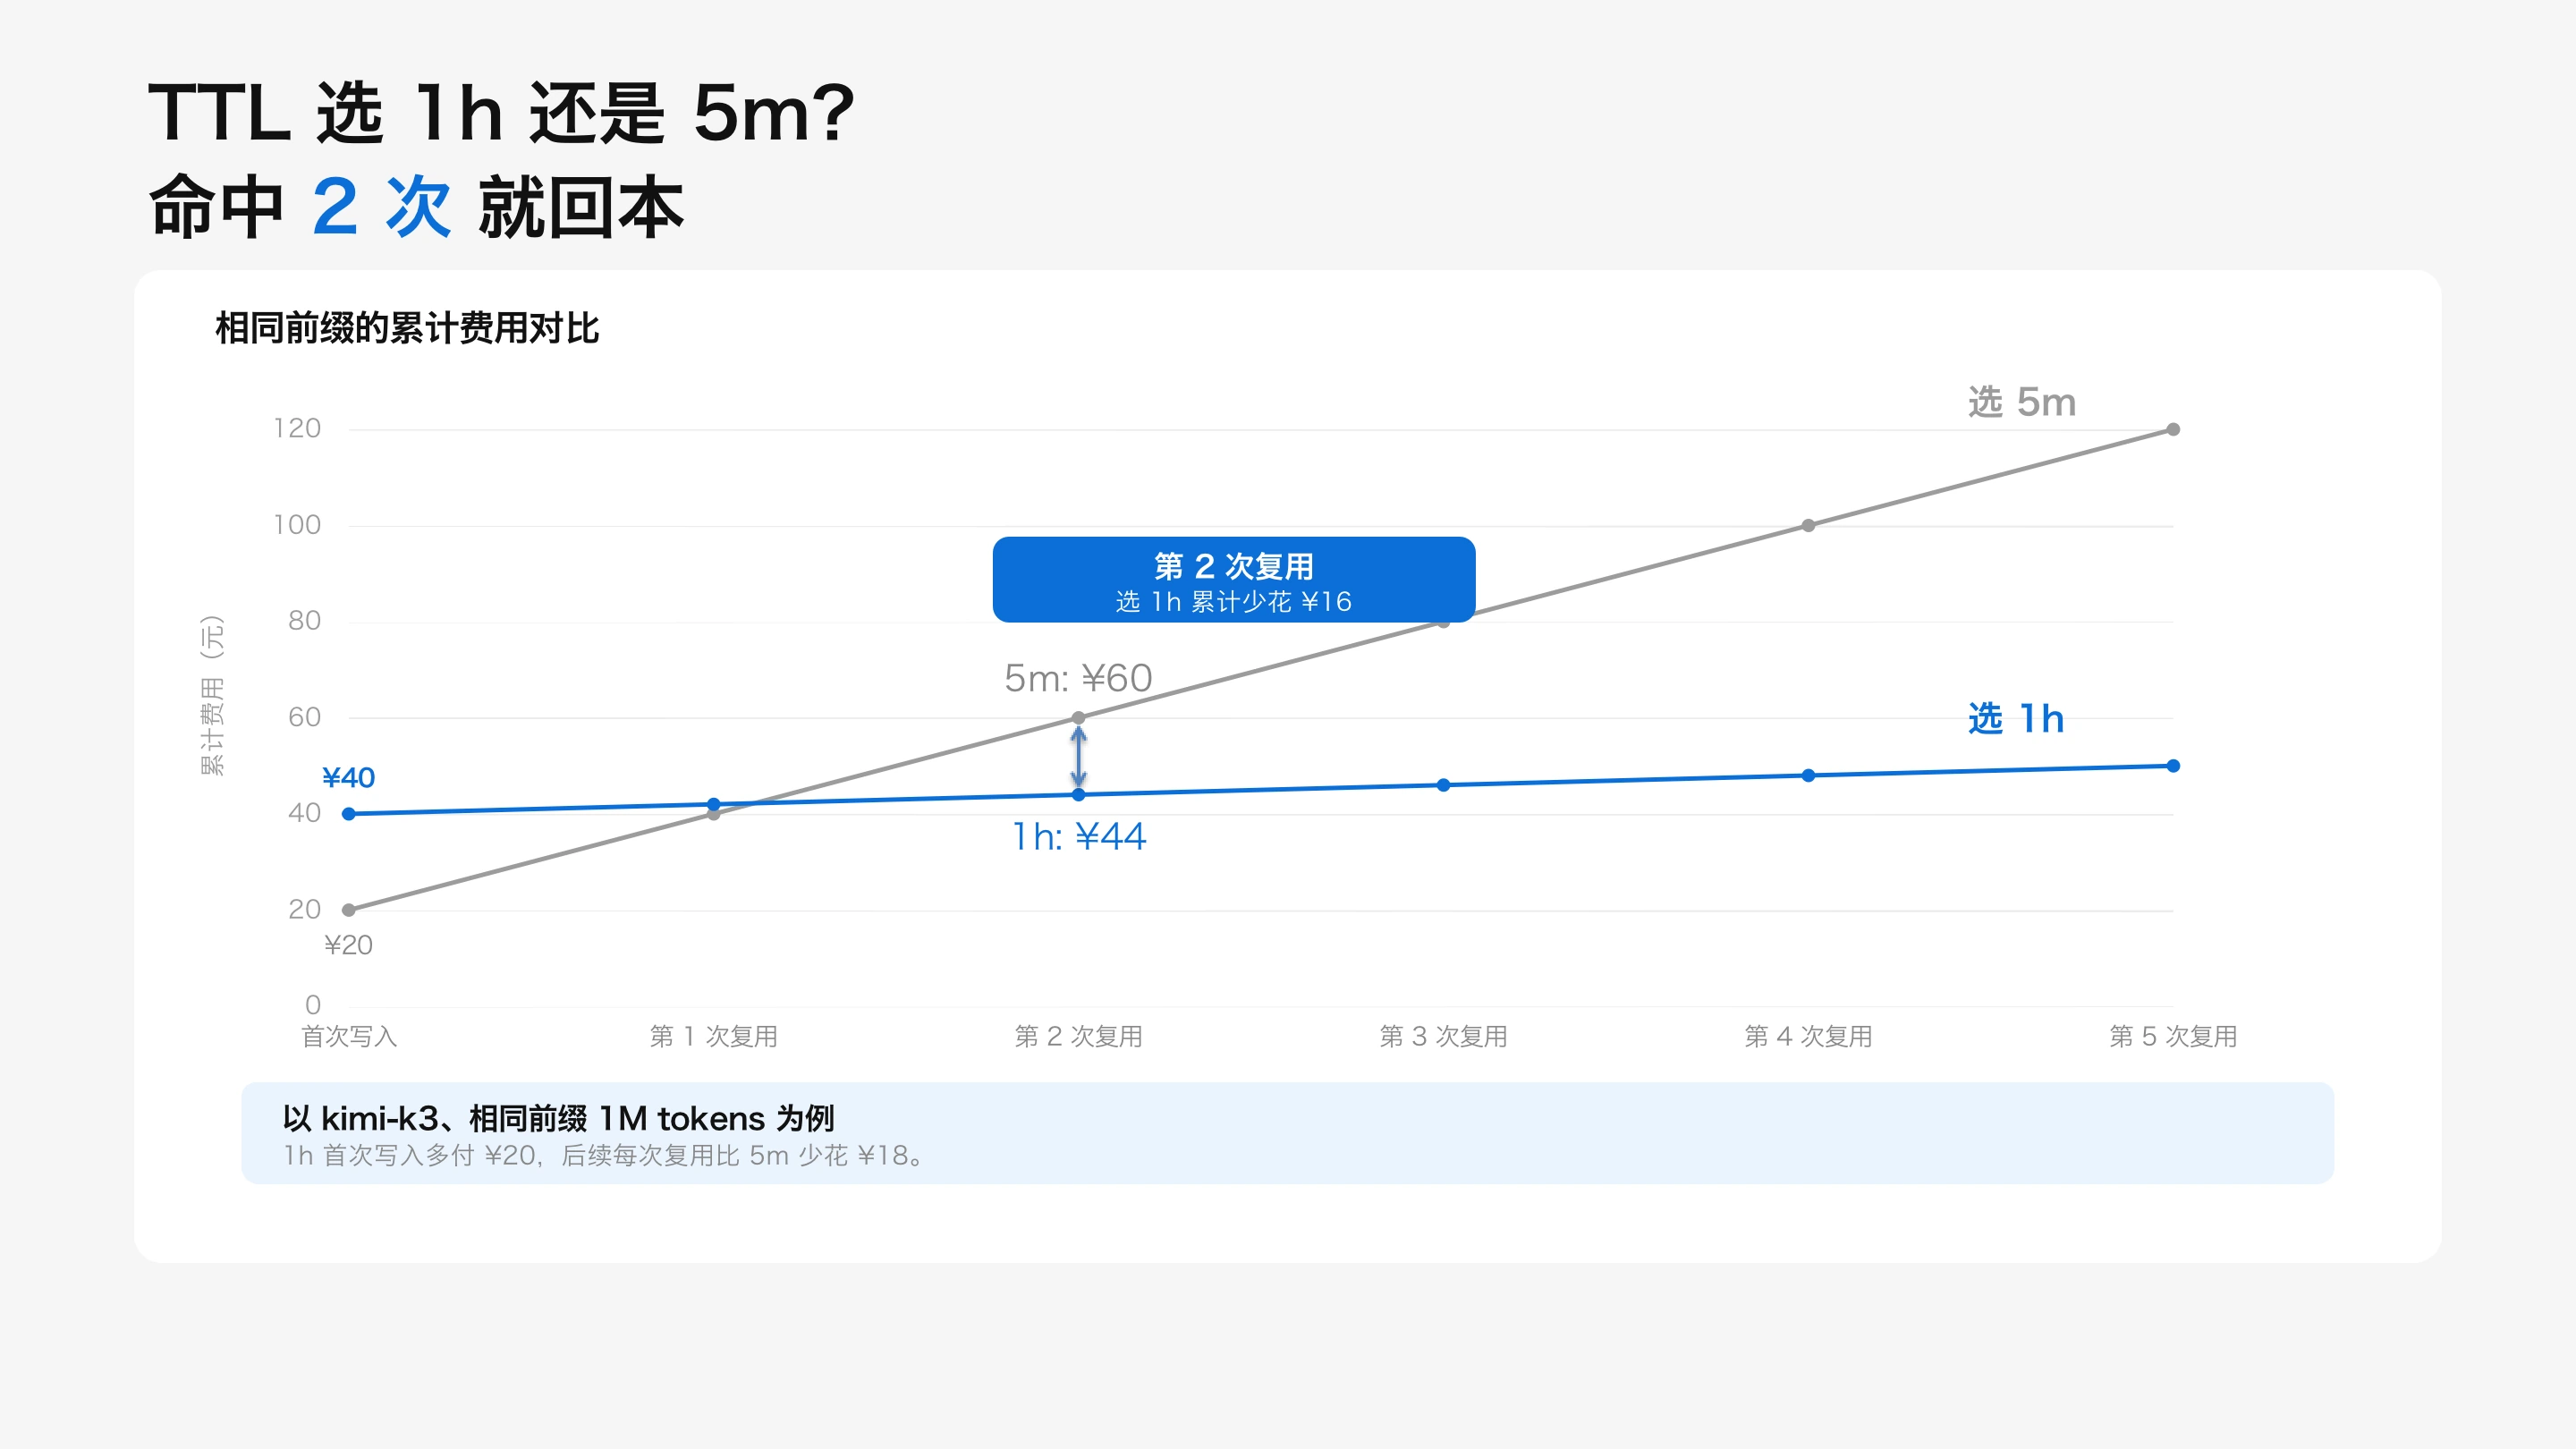
官方关于 1M 上下文与 TTL 缓存的文档也明确标注了 prompt_Cache_ttl 的用法与响应体里的 cached_tokens 核对方式:
四、问题根因:K2 升级 K3.1 Pro 七大故障的底层协议拆解
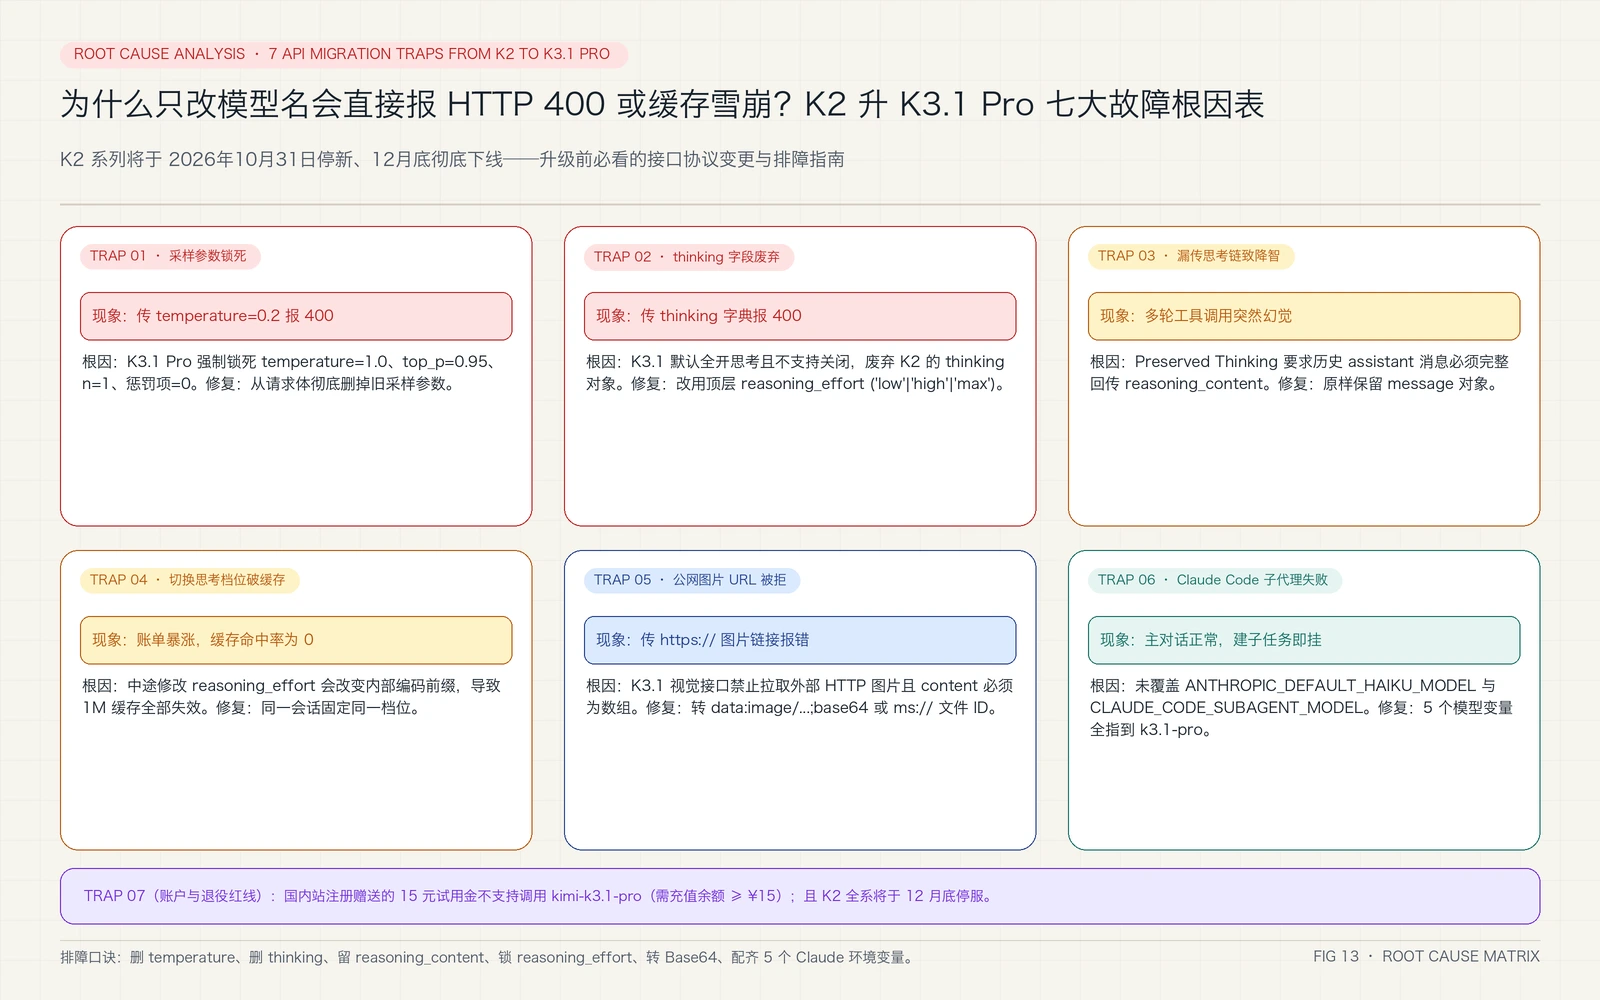
为什么很多老代码一换上 kimi-k3.1-pro 就会报错或者缓存失效?我们把官方接口协议的底层变更拆解成了七张根因卡片:
生活打比方四:自动挡 F1 赛车的「油门锁」与书桌上的「草稿便利贴」
为了让大家一眼记住上面这七个根因,我们再用两个小比方把最容易踩坑的前四条串起来:
- 根因一与二(锁死采样参数 + 移除
thinking开关 = 自动挡 F1 赛车的油门锁): 在 K2 时代,模型像一辆手动挡老轿车,你可以自己拧temperature=0.2调节油门灵敏度,也可以用thinking: {"type": "disabled"}把思考引擎关掉。但到了kimi-k3.1-pro,它的强化学习是在temperature = 1.0、top_p = 0.95、n = 1、presence_penalty = 0、frequency_penalty = 0的精确分布下联合调校出来的。如果你强行把temperature改到0.2,反而会破坏它内部上百步长程推理的探索树。因此官方干脆在网关层给这几个参数上了物理锁:只要请求体里传了不等于默认值的采样参数,或者传了旧版thinking字典,直接返回HTTP 400。唯一合法的思考调节旋钮是顶层字段reasoning_effort(支持"low"、"high"、"max"三档,不传时默认就是最高档"max")。 - 根因三与四(强制回传
reasoning_content+ 禁止中途切换reasoning_effort= 书桌上的草稿便利贴): K3.1 Pro 默认启用了保留思考链(Preserved Thinking)。这就好比一位数学家在解一道有 20 个步骤的奥数题,他每算完一步去翻工具书(调用 Tool)之前,都会在桌子上贴一张写满推导过程的「黄色草稿便利贴」(即接口返回的reasoning_content字段)。如果你在拼下一轮请求的messages数组时,为了省几行代码只把content和tool_calls塞回去,把reasoning_content弄丢了,就等于趁数学家转身查字典时把他的草稿纸全撕了——他转过头来当然会当场失忆!同理,如果你上一轮用reasoning_effort="max"存好了缓存前缀,下一轮突然改成"low",相当于把整本底稿的装订格式换了,前缀缓存会瞬间全部作废。 - 根因五(视觉接口拒绝公网 HTTP 图片 URL):
K3.1 Pro 的多模态接口出于安全与确定性考虑,不再替客户端去公网拉取
https://...图片链接,且要求带图片的content字段必须是对象数组。本地图片必须转成data:image/jpeg;base64,...(或先通过文件接口上传拿到ms://<file-id>)。 - 根因六(Claude Code 的 5 个模型变量与
.claude/settings.json优先级陷阱): 很多开发者只在终端里export ANTHROPIC_MODEL="kimi-k3.1-pro",却不知道 Claude Code 在派发子任务(Subagent)和后台轻量任务时,默认去读ANTHROPIC_DEFAULT_HAIKU_MODEL和CLAUDE_CODE_SUBAGENT_MODEL;更隐蔽的是,只要~/.claude/settings.json里存在旧配置,它会直接覆盖掉你终端里的export! - 根因七(国内站 15 元注册试用金限制与 K2 退役时间窗):
国内站新注册赠送的 15 元体验金不支持调用
kimi-k3.1-pro和kimi-k3.1-pro-highspeed(需账户充值余额满 15 元即可解锁);同时请务必在 2026 年 12 月底 K2 系列彻底关停前完成迁移。
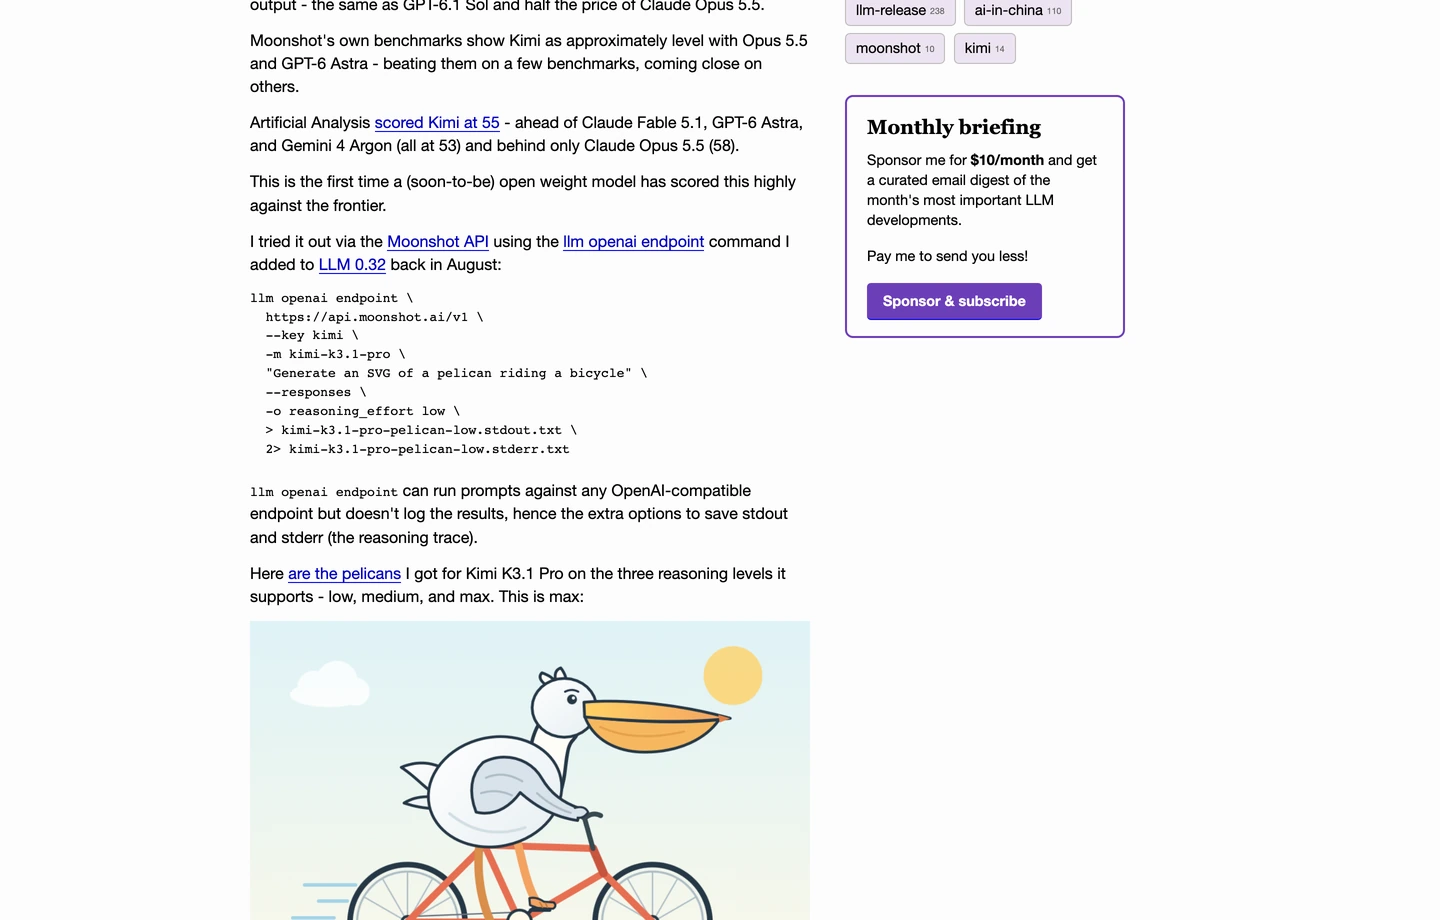
顺便一提,海外著名独立开发者 Simon Willison 也在发布当天第一时间用他的经典「鹈鹕骑自行车(Pelican riding a bicycle)」SVG 测试了 Kimi K3.1 Pro,并盛赞其为目前开源权重阵营的顶级梯队(Top Tier):
五、如何解决问题:三系统零依赖一键全自动脚本(人工执行 + Agent 自动配置)
清楚了所有报错根因后,我们不需要靠肉眼去翻几百个代码文件,也不用手动去改容易写错括号的 JSON 和 TOML 配置文件。
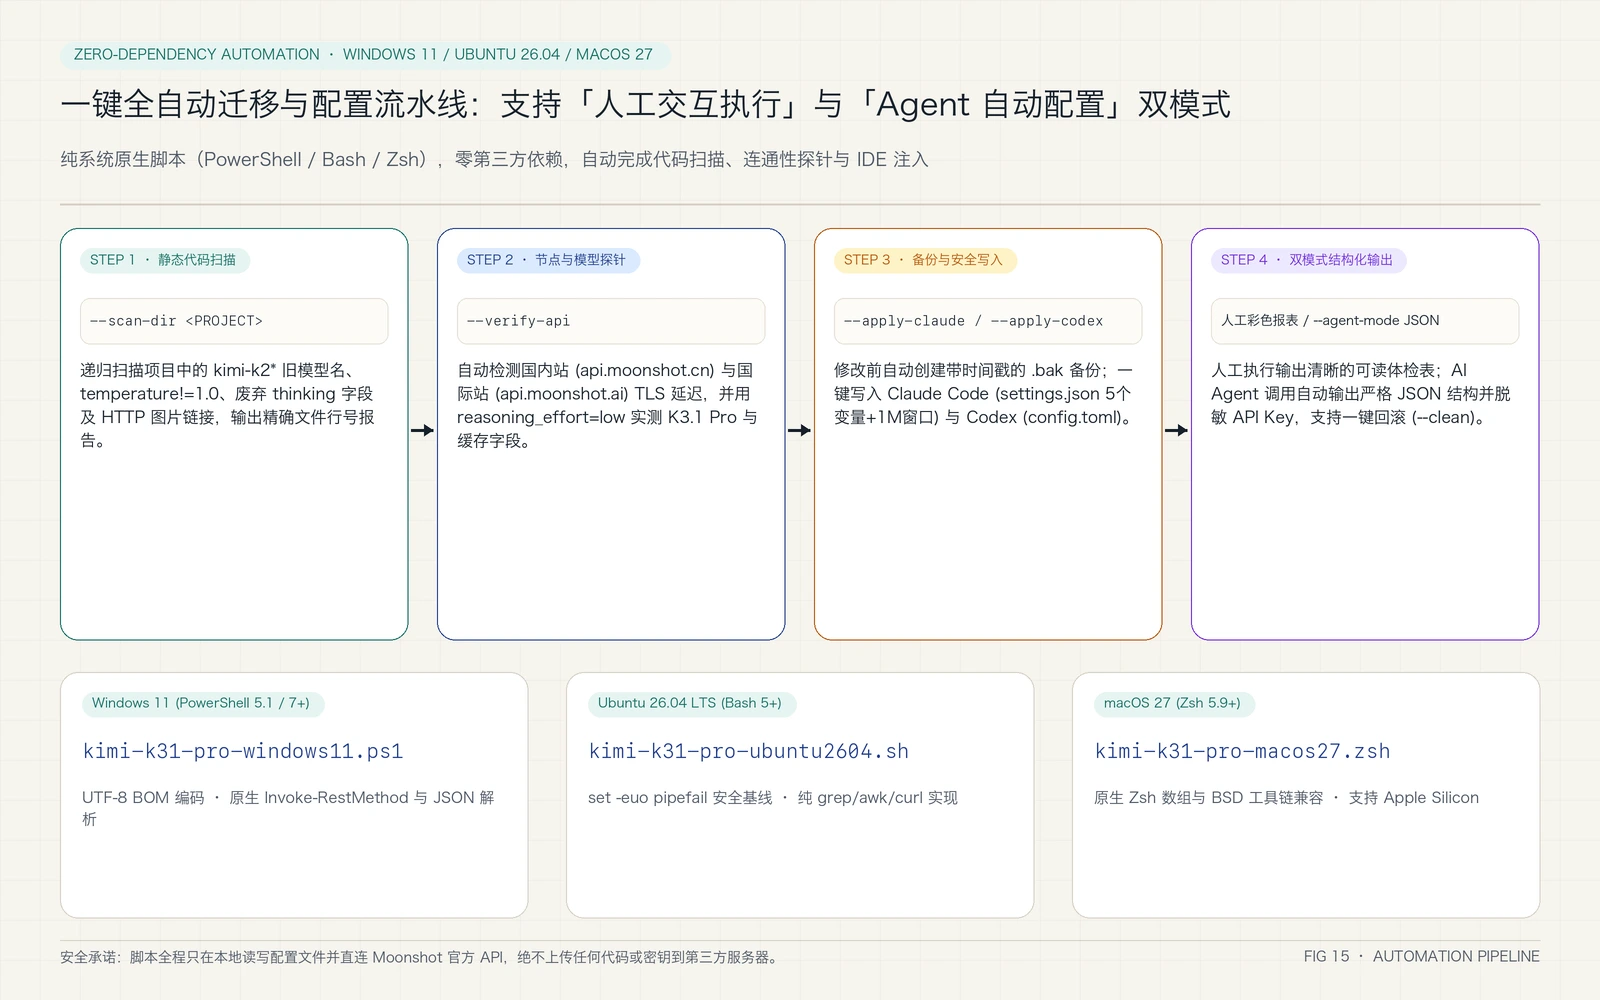
我专门编写了一套完全不依赖任何第三方库、只用操作系统原生工具链即可运行的跨平台一键迁移与配置脚本,全面覆盖 Windows 11(PowerShell)、Ubuntu 26.04(Bash)和 macOS 27(Zsh),并且同时支持「人工交互执行」和「AI Agent 自动配置(--agent-mode)」两种方法。
脚本核心能力与下载清单
这套脚本在本地一次性帮你完成四件事:
- 静态代码排雷(
--scan-dir):自动递归扫描你的项目源码,精准揪出残留的kimi-k2*/moonshot-v1*模型名、不等于1.0的temperature参数、废弃的thinking字典以及公网 HTTPimage_url。 - 节点连通性与真机探针(
--verify-api):自动测量当前机器到国内站(api.moonshot.cn)或国际站(api.moonshot.ai)的 TLS 握手延迟;如果传入了 API Key,还会用最小开销的reasoning_effort="low"发一次真实请求验证kimi-k3.1-pro或kimi-k3.1-pro-highspeed可用性。 - 原子备份与配置注入(
--apply-claude/--apply-codex):修改前自动生成带时间戳的.bak备份文件,随后将全套 5 个 Claude Code 模型环境变量 +1000000自动压缩窗口写入~/.claude/settings.json,并将wire_api = "responses"与1048576上下文窗口写入~/.codex/config.toml。 - 一键无损回滚(
--clean):随时恢复到修改前的最新备份。
你可以直接下载打包好的工具包或单文件脚本:
- 完整工具包(含三系统脚本、Agent 指令单与校验文件):
kimi-k31-pro-toolkit.zip - Windows 11 原生脚本(PowerShell 5.1 / 7+,UTF-8 BOM):
kimi-k31-pro-windows11.ps1 - Ubuntu 26.04 原生脚本(Bash 5+,
set -euo pipefail):kimi-k31-pro-ubuntu2604.sh - macOS 27 原生脚本(Zsh 5.9+,原生支持 Apple Silicon):
kimi-k31-pro-macos27.zsh - Agent 自动执行清单:
AGENT-INSTRUCTIONS.txt - SHA-256 完整性校验表:
SHA256SUMS.txt
方法一:人工一键全自动执行(适合开发者自己动手)
无论你用的是哪套操作系统,打开终端复制下面对应的一行命令即可完成「项目代码扫描 + 节点探针 + Claude Code 与 Codex 一键配置」。
1. Windows 11(PowerShell 5.1 / PowerShell 7+)
打开 PowerShell,设置好你的 MOONSHOT_API_KEY 后直接运行:
$env:MOONSHOT_API_KEY = "sk-你的真实Key"
Invoke-WebRequest -Uri "https://blog.margrop.net/downloads/kimi-k3-1-pro/kimi-k31-pro-windows11.ps1" -OutFile "kimi-k31-pro-windows11.ps1"
powershell -ExecutionPolicy Bypass -File .\kimi-k31-pro-windows11.ps1 -Model kimi-k3.1-pro-highspeed -Region cn -ScanDir . -VerifyApi -ApplyClaude -ApplyCodex
如果你想查看完整的 Windows 11 脚本源码,也可以直接保存以下内容为 kimi-k31-pro-windows11.ps1:
[CmdletBinding()]
param(
    [ValidateSet("kimi-k3.1-pro", "kimi-k3.1-pro-highspeed")]
    [string]$Model = "kimi-k3.1-pro",
    [ValidateSet("cn", "global")]
    [string]$Region = "cn",
    [string]$ApiKey = $env:MOONSHOT_API_KEY,
    [string]$ScanDir = "",
    [switch]$VerifyApi,
    [switch]$ApplyClaude,
    [switch]$ApplyCodex,
    [switch]$Clean,
    [switch]$AgentMode
)
$ErrorActionPreference = "Stop"
$BaseHost = if ($Region -eq "global") { "api.moonshot.ai" } else { "api.moonshot.cn" }
$OpenAiBase = "https://$BaseHost/v1"
$AnthropicBase = "https://$BaseHost/anthropic"
$Timestamp = Get-Date -Format "yyyyMMdd-HHmmss"
2. Ubuntu 26.04 LTS(Bash 5+)
在 Ubuntu 26.04 终端中执行:
export MOONSHOT_API_KEY="sk-你的真实Key"
curl -fsSL https://blog.margrop.net/downloads/kimi-k3-1-pro/kimi-k31-pro-ubuntu2604.sh -o kimi-k31-pro-ubuntu2604.sh
bash kimi-k31-pro-ubuntu2604.sh --model kimi-k3.1-pro-highspeed --region cn --scan-dir . --verify-api --apply-claude --apply-codex
3. macOS 27(Zsh 5.9+)
在 macOS 27 终端中执行:
export MOONSHOT_API_KEY="sk-你的真实Key"
curl -fsSL https://blog.margrop.net/downloads/kimi-k3-1-pro/kimi-k31-pro-macos27.zsh -o kimi-k31-pro-macos27.zsh
zsh kimi-k31-pro-macos27.zsh --model kimi-k3.1-pro-highspeed --region cn --scan-dir . --verify-api --apply-claude --apply-codex
如果后续你想一键回滚到修改前的原始配置,只需要加上 --clean(Windows 下为 -Clean):
zsh kimi-k31-pro-macos27.zsh --clean
方法二:交给 AI Agent 全自动配置(适合 Claude Code / Codex / Cursor / OpenClaw)
如果你不想自己记命令行参数,可以直接把下面这段「Agent 自动执行任务单」复制粘贴给你的本地编程 Agent(如 Claude Code、Codex CLI、Cursor Agent 或 OpenClaw)。脚本内置的 --agent-mode 会输出严格的单行脱敏 JSON,方便 Agent 自动判断哪些代码文件需要重构:
请帮我将当前开发环境与项目迁移至 Kimi K3.1 Pro / Highspeed:
1. 先读取并遵循 https://blog.margrop.net/downloads/kimi-k3-1-pro/AGENT-INSTRUCTIONS.txt 中的操作规范,核对 SHA256SUMS.txt。
2. 根据当前宿主操作系统下载对应脚本(Windows 11 用 kimi-k31-pro-windows11.ps1,Ubuntu 26.04 用 kimi-k31-pro-ubuntu2604.sh,macOS 27 用 kimi-k31-pro-macos27.zsh)。
3. 以 Agent JSON 模式运行脚本(开启 --scan-dir . --verify-api --apply-claude --apply-codex --agent-mode,模型选 kimi-k3.1-pro-highspeed)。
4. 解析脚本输出的单行 JSON:如果 scan 字段中发现旧版 kimi-k2 模型名、非 1.0 的 temperature 或废弃的 thinking 字典,请自动帮我把对应代码文件重构为符合 Kimi K3.1 Pro 规范的写法(使用顶层 reasoning_effort,并在多轮工具调用中完整保留 assistant 消息的 reasoning_content)。
Agent 执行完毕后,会收到类似下面这样干净、且已对 API Key 自动脱敏的结构化 JSON 响应:
{"status":"ok","os":"macos-27","model":"kimi-k3.1-pro-highspeed","region":"cn","endpoint":"api.moonshot.cn","api_key_masked":"sk-abc...9f2a","scan":{"k2_model_hits":0,"locked_temperature_hits":0,"deprecated_thinking_hits":0,"http_image_url_hits":0},"probe":{"http_code":"200","latency_ms":218,"live_api_status":"ok"},"config":{"claude_code":"configured","codex_cli":"configured"}}
附:Python / TypeScript 标准调用范式(含 Preserved Thinking 与缓存命中核验)
如果你的业务代码直接用 OpenAI SDK 调 Kimi K3.1 Pro,请务必参考下面这份符合 K3.1 规范的最小标准模板(注意:不传 temperature,使用顶层 reasoning_effort,并在多轮工具调用中直接把整个 assistant 消息对象原样追加回 messages 列表,从而自动保留 reasoning_content):
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["MOONSHOT_API_KEY"],
    base_url="https://api.moonshot.cn/v1",  # 国际站请用 https://api.moonshot.ai/v1
)

messages = [
    {"role": "system", "content": "你是一名严谨的系统架构师,擅长排查并发与内存问题。"},
    {"role": "user", "content": "请帮我设计一个探针脚本,区分是业务逻辑死锁还是数据库连接池耗尽。"},
]

response = client.chat.completions.create(
    model="kimi-k3.1-pro-highspeed",
    messages=messages,
    reasoning_effort="high",  # 可选 "low" | "high" | "max"(默认 "max"),同一会话内切勿频繁变动以保住缓存
    max_tokens=16000,
)

msg = response.choices[0].message
print("思考过程摘要:", getattr(msg, "reasoning_content", "")[:120])
print("最终回答:", msg.content)

# 关键一步:多轮对话或工具调用时,直接追加完整 msg 对象,切勿丢弃 reasoning_content!
messages.append(msg)

# 核验上下文缓存命中情况(命中部分在 Highspeed 与标准版下均仅需 ¥1.30 / MTok)
usage = response.usage
print("本次 Prompt Tokens:", usage.prompt_tokens, "其中缓存命中:", getattr(usage, "cached_tokens", 0))
六、选型建议与常见问题解答(Q&A)
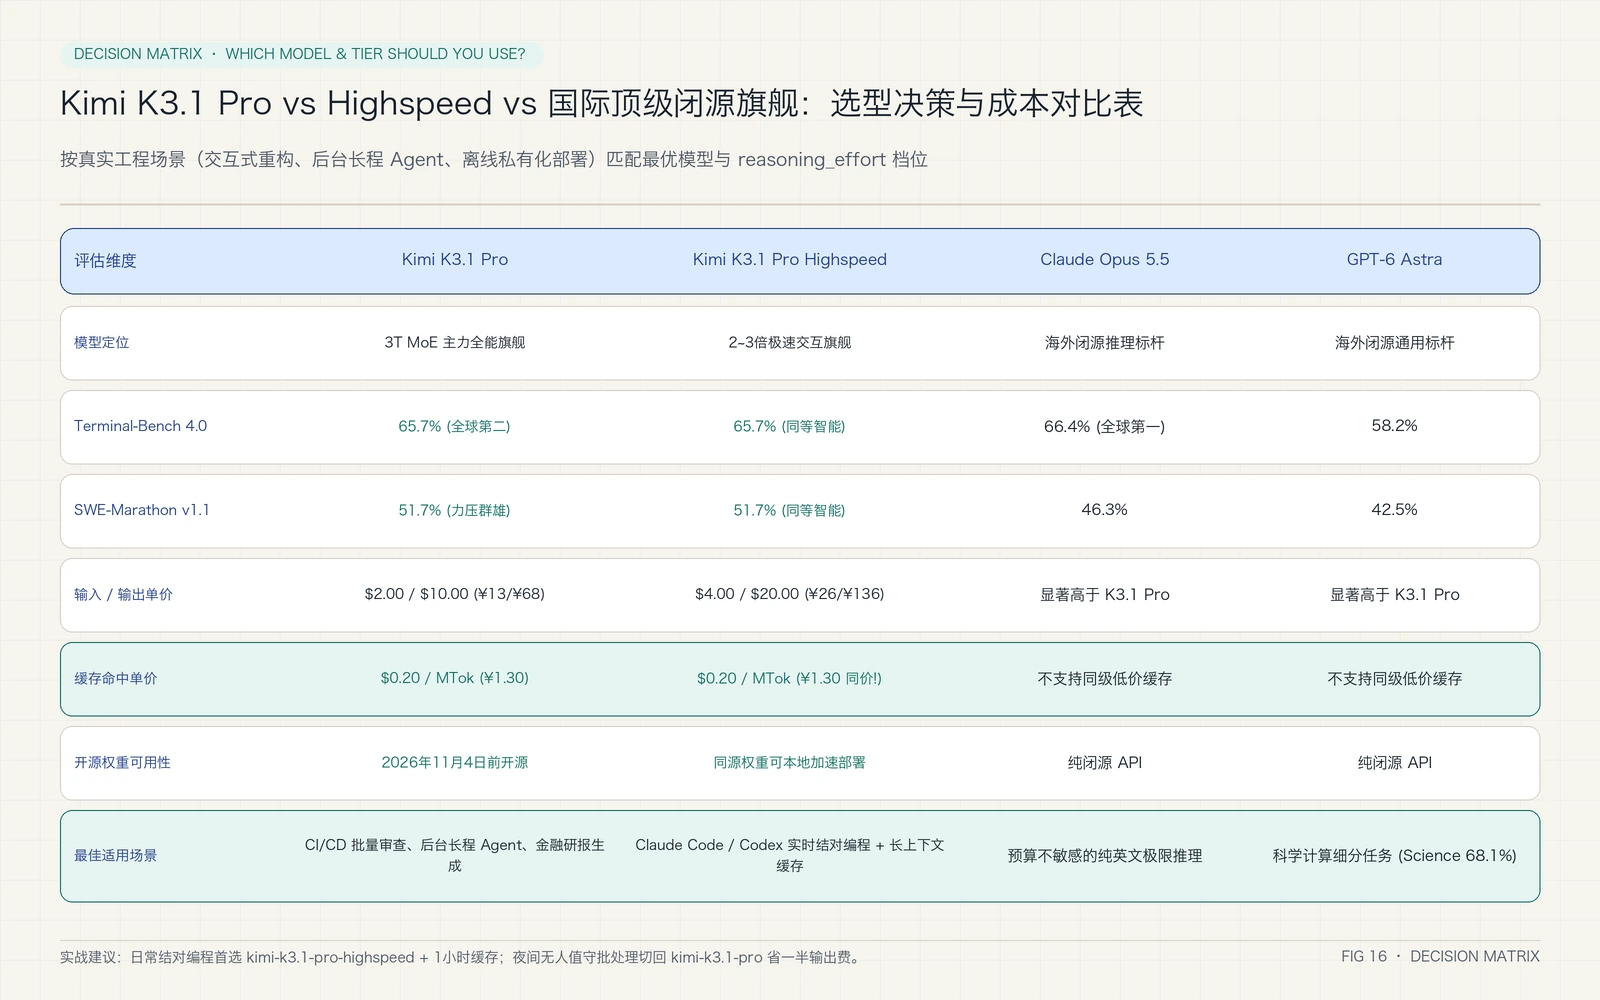
为了方便你在日常结对编程、CI/CD 批量代码审查和私有化开源部署之间快速拍板,我们先看这张全维度选型决策矩阵图:
Q1:kimi-k3.1-pro 和 kimi-k3.1-pro-highspeed 的智商有差别吗?我平时写代码到底选哪个?
没有任何智商差别。官方明确说明两者共享完全一致的 3 万亿级模型底层能力,唯一的区别是 kimi-k3.1-pro-highspeed 的流式输出速度提升了 2 到 3 倍。
- 如果你在用 Claude Code、Codex CLI 或 Cursor 盯着屏幕实时结对编程:强烈建议直接选
kimi-k3.1-pro-highspeed并配合上下文缓存。因为reasoning_effort="max"会产生较长的思考链,3 倍输出速度能把等待时间从几十秒压缩到十来秒,而且占大头的历史仓库前缀缓存命中价同样是¥1.30/MTok($0.20/MTok)。 - 如果你在跑夜间无人值守的 CI/CD 代码审计、批量研报生成或大规模评测:建议选标准版
kimi-k3.1-pro,直接省下一半的新增输入与输出 Token 费用。
Q2:11 月 4 日开源的权重,个人电脑或者单机显卡能跑起来吗?
kimi-k3.1-pro 是 2.8 万亿总参数、1040 亿激活参数的超大 MoE 模型。即使用 INT4 量化,完整权重也需要约 1.4TB 显存/统一内存(例如两台 8 卡 H200 / B200 节点,或者多台 512GB 统一内存的顶配 Mac Studio 集群做专家卸载推理)。对于绝大多数中小团队和个人开发者,直接调官方 API 并吃满 ¥1.30/MTok 的 1 折缓存,在未来很长一段时间内都比自己买卡划算得多;而对于有严格数据不出域要求的金融、政企与安全团队,11 月 4 日的完整开源权重则是目前全球唯一能对标 Opus 5.5 编码能力的私有化底座。
Q3:为什么我已经往账户里充了钱,但在 Claude Code 里还是偶尔报 400 错误?
请按下面三步自检(或者直接跑一遍上文提供的一键脚本):
- 检查
~/.claude/settings.json是否把 5 个模型变量(尤其是ANTHROPIC_DEFAULT_HAIKU_MODEL和CLAUDE_CODE_SUBAGENT_MODEL)全部指向了kimi-k3.1-pro或kimi-k3.1-pro-highspeed。 - 检查是否设置了
"ENABLE_TOOL_SEARCH": "false"和"CLAUDE_CODE_AUTO_COMPACT_WINDOW": "1000000"。 - 检查你的中间层网关(比如自建的 OneAPI / NewAPI / LiteLLM)有没有在转发请求时偷偷注入默认的
temperature: 0.7。如果有,请在网关侧开启「移除不支持的采样参数」或直连https://api.moonshot.cn/anthropic。
Q4:K2 系列下线前,我必须改完所有老项目吗?
是的。根据官方公告,K2 系列模型(包括 kimi-k2.6、kimi-k2.7-code、kimi-k2-thinking)将于 2026 年 10 月 31 日停止向新用户开放,并于 2026 年 12 月底正式退役下线。趁现在还有两个月窗口期,用上面的 --scan-dir 脚本扫一遍所有仓库,把采样参数和 reasoning_content 回传逻辑一次性理顺,既能立省三分之一的 API 账单,又能稳稳接住 3 万亿参数旗舰带来的长程 Agent 红利。
写在最后:致敬 1024 程序员节,把枯燥的排障留给脚本
每年 10 月 24 日,大家都会调侃程序员的格子衫、咖啡和修不完的 Bug。但今年 1024 程序员节前夜发布的 kimi-k3.1-pro 和 kimi-k3.1-pro-highspeed,连同那个恰好等于 1024 × 1024(1,048,576)的百万上下文窗口、在 296 块骨头仿真器里自己写探针抓出 36 个底层力臂 Bug 的工程直觉,以及即将于 11 月 4 日兑现的完整开源权重,确实让我们看到了 AI 编程助手从「补全几行代码片段」走向「独立跑完上百步系统工程闭环」的质变。
祝各位开发者 1024 程序员节快乐——愿你的每一次请求都稳稳命中 ¥1.30/MTok 的 1 折缓存,愿你的每一个子代理都不再报 HTTP 400,把枯燥的迁移与排障交给一键脚本,早点合上电脑去享受属于自己的节日!