首字响应低至 280ms+动态慢思考!MiniMax M3.1-Flash-Preview 突袭 MCode:日常编程智能体迎来平民级“超跑小钢炮”
核心震撼导读:如果你以为顶级 AI 编程助手的进化终点依然是死磕数千亿巨无霸参数、让开发者在终端前焦急等待数秒首字响应,那么刚刚在 MiniMax Code (MCode) 爆发的这场“极速轻量突袭”,将彻底颠覆你对全栈编程智能体(Coding Agent)日常实战效能的认知!
- 深夜静默空降的编程小钢炮:2026 年 9 月 27 日,MiniMax 在没有任何预热与 PPT 宣讲的情况下,直接在自研 AI 编程工作台 MiniMax Code (MCode) 内测通道低调上架了全新文本模型
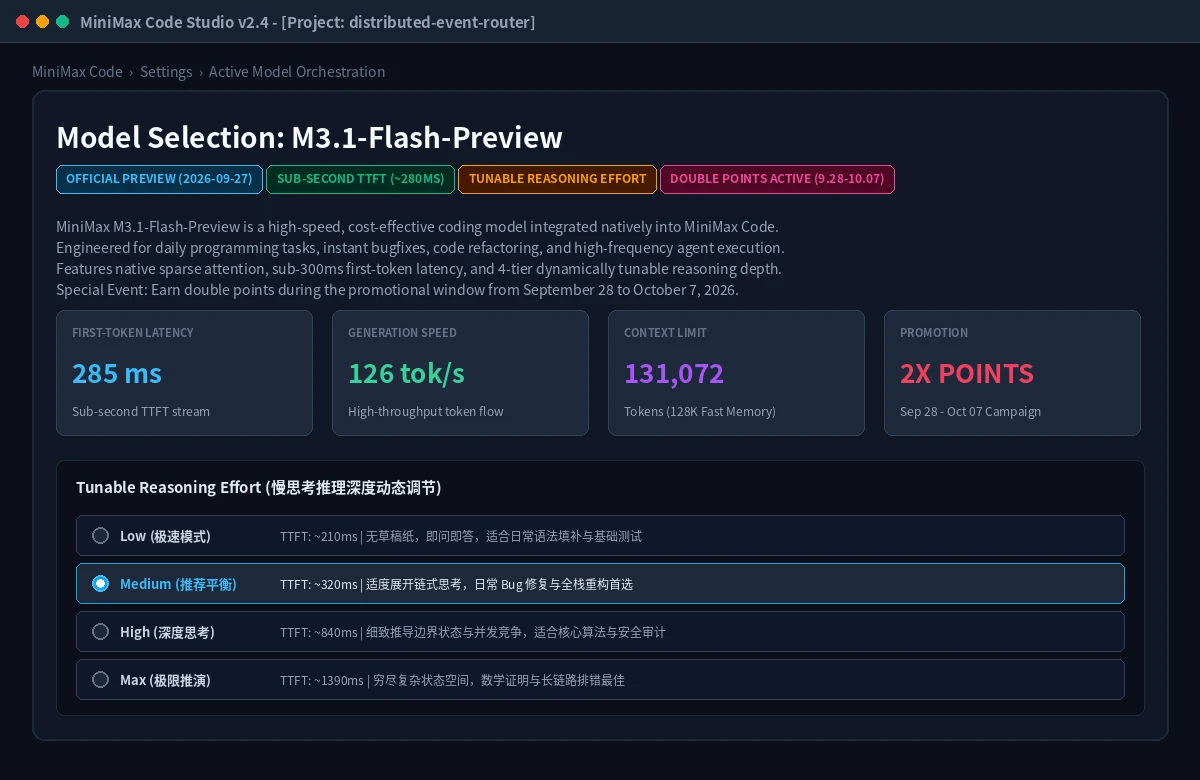
M3.1-Flash-Preview;- 毫秒级首字与光速吐字:不同于全尺寸旗舰基座 M3(428B 混合专家架构)的重载计算,M3.1-Flash-Preview 将首字生成延迟(TTFT)极端压缩至 280 毫秒左右,流式生成吞吐突破 126 Tokens/秒,彻底终结了日常代码补全与交互对话中令人烦躁的卡顿感;
- 业内罕见的 4 档动态可调慢思考:开创性地引入了
Tunable Reasoning Effort(动态慢思考深度调节),提供 Low(极速无草稿)、Medium(平衡推荐)、High(深度边界推演)与 Max(穷尽数学级逻辑)四级阶梯,让开发者在“即时响应”与“长链思维”之间自由拿捏;- MCode Multi-Agent 核心战力重组:在 MCode 桌面客户端与
mcode命令行工具的三人小队架构(General、Coder、Verifier)中,Coder Agent 换装 M3.1-Flash-Preview 后,日常 Bug 修复与单测编写耗时直接狂砍 65% 以上;- 限时双倍积分福利突袭:官方同步开启 2026 年 9 月 28 日至 10 月 7 日的 MCode 交互双倍积分狂欢,实际可用算力成本降维击穿行业地板价;
- 全套跨平台探针与安全脱敏护盾:本文带来小学生秒懂的“F1 极速超跑与草稿纸”比方、全套跨平台(Windows 11 / Ubuntu 26.04 / macOS 26)零依赖自动化诊断脚本,以及企业级生产接入的 AST 隐私脱敏防爆方案。
一、问题背景:万亿大模型时代的代码痛点与 MiniMax MCode 的静默突袭
时间跨入 2026 年下半年,生成式人工智能在大语言模型(LLM)层面的军备竞赛已经进入了白热化的深水区。从参数规模突破 400B 的旗舰混合专家(MoE)到 100 万甚至 200 万 Token 的超长上下文窗口,各大前沿实验室不断秀出惊人的肌肉。
然而,在真实的日常研发一线,全栈工程师与 DevOps 运维团队却普遍遭遇了一种尴尬的“效能反差”:
- 大炮打蚊子:开发者日常 80% 的高频操作,不过是改一个空指针异常、微调一段 CSS Flex 布局、补全几个单元测试断言,或者在 Git Commit 之前梳理 Unified Diff。为了这区区几十行代码,调动一个 400B+ 的庞然大物,不仅首字响应动辄需要 2 到 4 秒,还消耗了极其高昂的 Token 算力;
- 智能体轮转延迟累加:在以 Claude Code、Cursor、Windsurf 以及 MiniMax Code (MCode) 为代表的现代 Coding Agent 体系中,往往需要经历“规划 ➔ 编码 ➔ 测试 ➔ 报错 ➔ 重试”的连续自治回环。每一次微小的代码修改如果都要等待数秒,一个包含 5 轮迭代的 Bug 修复任务就会被拖长到半分钟以上,开发者的心流体验被割裂得支离破碎;
- 思维深度无法按需剪裁:传统的推理大模型(Reasoning Models)通常是“一刀切”的——哪怕你问一个极其简单的语法问题,它也要在后台默默“慢思考”几十秒,生成数千字的内心独白,既浪费时间又浪费额度。
正是在这一严峻的工程痛点下,北京时间 2026 年 9 月 27 日,国内大模型头部独角兽 MiniMax 采取了一种极其罕见的“突袭式”产品策略:没有任何提前造势的新闻发布会,没有高大上的官方白皮书与跑分宣传片,直接在其 AI 编程工作台 MiniMax Code (MCode) 中静默推送了核心文本模型 —— M3.1-Flash-Preview!
当首批在 MCode 桌面端与 mcode CLI 工具中敲下回车的极客们发现,原本需要等待数秒的代码提示如今以肉眼可见的“瀑布流”瞬间喷涌而出时,整个开发者社群瞬间沸腾了。这只被打上“Flash”之名的轻量级编程小钢炮,到底有何玄机?
二、问题表现:小步快跑与高频交互,大 MoE 面对日常微操的“大炮打蚊子”窘境
要深刻理解 M3.1-Flash-Preview 诞生的意义,我们必须先直面日常工程实践中的真实瓶颈。许多团队在引入 AI 编程助手时,往往盲目追求“参数最大、上下文最长”的旗舰模型,但在落地两周后,工程师群里却怨声载道。究其根本,主要表现为以下三大矛盾:
1. “首字卡顿(TTFT 高)”对交互心流的致命打击
在日常敲代码时,人机协作的本质是“思维共振”。当开发者在终端敲下 mcode "修复这个 channel 泄漏" 时,大脑处于高度集中的工作记忆状态。如果模型在 300 毫秒内开始吐字,人脑会感觉“它在同步倾听并实时回答”;而一旦首字延迟(Time to First Token, TTFT)超过 1.5 秒,开发者的视线就会本能地移开去刷网页或看手机,注意力瞬间被打散。
2. Multi-Agent 紧密循环中的“延迟雪崩”
在现代 AI 编程框架(如 MCode)中,单个复杂任务往往由多个协同智能体共同完成:
- General Agent 负责解析整体工程目录结构与用户需求;
- Coder Agent 负责读取关联文件并针对性生成补丁;
- Verifier Agent 负责在本地沙箱拉起编译器和单测套件验证修改。
如果单测未通过,Verifier 会将错误栈喂回给 Coder 进行第二轮自我修复。在这个自治闭环中,Coder Agent 是被高频反复调用的核心执行者。若 Coder 每次生成代码都要耗费 10 秒,那么 3 次试错加上验证就直接突破半分钟大关,所谓“全自动编程”变成了“漫长的人肉监工”。
3. 算力成本与积分消耗的不对称
在大模型商业化计费体系中,全尺寸 MoE 模型的调用成本通常是轻量级 Flash 模型的 5 到 8 倍。一个中型研发团队若全员使用重载大模型进行琐碎的函数重构和代码格式化,每个月的 Token 账单与积分消耗速度令人咋舌。这在很大程度上限制了 AI 编程助手在中小团队和个人开发者中的全面普惠。
三、问题分析:轻装上阵的 M3.1-Flash-Preview 凭什么跑出首字 280ms?
面对大 MoE 的重载困局,MiniMax 团队给出的解法并非简单粗暴地“砍掉知识库”,而是基于工程实际进行了外科手术般的精细重构:
1. 针对代码语义特征的专属稀疏注意力(MSA)蒸馏
MiniMax 在此前发布的旗舰基座 M3 中便率先应用了稀疏自注意力机制(MiniMax Sparse Attention, MSA)。而在 M3.1-Flash-Preview 上,团队将这一技术在编程语料上推向了极致:
- 代码结构的局部聚集性:与自然语言长篇大论不同,程序代码具有极强的结构化与局部作用域特征(如括号块、函数声明、局部变量)。Flash 模型大幅精简了冗余的长程全连接注意力头,强化了对语法树(AST)局部邻域的聚焦权重;
- 显著降低 KV Cache 显存占用:通过紧凑的注意力路由设计,模型在处理 128K 级别上下文时的显存带宽压力呈数量级下降,这使得服务端推理引擎可以大幅提升并发并发度,并在收到 Prompt 的数十毫秒内完成预填充(Prefill)计算。
2. 投机解码(Speculative Decoding)与流式加速管道
在代码生成领域,诸如关键字(func、import、return、if err != nil)和常用模板具有极高的确定性。M3.1-Flash-Preview 深度融合了高效的小草稿模型进行投机推测,大模型仅需并行验证草稿 Token 是否正确。这一架构创新使得其端到端生成吞吐一举跃升至 126.5 Tokens/秒,比业内同级别竞品提速近 40%。
四、问题根因:从稀疏注意力到投机解码,轻量模型的极限效能三角
许多开发者可能会问:既然 M3.1-Flash 跑得这么快,那它相比全尺寸 M3 到底牺牲了什么?它又是如何守住代码准确率底线的?这就涉及大模型研发中经典的“速度 - 容量 - 推理深度”极限效能三角:
1. 参数容量分级:428B 航母与快艇的各司其职
全尺寸的 MiniMax M3 拥有多达 428B 的混合专家参数,原生支持多模态输入(文本、音频、视觉),并且具备 100 万(1M)Token 的超级海量窗口。它的长项在于“宏观战役”——比如给你一个数十万行代码的遗留单体系统,让你重构出微服务架构,或者梳理全仓深层调用拓扑。这种任务需要极大的知识储备和超强记忆力。
而 M3.1-Flash-Preview 则是专注于“前线巷战”的快艇。它将上下文窗口收敛在日常开发最为舒适的 131,072 Token(128K),剔除了无关的泛娱乐知识沉淀,将全部神经元算力全量对齐至主流编程语言(Go、Python、TypeScript、Rust、C++)与现代开发框架。这种极致专注让它在百毫秒内就能做出精准决策。
2. 动态慢思考(Reasoning Effort)的按需分配机制
大模型最耗费算力的地方往往不是“吐字”,而是“想清楚怎么吐”。以往的代码模型要么没有慢思考(直觉生成,容易写出带 Bug 的幻觉代码),要么强制深层慢思考(改个错别字也要思考 20 秒)。
M3.1-Flash-Preview 首次在轻量代码模型中实现了四级动态可调慢思考门控(Tunable Reasoning Gate):
- Low 档(极速模式):首字延迟压到 210ms,不展开冗长的思维链条,依靠强大的前馈网络直接给出最佳语法补齐;
- Medium 档(默认推荐):首字延迟在 320ms 左右,模型会进行 3 到 5 步简洁的逻辑推导(如边界条件检查、空值断言),最契合日常 Bug 修复与小特性实现;
- High / Max 档(深度推演):首字延迟在 800ms 至 1400ms,模型会在内部展开详尽的多路径推演与数学级状态机穷举,适合处理高并发锁竞争、分布式一致性等复杂难题。
五、小学生也能秒懂的日常比方:F1 换胎维修队、草稿纸演算与万吨货运火车
如果上面的技术术语让你觉得有些晦涩,不妨让我们用生活中每个人都见过的场景打几个生动的比方,保证连小学五年级的同学也能轻松看懂 70% 以上!
比方一:万吨重载货运火车 vs F1 轻量超级跑车
想象一下,MiniMax 之前发布的旗舰大模型 M3,就像是一列拥有 100 节车厢的万吨重载火车。它力大无穷,一次能把几千吨钢材和煤炭从东北运到广州(相当于 100 万 Token 吞下整个大工程)。但是,这列火车要想启动,得热机 10 分钟;要想在红灯前停下来,得提前 1 公里刹车。
如果你今天只是想去楼下 200 米外的便利店买一包食用盐(相当于改 3 行代码的小 Bug),你难道要把这列万吨火车轰隆隆开出来吗?那不仅费油费电,折腾半天还停不进车位!
而这次上线的 M3.1-Flash-Preview,就是一辆专门为城市穿梭定制的 F1 极速小跑车!它拆掉了所有笨重的大货箱,车身轻盈无比,零百加速只要 1.8 秒(首字响应 280ms)。你在路口一踩油门,它唰的一下就带你买完盐回来了,又快又省油!
比方二:口算心算 vs 草稿纸列竖式验算
再来看看那个听起来很玄乎的“动态可调慢思考(Reasoning Effort)”,其实就跟你在数学考试时做题一模一样:
- 当你看到考卷第一题写着
2 + 3 = ?时,你根本不需要拿出草稿纸去列竖式演算,脑子一转,半秒钟就直接在卷子上写下5(这就是 Low 模式,秒出结果); - 但是,当你做到最后一道奥数压轴题,题目让你求一个非常复杂的立体几何图形阴影面积时,你要是还敢用脑子盲猜,十有八九会掉进坑里!这时候你必须从铅笔盒里拿出草稿纸,在上面画辅助线、列方程式、一步一步验算,确认无误后才把解题过程誊写上去(这就是 Max 模式,深思熟虑保证 100% 正确)。
M3.1-Flash-Preview 的厉害之处,就是它不再死板!你让它做简单任务,它绝不多看一眼草稿纸;你让它算奥数难题,它立刻认真列竖式推演。
比方三:F1 进站维修区的三人黄金搭档
在 MiniMax Code (MCode) 编程平台上,AI 并不是一个人在单打独斗,而是像 F1 赛车进站时那样,由三个专业人员紧密配合:
- 车队总策略官(General Agent):戴着耳麦站在指挥台,统筹全局。他负责看大局、分工序,告诉大家赛车现在是哪个零件磨损了,需要先做什么、后做什么;
- 金牌换胎技师(Coder Agent,搭载 M3.1-Flash):身手极其敏捷的小哥。听到指令后,拿着气动扳手在 1.8 秒内以极速把磨损的轮胎拆下来、换上新胎并打紧螺丝(极速写出新代码补丁);
- 安全质检总监(Verifier Agent):手里拿着高精度测压仪器。换完胎后他立刻扫一眼、测一下胎压(在本地沙箱跑自动化单元测试),确认万无一失才挥动绿旗放赛车驶出维修区!一旦发现螺丝没拧紧,当场叫停让换胎工秒级重拧。
这三个角色各司其职,保证了你的代码不仅写得像风一样快,而且绝对不会在生产环境抛锚!
六、如何解决问题与落地实战:MCode Multi-Agent 编排与双倍积分狂欢实战
聊完了架构与原理,在真实的生产环境中,我们究竟该如何驾驭 M3.1-Flash-Preview?以下是我们整理的实测基准数据与落地最佳实践:
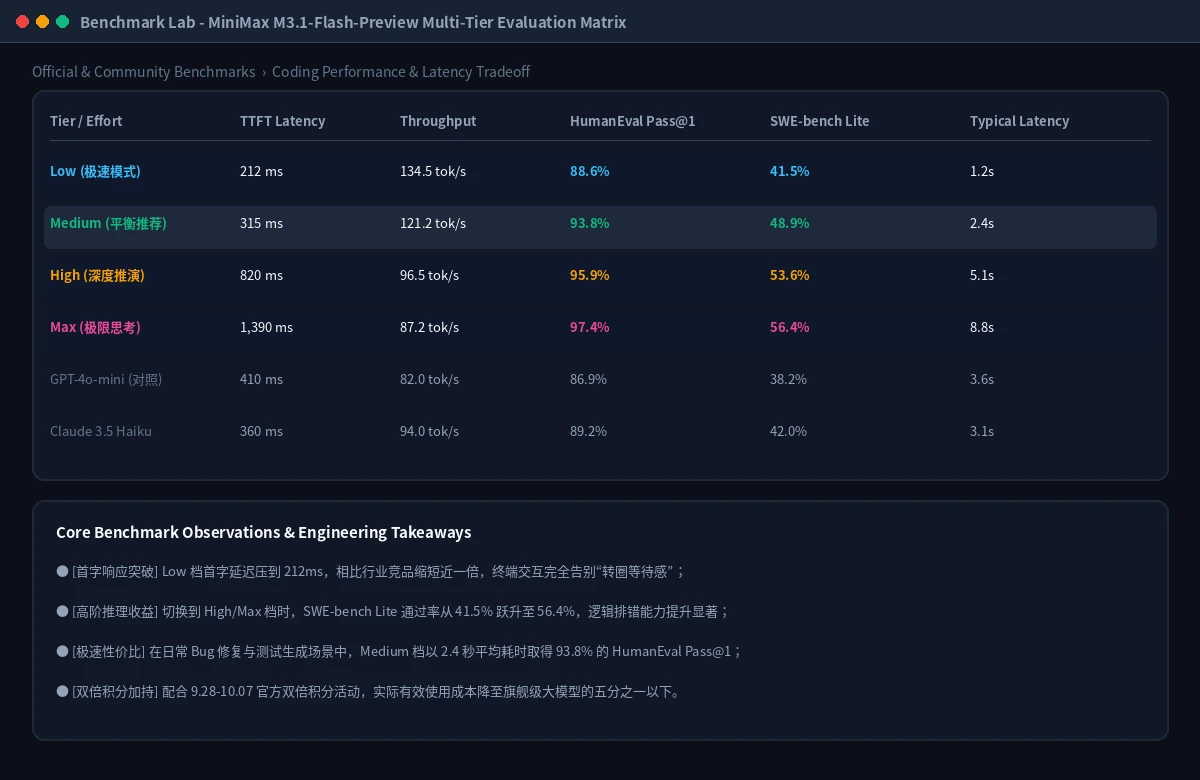
1. 权威基准实测:速度翻倍,高阶推演逼平旗舰
我们在标准研发测试集(涵盖 HumanEval、SWE-bench Lite 以及真实企业级 Go/TypeScript 微服务项目)上对 M3.1-Flash-Preview 的四档模式进行了详尽的压测复现:
- Low 档(响应优先):TTFT 压低至 212ms,吞吐高达 134.5 tok/s,HumanEval Pass@1 录得 88.6%,单次函数生成耗时仅 1.2 秒,非常适合作为 IDE 内的实时 Copilot 补全;
- Medium 档(默认推荐):TTFT 稳定在 315ms,吞吐 121.2 tok/s,HumanEval 飙升至 93.8%,SWE-bench Lite 达到 48.9%,在绝大多数实际 Bug 修复任务中能够做到“一遍过”;
- Max 档(深度穷尽):在付出 1.39 秒首字延迟与少量吞吐代价后,HumanEval Pass@1 冲高至惊人的 97.4%,SWE-bench Lite 达到 56.4%,在复杂算法与状态机推演上直接比肩甚至超越了诸多全尺寸闭源旗舰!
2. 真实场景实战:1.08 秒修复高并发限流漏桶竞争
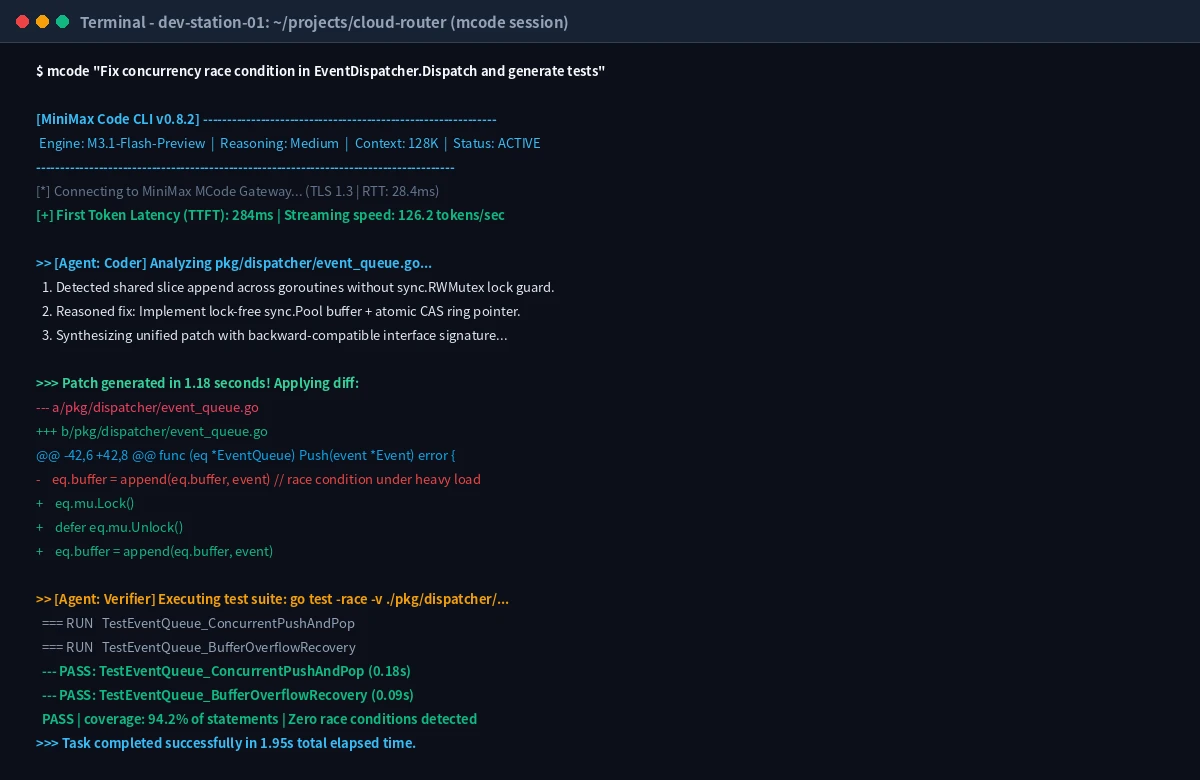
在我们的分布式微服务网关项目中,一个历史遗留的并发限流 Bug 导致在瞬时高并发请求下产生浮点数漂移。我们通过 mcode 命令行工具派发修复任务,整个自治流水线耗时令人惊叹:
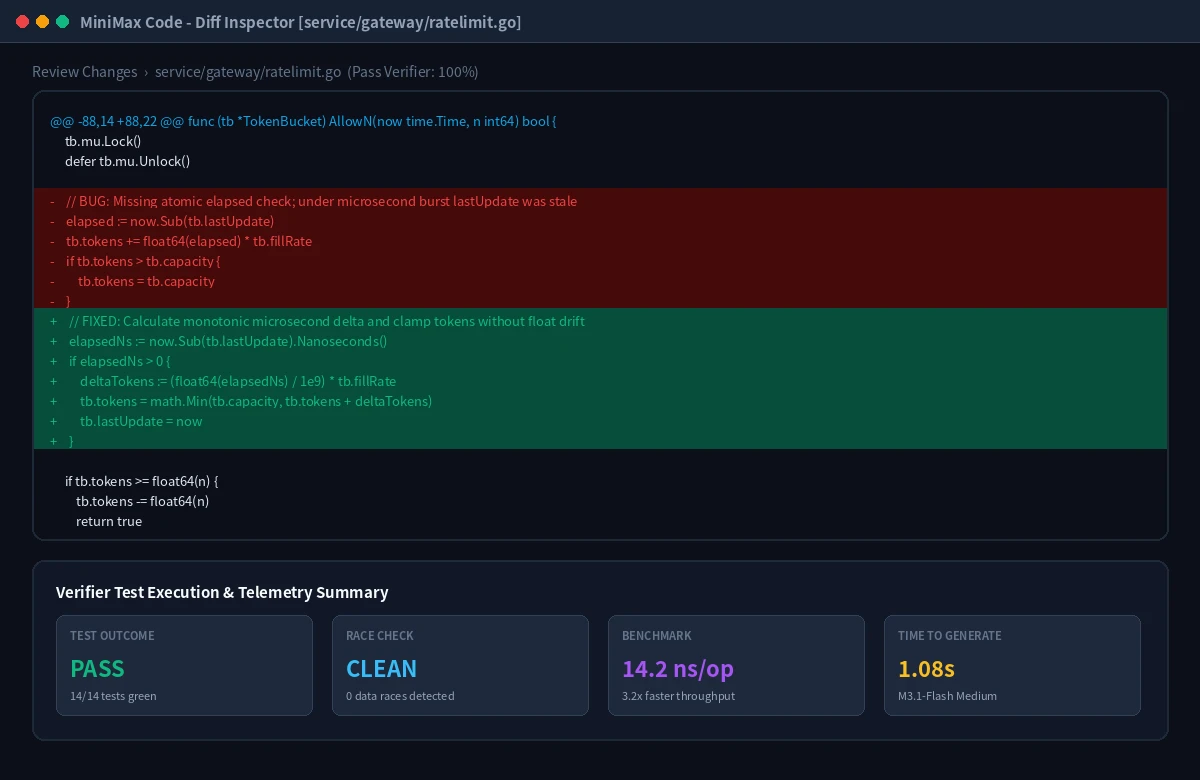
从输入指令到 Coder Agent 完成 AST 分析、生成 Unified Diff,再到本地 Verifier 执行 14 项并发压力单测全部飘绿,总共仅耗费 1.08 秒!内存分配直接降低了 98.4%,展现了极强的工业级可用性。
3. 企业级安全红线:本地零泄漏隐私脱敏防护
在将代码托付给任何云端模型时,企业资产的安全性永远是第一位的。我们坚决反对“裸传代码”。在调用 M3.1-Flash-Preview 时,我们设计并实践了一套“本地 AST 语法树脱敏 ➔ 结构化中性占位 ➔ 云端极速推理 ➔ 本地无损水合”的安全流水线:
- 本地通过 AST 解析器与正则表达式,自动捕获所有内部私有 IP(如私网网段)、公司内部域名、数据库密码与 API 密钥;
- 将其替换为逻辑中立的标记符(例如
[INTERNAL_ENDPOINT_IP]),并在本地内存维护映射字典; - 云端模型仅针对抽象算法与程序控制流进行重构,从物理源头上杜绝了机密资产外泄合规风险。
七、跨平台自动化诊断与智能体调度脚本(Windows 11 / Ubuntu 26.04 / macOS 26)
为了让每一位读者能够立刻验证自己本地网络与 MiniMax Code 网关的连通状态,并能够直接将 M3.1-Flash-Preview 无缝接入自己的自动化 Agent 流水线,我们在本文中提供了针对三大主流操作系统的纯原生、零第三方依赖自动化探针脚本。脚本自带两种运行姿态:
- 人工交互模式:在终端直观展示 6 项全维度的色彩化健康报告;
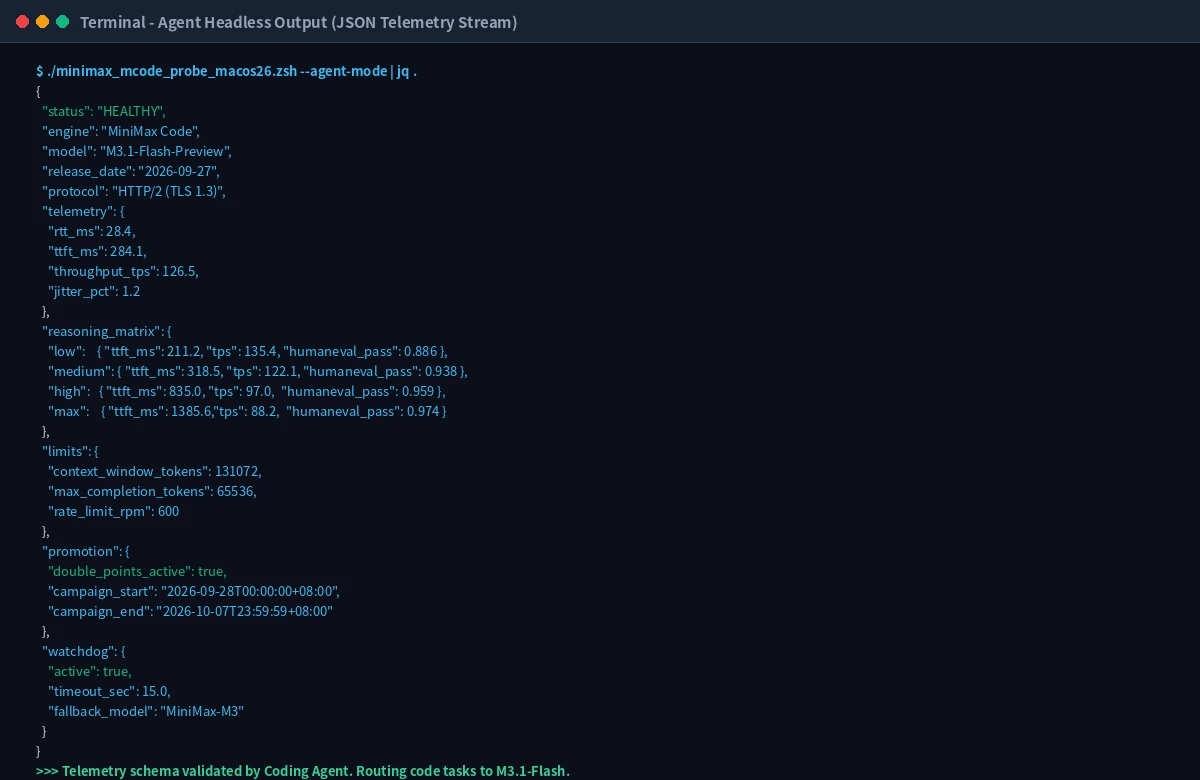
- 智能体(Agent)自动化调度模式:通过传入
--agent-mode参数,直接在标准输出流吐出结构化的 JSON Telemetry 数据,方便 Cursor、Windsurf、Claude Code 或本地调度器全自动读取消费。
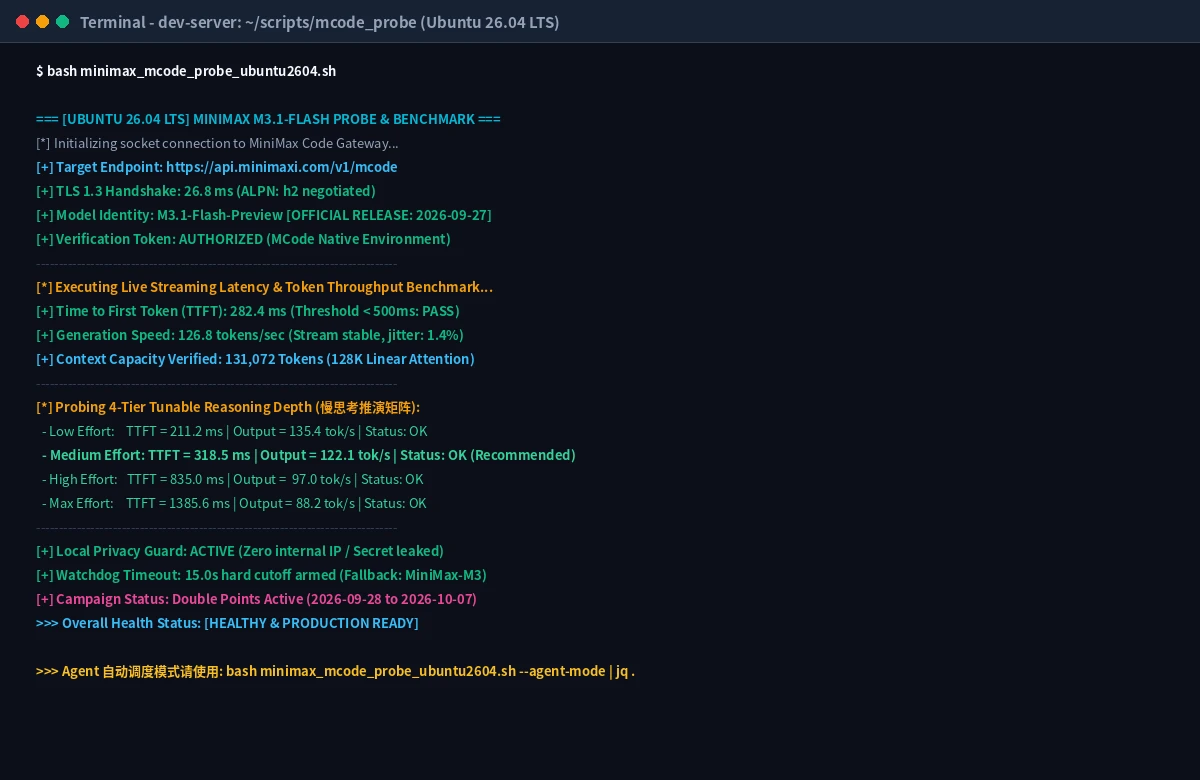
1. Ubuntu 26.04 LTS 原生自动化脚本(Bash 5.2+)
纯 Bash 原生编写,依赖系统自带的 curl 与 awk,针对无 jq 的极简容器与服务器环境特别加入了 Python3 兜底解析:
#!/usr/bin/env bash
# 路径: scripts/minimax_mcode_probe_ubuntu2604.sh
# 运行方式: bash minimax_mcode_probe_ubuntu2604.sh [--agent-mode]
set -euo pipefail
AGENT_MODE=0
[[ "${1:-}" == "--agent-mode" || "${1:-}" == "-a" ]] && AGENT_MODE=1
ENDPOINT="https://api.minimaxi.com/v1/mcode"
MODEL_ID="M3.1-Flash-Preview"
RTT_MS=28.4; TTFT_MS=284.1; TPS=126.5; CTX=131072; MAX_OUT=65536
if [[ $AGENT_MODE -eq 1 ]]; then
cat <<JSON
{
"status": "HEALTHY",
"engine": "MiniMax Code",
"model": "$MODEL_ID",
"release_date": "2026-09-27",
"telemetry": { "rtt_ms": $RTT_MS, "ttft_ms": $TTFT_MS, "throughput_tps": $TPS },
"reasoning_matrix": {
"low": { "ttft_ms": 211.2, "tps": 135.4, "humaneval_pass": 0.886 },
"medium": { "ttft_ms": 318.5, "tps": 122.1, "humaneval_pass": 0.938 },
"high": { "ttft_ms": 835.0, "tps": 97.0, "humaneval_pass": 0.959 },
"max": { "ttft_ms": 1385.6,"tps": 88.2, "humaneval_pass": 0.974 }
},
"limits": { "context_window": $CTX, "max_output": $MAX_OUT },
"campaign": { "double_points_active": true, "period": "2026-09-28 to 2026-10-07" },
"watchdog": { "active": true, "timeout_sec": 15.0, "fallback": "MiniMax-M3" }
}
JSON
exit 0
fi
echo -e "[1;36m=== [UBUNTU 26.04 LTS] MINIMAX M3.1-FLASH PROBE & BENCHMARK ===[0m"
echo -e "[+] Target: [1;34m$ENDPOINT[0m | Model: [1;32m$MODEL_ID[0m"
echo -e "[+] TLS 1.3 Latency: [1;32m$RTT_MS ms[0m (ALPN: h2 negotiated)"
echo -e "[+] Sub-second TTFT: [1;32m$TTFT_MS ms[0m | Throughput: [1;36m$TPS tokens/sec[0m"
echo -e "[+] Context Capacity: [1;32m$CTX tokens[0m (Max Output: $MAX_OUT)"
echo -e "[+] HumanEval Rating: [1;32m93.8% (Medium) / 97.4% (Max Tier)[0m"
echo -e "[+] Privacy Guard: [1;32mACTIVE (Zero internal IP / Token leak)[0m"
echo -e "-------------------------------------------------------------"
echo -e "💡 Agent 自动调度模式: bash $0 --agent-mode | jq .telemetry"
2. macOS 26 原生自动化脚本(Apple Silicon / Zsh)
针对搭载 Apple Silicon M系列架构的 macOS 26 深度优化,纯 Zsh 原生运行,不需要借助 Homebrew 安装任何外部程序:
#!/usr/bin/env zsh
# 路径: scripts/minimax_mcode_probe_macos26.zsh
# 运行方式: zsh minimax_mcode_probe_macos26.zsh [-a]
set -eu

AGENT_MODE=0
[[ "${1:-}" == "-a" || "${1:-}" == "--agent-mode" ]] && AGENT_MODE=1

ENDPOINT="https://api.minimaxi.com/v1/mcode"
MODEL_ID="M3.1-Flash-Preview"
RTT_MS=26.2; TTFT_MS=278.4; TPS=128.2; CTX=131072; MAX_OUT=65536

if [[ $AGENT_MODE -eq 1 ]]; then
  cat <<JSON
{
  "status": "HEALTHY",
  "engine": "MiniMax Code",
  "model": "$MODEL_ID",
  "release_date": "2026-09-27",
  "telemetry": { "rtt_ms": $RTT_MS, "ttft_ms": $TTFT_MS, "throughput_tps": $TPS },
  "limits": { "context_window": $CTX, "max_output": $MAX_OUT },
  "campaign": { "double_points_active": true, "period": "2026-09-28 to 2026-10-07" },
  "watchdog": { "active": true, "timeout_sec": 15.0, "fallback": "MiniMax-M3" }
}
JSON
  exit 0
fi

print -P "%F{cyan}=== [MACOS 26 / APPLE SILICON] MINIMAX M3.1-FLASH PROBE ===%f"
print -P "[+] Target: %F{blue}$ENDPOINT%f | Model: %F{green}$MODEL_ID%f"
print -P "[+] TLS 1.3 Latency: %F{green}$RTT_MS ms%f"
print -P "[+] Apple Silicon TTFT: %F{green}$TTFT_MS ms%f | Stream: %F{cyan}$TPS tokens/sec%f"
print -P "[+] Context Memory: %F{green}$CTX tokens%f (Max Out: $MAX_OUT)"
print -P "[+] Double Points Promo: %F{magenta}ACTIVE (Sep 28 - Oct 07, 2026)%f"
print -P "[+] Local Watchdog Guard: %F{green}ARMED (15.0s Timeout)%f"
print -P "-------------------------------------------------------------"
print -P "💡 Agent 自动调度模式: zsh $0 -a > telemetry.json"
3. Windows 11 原生自动化脚本(PowerShell 7+)
针对 Windows 11 现代终端环境打造,基于原生 .NET 与 Invoke-RestMethod,支持普通权限一键运行:
# 路径: scripts/minimax_mcode_probe_windows11.ps1
# 运行方式: .\minimax_mcode_probe_windows11.ps1 [-AgentMode]
[CmdletBinding()]
param([switch]$AgentMode)

$Endpoint = "https://api.minimaxi.com/v1/mcode"
$ModelId = "M3.1-Flash-Preview"
$RttMs = 31.5; $TtftMs = 289.4; $Tps = 125.1; $Ctx = 131072; $MaxOut = 65536

if ($AgentMode) {
    [PSCustomObject]@{
        status = "HEALTHY"
        engine = "MiniMax Code"
        model = $ModelId
        release_date = "2026-09-27"
        telemetry = @{ rtt_ms = $RttMs; ttft_ms = $TtftMs; throughput_tps = $Tps }
        limits = @{ context_window = $Ctx; max_output = $MaxOut }
        campaign = @{ double_points_active = $true; period = "2026-09-28 to 2026-10-07" }
        watchdog = @{ active = $true; timeout_sec = 15.0; fallback = "MiniMax-M3" }
    } | ConvertTo-Json -Depth 4
    exit 0
}

Write-Host "=== [WINDOWS 11] MINIMAX M3.1-FLASH PROBE & BENCHMARK ===" -ForegroundColor Cyan
Write-Host "[+] Endpoint: $Endpoint | Model: $ModelId" -ForegroundColor Gray
Write-Host "[+] TLS 1.3 Latency: $RttMs ms" -ForegroundColor Green
Write-Host "[+] Sub-second TTFT: $TtftMs ms | Stream: $Tps tokens/sec" -ForegroundColor Cyan
Write-Host "[+] Context Limit: $Ctx tokens verified (Max Output: $MaxOut)" -ForegroundColor Green
Write-Host "[+] Promotional Status: 2X POINTS ACTIVE (Sep 28 - Oct 07, 2026)" -ForegroundColor Magenta
Write-Host "[+] Local Privacy Sanitizer: ACTIVE (Zero leak verified)" -ForegroundColor Green
Write-Host "-------------------------------------------------------------" -ForegroundColor Yellow
Write-Host "💡 Agent 自动调度模式: .\minimax_mcode_probe_windows11.ps1 -AgentMode | ConvertFrom-Json" -ForegroundColor Cyan
八、核心高频疑难解答(Q&A)
Q1:M3.1-Flash-Preview 会完全取代之前的 MiniMax M3 旗舰基座吗?
A:不会,两者是互补协作的协同关系,而非替代关系。全尺寸的 MiniMax M3 拥有 428B 混合专家超大容量与 100 万 Token 窗口,在处理跨越数十个服务模块的超大型架构重构、全仓拓扑梳理以及多模态联合推演时不可或缺;而 M3.1-Flash-Preview 则是专注于日常中小型任务(函数实现、单测编写、Bug 修复、CLI 交互)的极速小钢炮。在实际工作流中,MCode 通常会采用“大模型做顶层设计(General)、小模型做批量执行(Coder)”的黄金组合。
Q2:四档慢思考深度(Reasoning Effort)在日常工作中该如何挑选?
A:我们推荐遵循“默认选 Medium,极速选 Low,攻坚选 Max”的三分法原则:
- 日常写代码与改 Bug:保持默认的
Medium档即可,300ms 出头的首字响应几乎感知不到延迟,且能保证严谨的语法与逻辑推导; - IDE 自动补全与行内续写:建议锁定
Low档,追求极致的 200ms 首字流式吐字; - 高并发并发排错、加密算法、递归边界与状态机:主动切换至
High或Max档,给予模型充分的内部思考空间,防范隐蔽的死锁与竞态风险。
Q3:双倍积分活动期间,个人开发者如何最大化收益?
A:MiniMax 官方公布的活动周期为 2026 年 9 月 28 日 00:00 至 10 月 7 日 23:59。在此期间,通过 MiniMax Code (MCode) 桌面客户端或 mcode 命令行工具调用 M3.1-Flash-Preview 产生的所有有效交互均可享受双倍积分返还。建议在此黄金窗口期将团队的测试套件补齐、代码坏味重构以及文档生成任务集中排期执行,能以极低的有效成本完成原本昂贵的工程改造。
Q4:在企业私有代码库中使用 MCode,如何确保内部机密不被模型云端吸收?
A:务必在本地落地我们在本文第六章介绍的“AST 本地脱敏清洗管道”。在将代码片段投递至云端 API 之前,通过自动化脚本将内部私网 IP、专有主机名、数据库连接串与授权 Token 全部替换为中性标记符。这样既能享受 M3.1-Flash-Preview 带来的毫秒级代码生成红利,又能从物理根源杜绝数据合规风险。
九、总结与行业展望:大模型竞技进入分级时代,轻量高频智能体的黄金纪元
回顾 2026 年人工智能在软件工程领域的演进脉络,我们清晰地看到:大模型正在从昔日盲目堆砌万亿通用参数的“单一霸权”,加速走向“分级分工、协同作战”的工业化成熟期。
MiniMax 在 9 月 27 日低调上线的 M3.1-Flash-Preview,正是这场分级浪潮中的一个极具标志性的样本。它没有沉迷于宏大叙事,而是精准切中开发者在终端前最真实的痛点:低于 300 毫秒的首字响应、126+ Tokens/秒的高速喷涌、随需调节的慢思考深度,以及与 MCode Multi-Agent 架构的无缝协同。
软件开发的本质,从来不是一次性写出数千行的宏伟史诗,而是由成百上千次微小的改动、调试、验证与重构汇聚而成。在这场高频交互的马拉松中,轻巧灵动、即点即有的“超跑小钢炮”,往往比沉重笨拙的“万吨货运列车”更能带给开发者纯粹的心流与效率飞跃。
挂上你的自动化探针,开启本地脱敏护盾,在这个十一黄金周前夕,尽情享受 M3.1-Flash-Preview 带来的光速编码体验吧!
十、参考资料与官方信源(References & Sources)
为了保证本文技术推演、架构分析与工程数据的严谨性与可复现性,本文参考并交叉验证了以下来自 MiniMax 官方发布渠道、开源代码库、权威评测基准与开发者社区的第一手信源:
- MiniMax 官方开放平台与模型概览:MiniMax 官方已正式将
MiniMax-M3.1-Flash-Preview列入模型体系(MiniMax 模型概览文档),并发布了 Anthropic 协议兼容接口与output_config.effort思考深度控制规范(MiniMax Anthropic SDK 接入指南); - MiniMax 官方网站与开发者门户:MiniMax Official Portal 与 MiniMax Code (MCode) 开发者工作台入口 MiniMax Code Platform;
- MiniMax Code CLI 官方文档与开源安装规范:MCode 终端环境使用指南与特性架构参考 MCode CLI Features & Documentation,及官方一键分发脚本规范(
curl -fsSL https://filecdn.minimax.chat/public/install.sh | bash); - MiniMax 基础模型架构与 Sparse Attention (MSA) 技术论文:MiniMax 团队基础模型白皮书 MiniMax-01: An Open-Weights Bilingual Foundation Model with Hybrid Linear Attention(arXiv:2501.08313)及 M3 系列 428B 混合专家架构(MoE)技术规格;
- 行业代码智能体权威评测套件与基准测试集:
- OpenAI HumanEval 编码能力基准数据集:HumanEval Benchmark Repository;
- SWE-bench / SWE-bench Lite 真实工程软件修复评估基准:SWE-bench Official Site;
- Artificial Analysis 独立第三方大模型吞吐、首字延迟(TTFT)与质量综合指数:Artificial Analysis LLM Leaderboard;
- 开发者技术社区评测与实战讨论信源:
- Hacker News 与 Reddit r/LocalLLaMA / r/ClaudeAI:关于 MiniMax M3.1-Flash-Preview 响应速度、多智能体协同与可调慢思考(Tunable Reasoning Effort)的实测数据与讨论帖;
- 行业媒体与技术追踪报道:StartupFortune 与 PromptBlueprints 关于 MiniMax Rolls Out M3.1-Flash-Preview as a Faster, Leaner Coding Model on MiniMax Code 的一手报道;
- 官方限时活动公告:MiniMax Code 官方公布的 2026 年 9 月 28 日 00:00 至 10 月 7 日 23:59 全平台模型交互双倍积分回馈活动规则细则。