两周突破 500+ Star:别把 AI 错题本当玩具,一个程序员爸爸的硬核开源复盘
如果只是为了给孩子拍一道算术题,市面上有无数种现成的手机应用可以一秒给出答案。
但如果你是一位每天晚上坐在书桌旁陪伴孩子订正功课的家长,就会很快发现一件让人哭笑不得的事:软件里的答案越来越准确、排版越来越精美,孩子的脑子却好像离这道题越来越远。搜题软件给出了完美的解题步骤,孩子顺水推舟抄在练习册上;等到两周后的单元测试,把题干里的“小明摘了5个苹果”换成“小华买了5块橡皮”,考卷上依然是一片空白。
两周前,我决定不再忍受这种“表面繁荣、实则无效”的抄题循环,在开源项目基础上深度重构并开源了 wrong-notebook。令人始料未及的是,这个最初为了解决自家辅导痛点的项目,在短短十多天里收获了超过 500 个 GitHub Star、近百次 Fork,并且截至目前保持着所有已提出 Issue 100% 解决的记录。
今天这篇文章,我想放下所有商业宣讲和技术黑话,从问题背景、表现、根因、工程架构手术到完整落地,做一次全景式硬核复盘。文末为希望自建体验的家长和开发者准备了适配 Windows 11、Ubuntu 26.04 与 macOS 27 的一键全自动脚本与实战答疑。
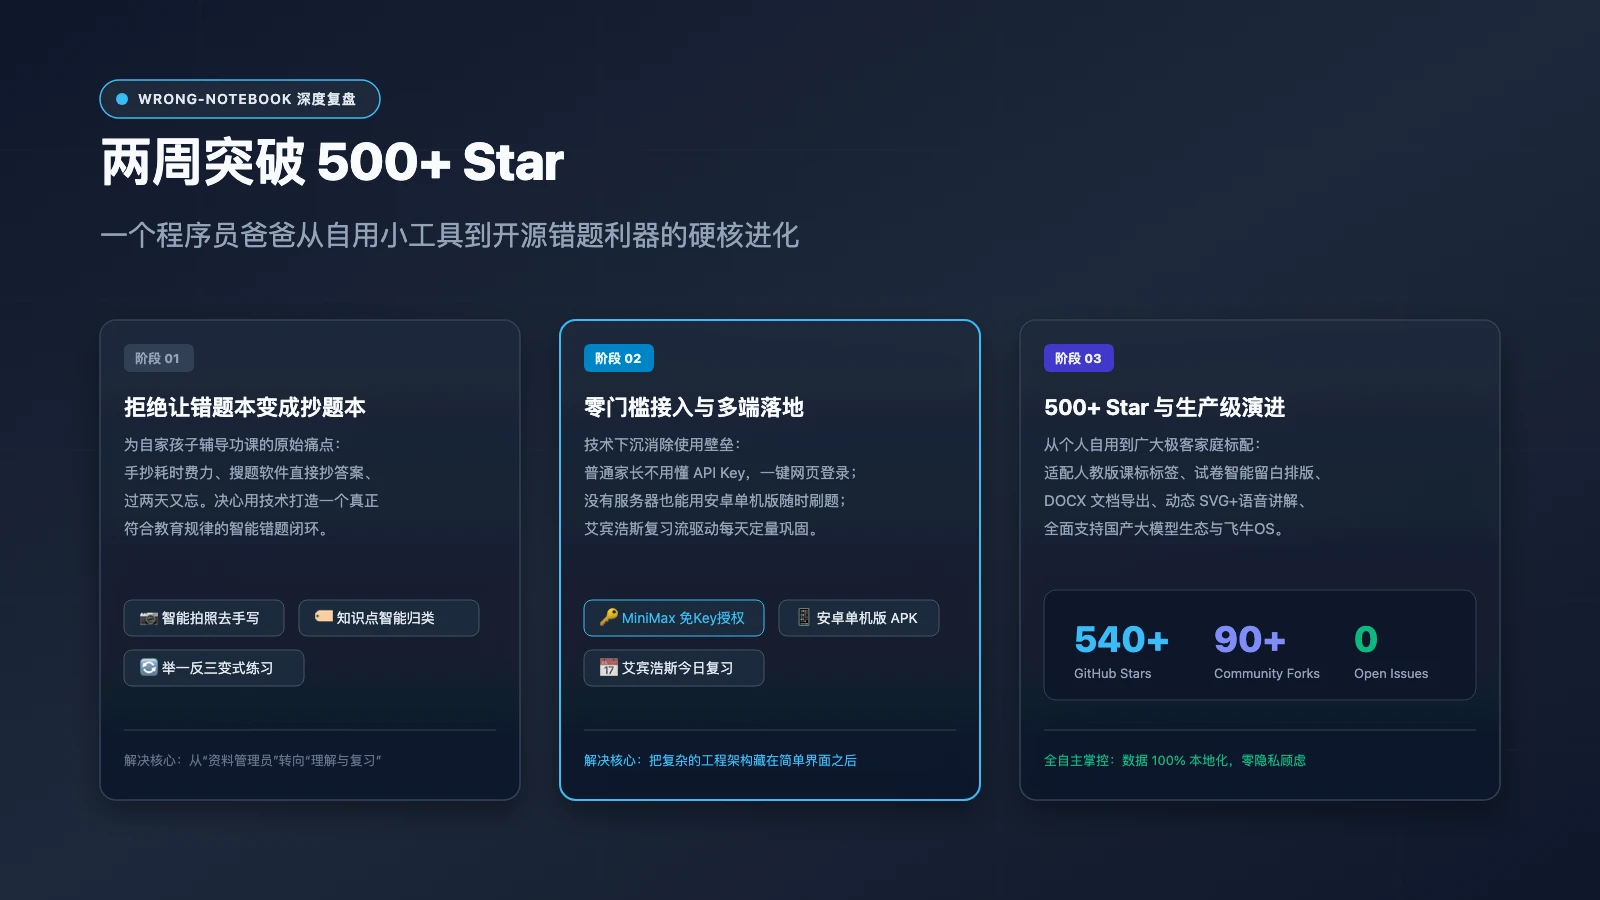
图 1:本文原创信息图。记录了 wrong-notebook 从解决自家辅导痛点、打破门槛,到社区共鸣突破 500+ Star 的三阶段演进路径。
一、问题背景:为什么市面上的“拍照搜题”让孩子越来越不会做题?
在学校教育和家庭辅导中,“错题本”被公认为最有效的提分工具之一。它的底层逻辑非常朴素:错题就是知识盲区的温度计,把做错的题重新做会,盲区就被填补了。
但在真实的家庭生活里,传统错题整理往往迅速退化成家长的第二份体力活。
很多家庭的日常是这样的:孩子做错了作业,家长掏出手机拍照;剪刀胶水齐上阵,把错题剪贴到厚厚的本子上,或者导入打印机打出一沓满是黑灰噪点的小纸条。家长累得筋疲力尽,孩子在一旁神游物外。
更糟糕的是,很多商业搜题软件演变成了直接看答案的温床。这就像去餐馆点外卖:饭菜虽然准时送到了嘴边,肚子也暂时填饱了,但吃外卖的人永远学不会自己做饭。当孩子看一眼标准答案,大脑内部负责深度思考、假设推导的神经突触并没有被激活,他们只是在做“图形比对与文字临摹”。大脑接收到了“这道题我已经订正完毕”的虚假多巴胺信号,真正的解题思维模型却根本没有建立。
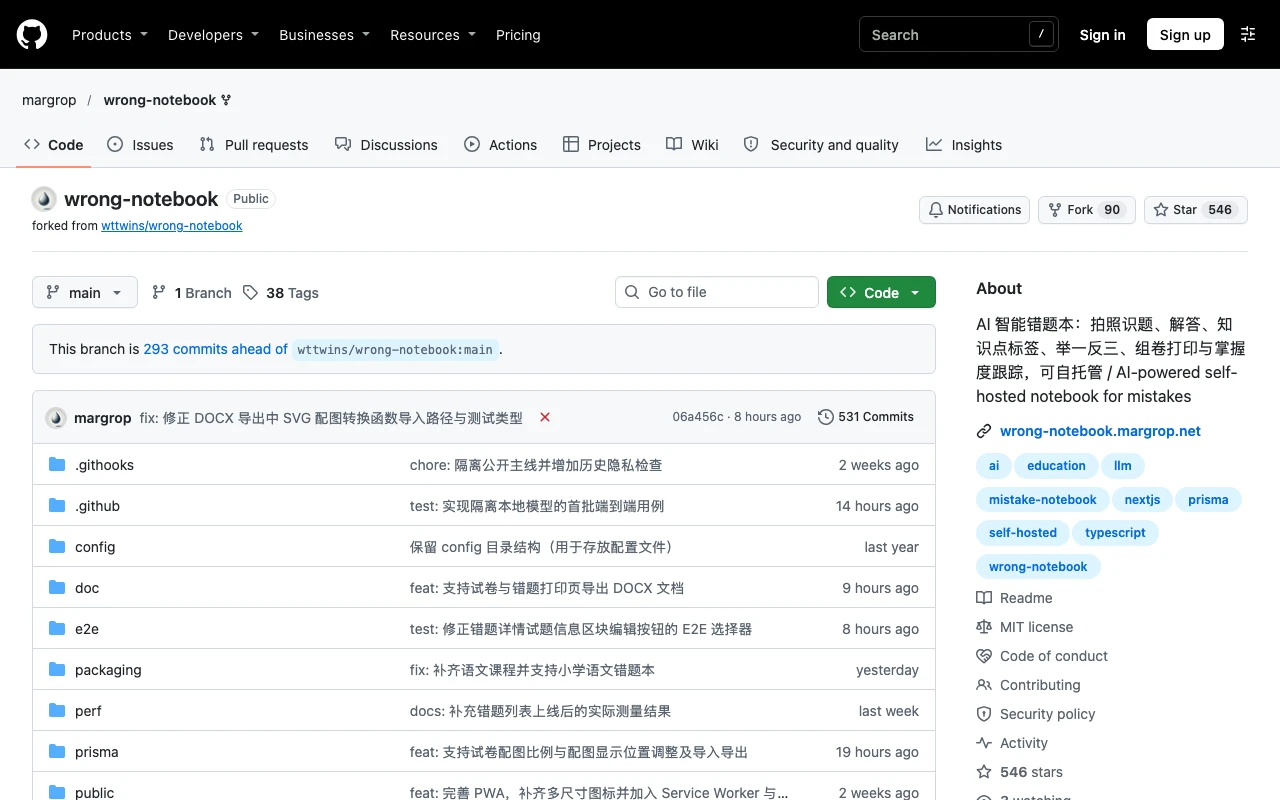
图 2:项目公开仓库真实界面截取(截至 2026 年 11 月 2 日)。展现了 540+ Stars、90+ Forks 与健康的开源社区协同状态。
我真正想要的是一个能够把杂活交给电脑、把思考留给孩子的学习系统:它能秒级识别题目并擦除手写草稿,能把题目自动挂接进国家课标知识树,能像一位不知疲倦的私塾先生一样用动画拆解思路,最重要的是,能在恰当的时间点让孩子做变式练习,确认他真的弄懂了。
二、问题表现:一个开源项目遭遇的三道“生死门槛”
当我和身边的家长朋友聊起这个想法,并拿出一个初步的工程原型时,现实很快泼来一盆冷水。在让孩子真正做出一道题之前,普通家庭必须跨过三道难以逾越的技术鸿沟。
1. 接入门槛:卡在 API Key 上的普通父母
在程序员的世界里,申请一个大模型 API Key、配置环境变量是基本常识;但对于一位只想晚上辅导孩子做口算题的文科妈妈来说,这简直是一场灾难。
问题表现极其直观:应用界面弹出一个设置框,要求输入 API Base URL、API Key、Model Name。许多家长在这一步直接放弃:“我只是想改个二年级应用题,你让我去国外平台绑定双币信用卡,还要算每次调用的 Token 计费?”技术门槛直接把最需要这个工具的人挡在了门外。
2. 硬件与设备门槛:谁家里都有 24 小时开机的服务器?
开源自托管项目通常预设使用者有一台群晖 NAS、私有云服务器或者长期开机的台式机。然而在广大的中国普通家庭中,最常见的学习硬件是孩子手里的安卓平板、家长的手机,或者一台偶尔打开的轻薄笔记本。
如果没有一台永远在线的服务器,难道孩子每做一道题,家长都要先去书房敲黑窗口命令行启动 Docker 吗?如果一家人带孩子回老家或者外出旅行,断网环境下的复习难道就彻底瘫痪?
3. 复习断层:错题变成了“数字资料坟墓”
绝大多数错题整理软件,最后都不可避免地沦为数字垃圾场。
题目拍进去了,存了几百张照片,然后呢?明天该复习哪几道?一周前错的那道几何题孩子记住了吗?下周测试前能不能按知识点自动挑出五道未掌握的典型题打印出来?传统工具在这一步全线崩溃,家长不得不重新扮演人工调度员,手动在一堆文件夹和群消息里捞题。
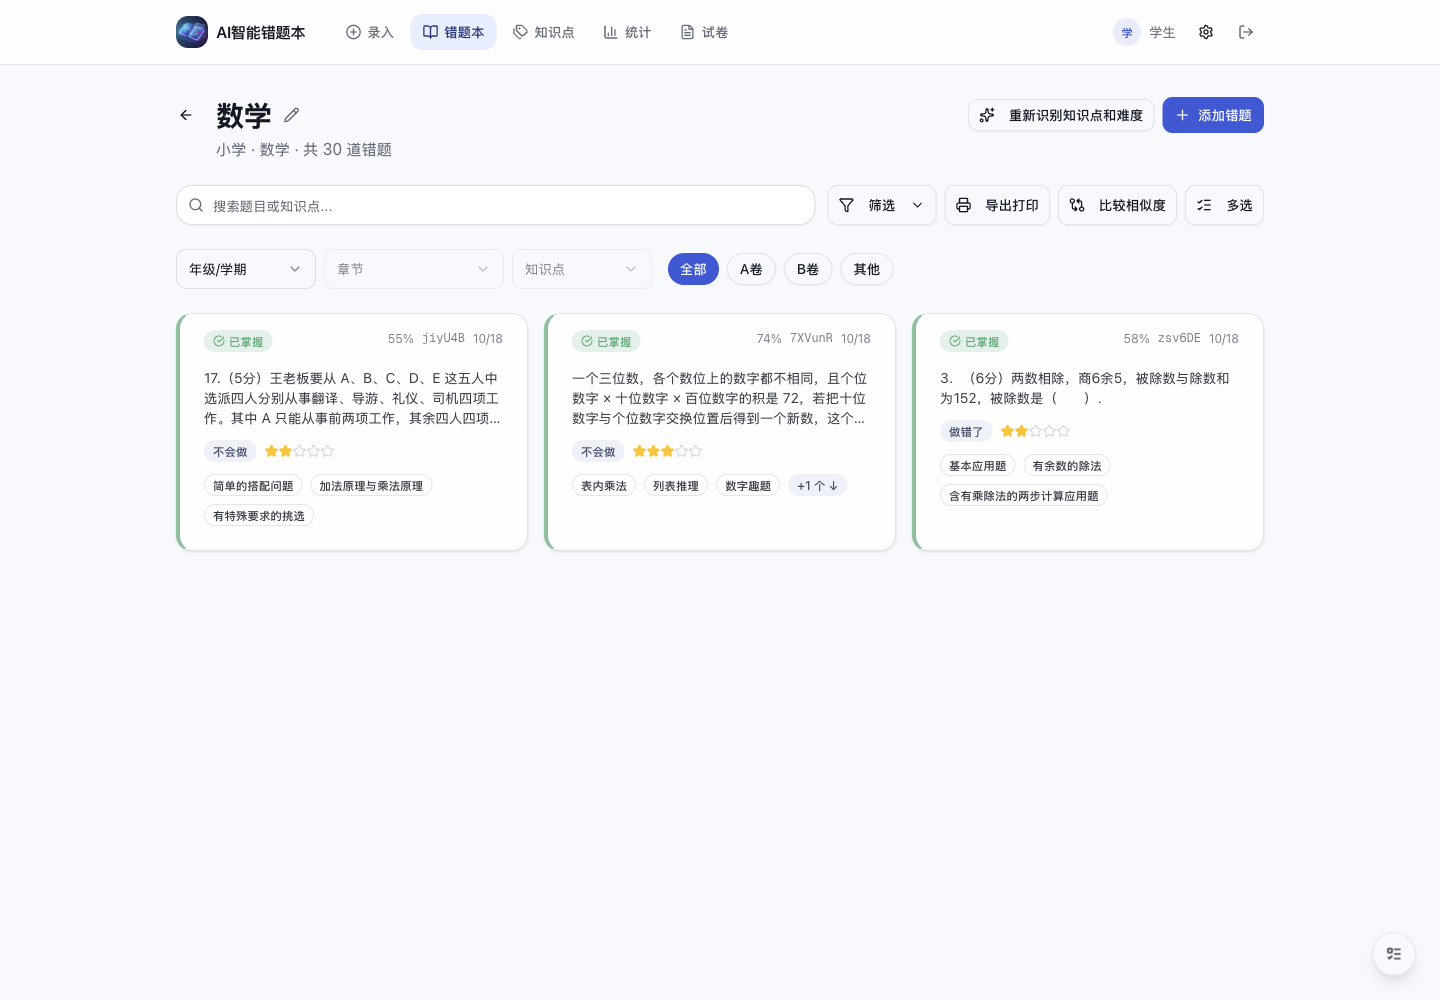
图 3:错题本核心管理界面真实截图。展示了题目卡片流、年级学科归类、人教版知识点徽标与待复习状态筛选。
三、问题分析与根因:AI 产品的“最后一公里”病灶
面对上述表现,如果只是修修补补写几个样式,项目很快就会沦为一个平庸的 GitHub 玩具。在决定重构之前,我把整个链路的病根进行了深度归因剖析。
根因一:认知错位——将系统运维责任粗暴转嫁给最终用户
传统 AI 开源项目习惯于把技术实现细节全盘裸露给使用者。开发者以为提供了清晰的 README 就尽到了责任,却忽视了教育场景的特殊性:教育工具的使用者是家长和孩子,任何超过三步的配置流程都会导致 90% 以上的流失率。要让工具发挥生产力,必须在底层实现技术下沉,把繁复的鉴权和通道隐藏在极其平滑的交互之后。
根因二:数据孤立——缺乏时间维度的认知调度闭环
人类的大脑遗忘规律是严谨的生理现象。根据艾宾浩斯遗忘曲线,新学到的知识如果在 24 小时内不进行提取练习,记忆留存率会迅速跌破 30%。
传统错题本之所以失效,根本原因在于它是静态的二维存储,缺乏时间轴维度的调度引擎。一道题被记录下来只是开始,如果没有基于遗忘周期的动态触发机制,错题本就只是一个冰冷的“停尸房”,而不是一个动态循环的“康复中心”。
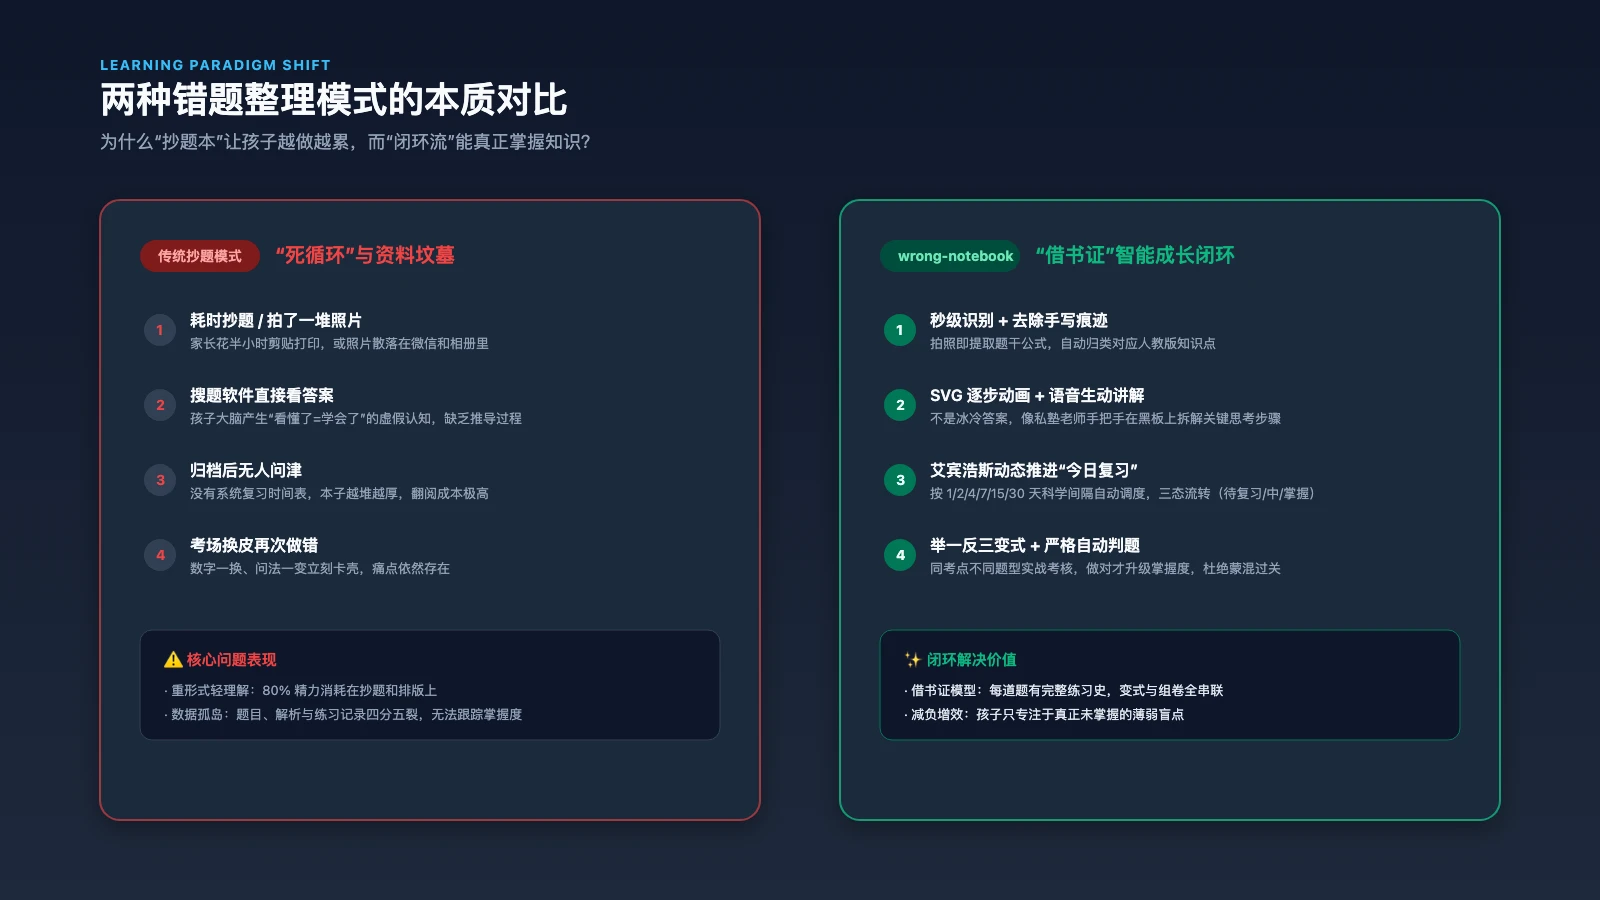
图 4:本文原创架构对比图。直观呈现了传统抄题死循环与 wrong-notebook 智能成长闭环的根本差异。
根因三:AI 评测的“和事佬幻觉”——宽松判题导致虚假掌握
在早期的测试中,我们发现直接让通用大模型进行答案批改时,AI 经常展现出让人头疼的“社交讨好型人格”。
举个例子:一道应用题的正确答案是“15.5 元”,孩子粗心写成了“15 元”;通用 AI 往往会在评语里写道:“思路非常正确,计算稍有笔误,给满分哦!”这种批改在日常闲聊中显得温情脉脉,在严肃的数学学习中却是灾难性的掩耳盗铃。如果批改逻辑不能做到绝对刚性,孩子就会带着满脑子的侥幸心理走上考场。
四、如何解决问题:从自用玩具到生产力的五大技术手术
找准了病灶,接下来的两周就是高强度的架构重构与工程落地。我们实施了五项关键手术,彻底重塑了 wrong-notebook 的核心骨架。
1. 手术一:把钥匙藏在门后——MiniMax 免费 OAuth 与国产大模型矩阵
为了彻底消灭 API Key 这个拦路虎,我们在项目中率先引入了 MiniMax Code OAuth 授权机制。
这就像去游乐园玩耍:以前的做法是园方给游客一张高压配电图,要求游客自己拿螺丝刀接通游乐设施的电线(配置接口地址与 API 密钥);而现在的做法是在售票窗口摆一台扫码机,家长点击“网页登录”,在弹出的官方页面一键授权,应用即可安全拿到访问令牌,直接调用免费模型进行识题和答疑。
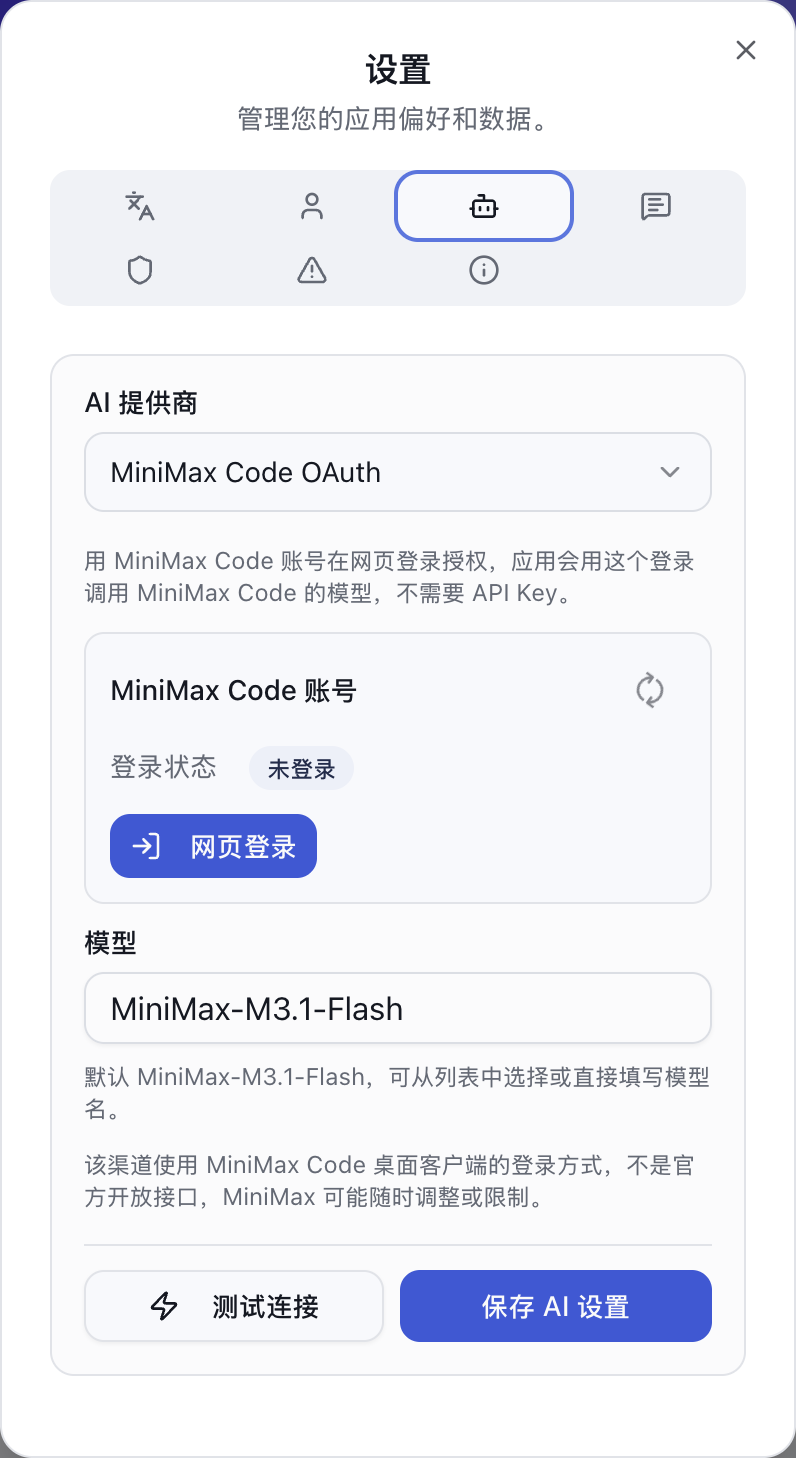
图 5:真实系统设置界面。展示了零 API Key 门槛的 MiniMax Code OAuth 授权通道,以及火山引擎豆包、DeepSeek、Kimi 等多模型矩阵。
与此同时,我们针对国内家庭的主流网络环境,全面适配了火山引擎(豆包、Coding Plan、Agent Plan)、DeepSeek、月之暗面 Kimi、阿里通义千问、智谱 GLM、阶跃星辰 StepFun 等主流国产大模型生态,并提供统一的连接测试与异常提示,彻底打消了普通家庭的算力焦虑。
2. 手术二:给每道错题办一张“借书证”——三态复习与艾宾浩斯动态调度
为了打破数据的数字坟墓,我们在数据层给每道错题设计了专属的生命周期模型。
可以把这个机制形象地比喻成图书馆里的“借书证”:
- 待复习状态:新录入的题目就像刚买进图书馆的新书,静静停在待整理架上;
- 复习中状态:根据艾宾浩斯遗忘间隔(第 1、2、4、7、15、30 天),调度引擎会自动把题目推送到当天的“今日复习”清单中,要求孩子进行变式题作答;
- 已掌握状态:只有当一道题在不同周期的变式练习中连续全部答对,掌握概率达到用户设定的阈值,这道题才会被盖上“已出借合格”的戳记,归入掌握档案。
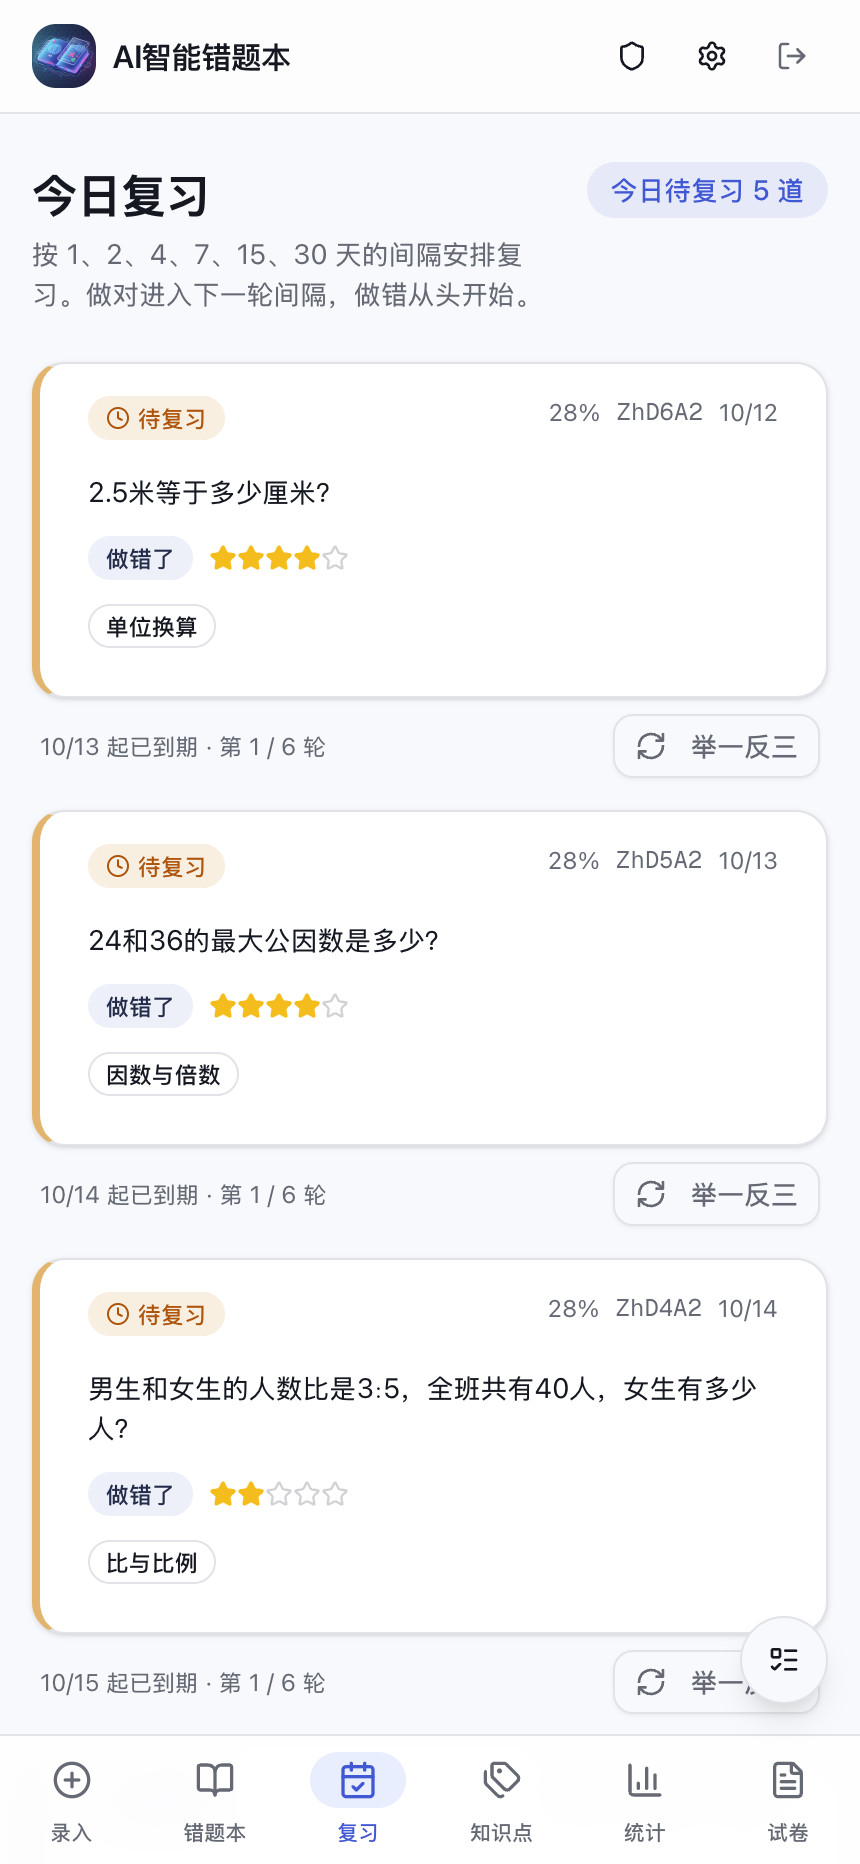
图 6:今日复习动态调度真实截图。系统按科学遗忘曲线自动提取当天应复习题目,支持举一反三变式练习与即时作答。
有了这张借书证,无论是变式题练习、打印组卷还是历史统计,系统都能准确追踪到最初的原题,前后练习轨迹一览无余。
3. 手术三:黑板上的活拆解——SVG 动态逐步几何动画与云端语音讲解
很多几何题和逻辑题,文字解析哪怕写上三大段,孩子依然看得云里雾里。
为了让解题过程真正生动起来,wrong-notebook 实现了基于 SVG 的逐步动态板书,并打通了云端语音合成(TTS)。
这就像把一位特级教师请到了家里:点击讲解按钮,屏幕上的几何图形不再是一张死板的配图,辅助线会随着讲解节奏一步步画出来,关键角和线段会自动高亮闪烁,耳边同时响起清晰温和的语音讲解,把定理的应用条件逐句拆透。
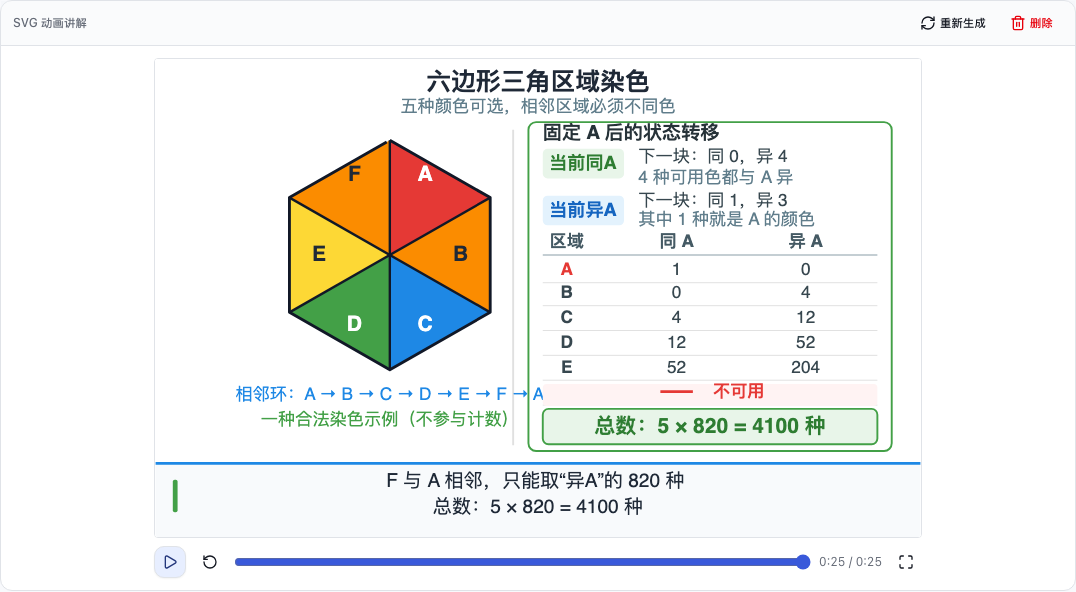
图 7:SVG 逐步动画与板书演示真实截图。图形随逻辑分步构建,并可结合云端语音朗读生成沉浸式微课堂。
配合严格的本地精准比对算法,系统坚决杜绝大模型和稀泥式的模糊判分,错就是错、对就是对,让孩子在每一步推导中都保持严谨求实的态度。
4. 手术四:把厨房塞进登山包——安卓单机版沙盒引擎
为了解决没有家庭服务器的问题,我们完成了一项极具挑战性的工程创新:推出安卓单机版 APK。
在传统的软件架构中,前端界面和后端服务器是分开的,必须有云端服务器支撑。而 wrong-notebook 的安卓单机版,就像是把整套厨师团队(Node.js 运行时)和食材仓库(SQLite 嵌入式数据库)直接打包压缩进了一个便携式登山野餐盒里。
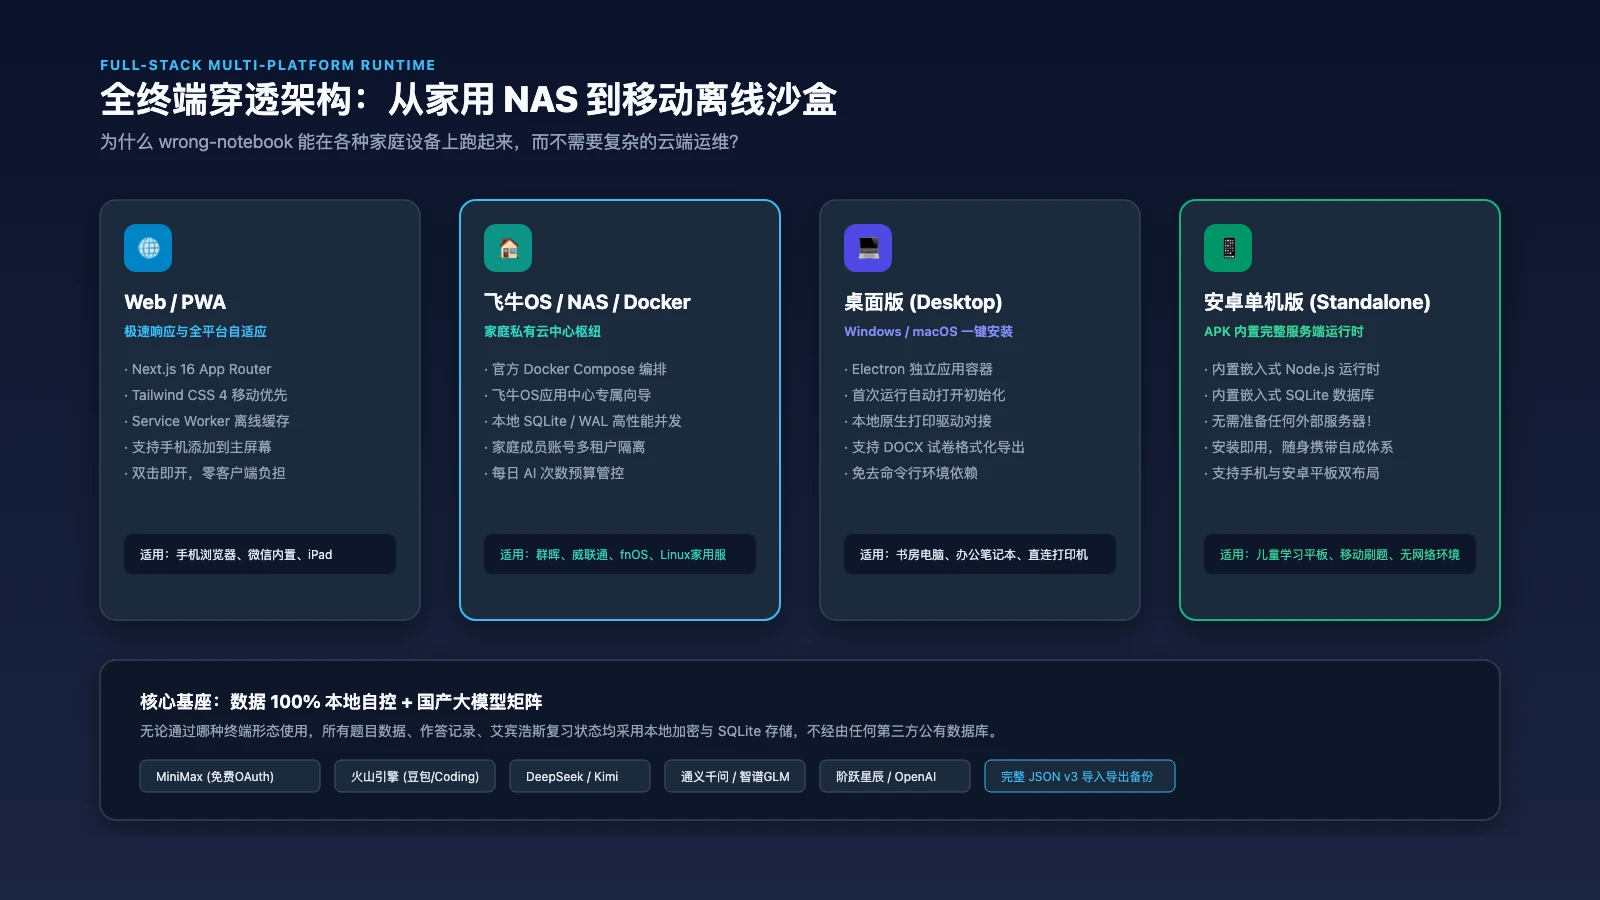
图 8:本文原创全平台架构图。涵盖现代 Web/PWA、飞牛OS 与 Docker 私有云、桌面版 Electron、以及内置 Node+SQLite 的安卓独立单机版。
家长只需要在普通的安卓平板或手机上安装一个 APK 文件,软件在启动时就会在移动设备内部自动唤起轻量服务端环境。不需要购买云服务器,不需要在路由器上做复杂的端口映射,更不需要担心孩子的数据被上传到不可控的公共网盘,断网时也能流畅复习。
5. 手术五:量体裁衣的真实考卷——人教版课标标签与智能排版打印
在纸质作答场景中,家长最常遇到的尴尬是打印排版:很多题目从网页复制下来,选择题选项挤在同一行难以辨认;简答题下面只留出两行细细的缝隙,孩子的大字根本写不下。
在新版本中,我们正式接入了人教版新课标知识点体系,支持多标签体系并存与自定义卷别分组。更关键的是,我们开发了智能打印留白算法与 DOCX 导出功能:
- 题型感知留白:系统能自动辨识题型,选择题和填空题保持紧凑间距,解答题和大题则自动根据题目难度和推导步骤预留出充足的作答空白;
- 选项自动换行:选择题的 A、B、C、D 选项自动规整对齐另起一行,还原正规试卷版式;
- 全局与单题微调:家长可以在打印预览中一键调大全卷留白,也可以针对某一道需要画图的难题单独拉大答题区域。
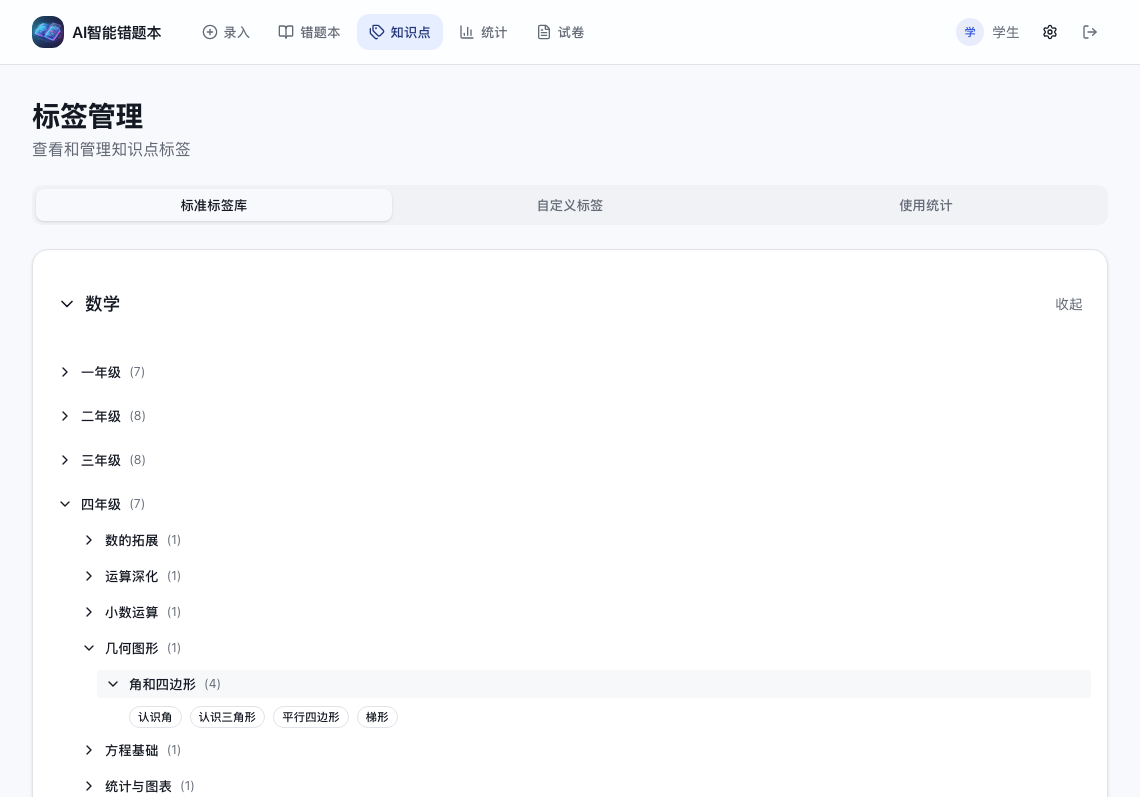
图 9:系统内置的人教版新课标知识点管理体系真实截图。支持多级树状结构、精准关联与跨科目多标签集切换。
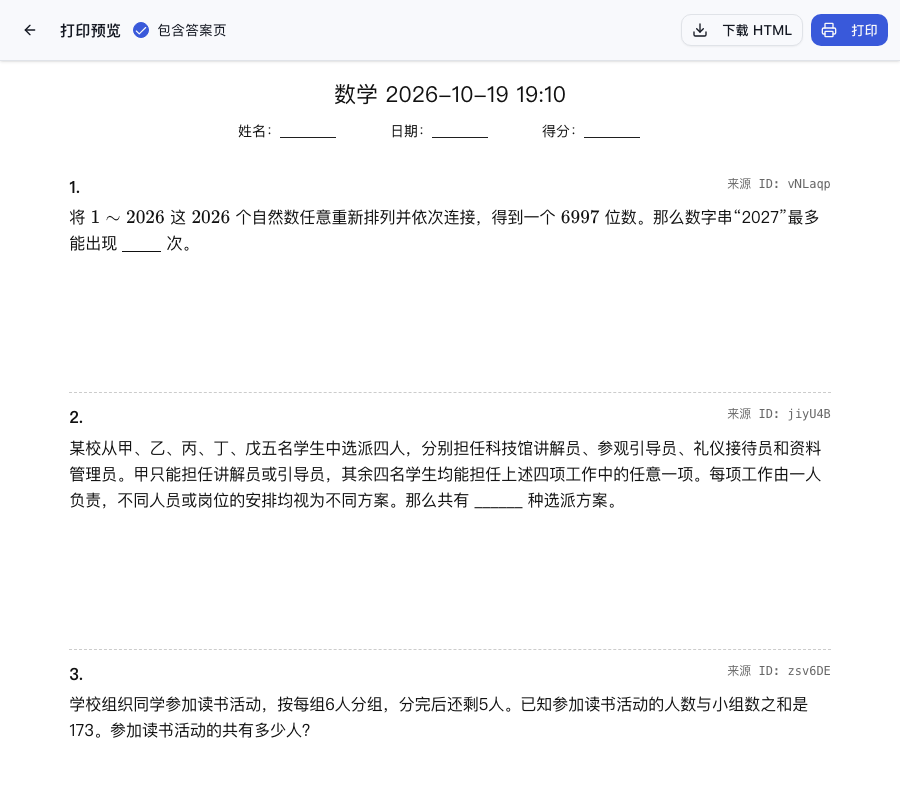
图 10:组卷打印真实预览截图。支持根据题型自动计算作答留白间距、选项规整另起一行,并可一键导出标准 DOCX 试卷。
五、如何解决问题:三种系统的一键全自动启动脚本
很多读者看到这里,最关心的就是如何在自己的电脑或家庭设备上迅速跑起来亲身体验。
为了让大家零摩擦上手,我们编写了分别适配 Windows 11、Ubuntu 26.04 和 macOS 27 的一键启动脚本。所有脚本均采用全自动环境嗅探,优先使用标准 Docker 容器编排,未安装 Docker 时自动降级为原生 Node.js 环境,全程不需要依赖任何第三方闭源服务。
方法一:人工一键全自动执行
1. Windows 11 全自动启动脚本 (PowerShell)
在 Windows 11 上,打开 PowerShell(无需特别提升管理员权限,普通用户即可执行),粘贴并运行以下代码:
# Windows 11 一键全自动启动 wrong-notebook
$ErrorActionPreference = "Stop"
Write-Host ">>> [1/4] 正在检测系统环境与依赖..." -ForegroundColor Cyan

$AppDir = Join-Path $HOME "wrong-notebook"
if (!(Test-Path $AppDir)) {
    Write-Host ">>> [2/4] 克隆最新开源代码仓库..." -ForegroundColor Cyan
    git clone --depth 1 https://github.com/margrop/wrong-notebook.git $AppDir
} else {
    Write-Host ">>> [2/4] 本地代码已存在,同步最新提交..." -ForegroundColor Cyan
    Set-Location $AppDir
    git pull
}

Set-Location $AppDir

# 优先尝试 Docker 部署
if (Get-Command docker -ErrorAction SilentlyContinue) {
    Write-Host ">>> [3/4] 检测到 Docker 环境,启动高性能容器编排..." -ForegroundColor Green
    docker compose up -d --build
    Write-Host ">>> [4/4] 部署成功!正在打开浏览器..." -ForegroundColor Green
    Start-Sleep -Seconds 3
    Start-Process "http://localhost:3000"
} else {
    # 降级使用 Node.js 启动
    Write-Host ">>> [3/4] 未检测到 Docker,尝试原生 Node.js 启动..." -ForegroundColor Yellow
    if (!(Get-Command node -ErrorAction SilentlyContinue)) {
        Write-Error "未找到 Node.js 或 Docker,请先安装其中之一即可运行。"
    }
    npm ci --registry=https://registry.npmjs.org
    npx prisma generate
    npx prisma migrate deploy
    Write-Host ">>> [4/4] 服务构建完毕,正在前台启动..." -ForegroundColor Green
    Start-Process "http://localhost:3000"
    npm run dev
}
2. Ubuntu 26.04 全自动启动脚本 (Bash)
在 Ubuntu 26.04 终端中,直接复制执行:
#!/usr/bin/env bash
# Ubuntu 26.04 一键全自动启动 wrong-notebook
set -euo pipefail

echo ">>> [1/4] 正在准备工作目录..."
TARGET_DIR="${HOME}/wrong-notebook"
if [[ ! -d "${TARGET_DIR}" ]]; then
  echo ">>> [2/4] 拉取最新开源仓库代码..."
  git clone --depth 1 https://github.com/margrop/wrong-notebook.git "${TARGET_DIR}"
else
  echo ">>> [2/4] 检测到已有仓库,执行增量更新..."
  cd "${TARGET_DIR}" && git pull
fi

cd "${TARGET_DIR}"

if command -v docker &>/dev/null && docker compose version &>/dev/null; then
  echo ">>> [3/4] 检测到 Docker 守护进程,构建并启动独立服务容器..."
  docker compose up -d --build
  echo ">>> [4/4] 服务启动成功!访问入口:http://127.0.0.1:3000"
else
  echo ">>> [3/4] Docker 未安装,以原生 Node.js 模式执行初始化..."
  npm ci --registry=https://registry.npmjs.org
  npx prisma generate
  npx prisma migrate deploy
  echo ">>> [4/4] 启动完成,正在监听本地 3000 端口..."
  npm run dev
fi
3. macOS 27 全自动启动脚本 (Zsh)
在 macOS 终端中运行:
#!/bin/zsh
# macOS 27 一键全自动启动 wrong-notebook
set -e

echo ">>> [1/4] 初始化 macOS 本地工作区..."
APP_PATH="${HOME}/wrong-notebook"
if [[ ! -d "${APP_PATH}" ]]; then
  echo ">>> [2/4] 从 GitHub 检出最新源码..."
  git clone --depth 1 https://github.com/margrop/wrong-notebook.git "${APP_PATH}"
else
  echo ">>> [2/4] 本地源码目录已存在,拉取最新改动..."
  cd "${APP_PATH}" && git pull
fi

cd "${APP_PATH}"

if command -v docker &>/dev/null; then
  echo ">>> [3/4] 启动 Docker Compose 容器引擎..."
  docker compose up -d --build
  echo ">>> [4/4] 正在唤醒系统默认浏览器..."
  sleep 2
  open "http://localhost:3000"
else
  echo ">>> [3/4] 执行 Node 原生依赖装载与数据库迁移..."
  npm ci --registry=https://registry.npmjs.org
  npx prisma generate
  npx prisma migrate deploy
  echo ">>> [4/4] 正在启动本地服务并打开页面..."
  open "http://localhost:3000"
  npm run dev
fi
方法二:AI Agent / CLI 自动化配置
如果您习惯使用各类智能运维 Agent 或在无头服务器上进行自动化批量配置,可以通过全环境变量注入与非交互指令完成静默启动。
只需让 Agent 执行以下标准操作语料:
[Agent Configuration Directive]
1. Environment Requirements: Git, Docker / Node.js 22+
2. Execution Steps:
   - Run: git clone https://github.com/margrop/wrong-notebook.git /opt/wrong-notebook
   - Set Environment:
     DATABASE_URL="file:./dev.db"
     ALLOW_REGISTRATION="true"
     NEXTAUTH_SECRET="custom_generated_jwt_secret_token_at_least_32_chars"
     NEXTAUTH_URL="http://127.0.0.1:3000"
   - Execute:
     cd /opt/wrong-notebook && npm ci && npx prisma generate && npx prisma migrate deploy && npm run build
   - Healthcheck:
     Verify HTTP GET http://127.0.0.1:3000/api/health returns status 200 OK.
无需任何人工点击,整个服务将在 2 分钟内静默就绪。
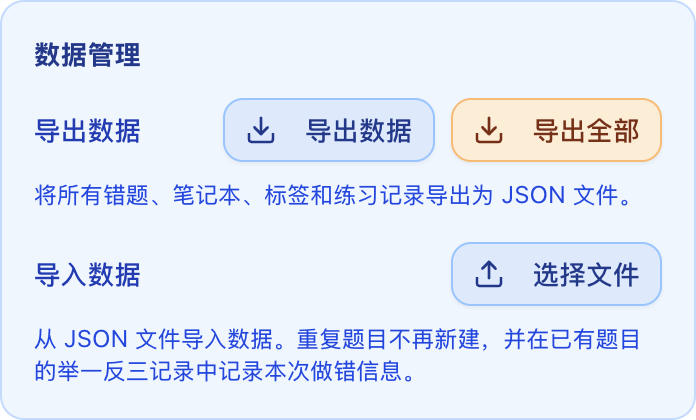
图 11:数据完整性与本地化备份真实截图。所有题目、变式作答、艾宾浩斯复习状态均支持以标准 JSON v3 格式完整导出与导入。
六、深度 Q&A:关于开源、AI 辅导与自托管的那些犀利问题
在项目收获 500+ Star 的过程中,社区 Issues 和技术群里涌现出了许多深刻而具有代表性的讨论。我挑选了其中最核心的几个问题与大家坦诚分享。
Q1:孩子直接用这个工具,会不会产生更严重的依赖?
答:这取决于你把工具交到谁手里。 如果把手机直接扔给低年级孩子,任何智能软件都可能被当成偷懒工具。wrong-notebook 的设计初衷是“亲子协同伴学系统”。在题目的录入和艾宾浩斯复习流中,我们刻意弱化了直接展示答案的冲动,强化了“举一反三”的变式考核。系统可以把原题答案完全遮挡,只生成同类考点的变式题供孩子作答;只有当孩子亲手推导出结果并输入系统后,判定逻辑才会生效。它不是一个“替孩子答题的枪手”,而是一套“检验孩子是否真懂的测谎仪”。
Q2:为什么坚持使用 SQLite,而不是主流的 PostgreSQL 或 MySQL?
答:做技术选型必须克制,不能脱离场景盲目追求宏大架构。 wrong-notebook 的定位是面向个人家庭、极客父母和班级小团队。在家庭环境中,多跑一个 MySQL 容器就意味着多占用几百兆内存,还要处理数据库权限、端口冲突和跨卷持久化;一旦断电或者配置失误,整个系统就无法启动。 而 SQLite 只是一个单一的本地文件,配合 WAL(Write-Ahead Logging)模式,在家庭并发场景下的读写性能极其出色。配合我们设计的 JSON v3 完整备份机制,家长换电脑时只需要把整个文件夹或者单个 db 文件拷贝走,就能实现零损耗迁移。轻量、可靠、自包含,才是最接地气的工程美德。
Q3:国产大模型那么多,普通家庭日常用哪个性价比最高?
答:如果追求完全零成本上手,首选 MiniMax Code OAuth 网页授权通道。官方提供的免费积分非常充裕,完全能覆盖一个普通家庭每天的拍照识别和复习开销。 如果具备一定的 API 调用条件,火山引擎的豆包模型(Doubao)在响应速度和性价比上表现十分亮眼;而 DeepSeek 与月之暗面 Kimi 在较为复杂的初高中数学推理与大题推导上,展现出了极高的逻辑严密性。wrong-notebook 允许管理员按需随时切换渠道,不用被任何单一供应商绑定。
Q4:家庭私有化部署真的能保证孩子的学习隐私吗?
答:绝对可以。 所有错题的照片、识别后的 LaTeX 公式、孩子的作答历史和错题本分类,全部保存在您本地的硬件驱动器中。只有当您触发 AI 识别或生成变式题的那一瞬间,特定的题目文本或裁剪后的题目切片才会通过加密的 HTTPS 通道发送给模型服务商,服务完成后本地不保留任何外部公网连接。这也是为什么我们坚决不做中心化的云端托管服务:孩子的成长痕迹和学习薄弱点,本就该完完全全留在家庭自己的屋檐之下。
七、写在最后:代码终会过时,但陪伴孩子长大的心血不会
从最初在书桌前为了抄题苦恼,写下第一行提交,到如今 GitHub 上 500 多位素昧平生的开发者点亮 Star,这个项目的成长速度远远超出了我最初的预期。
在过去的两周里,我收到过来自小学数学老师的试用反馈,收到过来自跨国华人家长的中英文界面建议,也收到了许多极客爸爸为安卓平板单机版提交的性能优化补丁。
技术的浪潮每隔几个月就会刷新一次名词,大模型的参数规模和排名榜单也总在更迭。但无论 AI 演进到哪一个时代,教育的本质永远是人与人之间的点拨与陪伴。
我希望 wrong-notebook 能够继续成为那座微小而坚固的桥梁:用代码把繁琐枯燥的杂活挡在身后,把宝贵的耐心、时间与微笑,留给台灯下那个正在探索世界、一点点解出难题的孩子。
欢迎访问项目仓库,一起参与探讨与共建: