大模型神坛一夜崩塌?AA 智能指数 10 月最新榜单核爆级洗牌:Claude Opus 5.5 登顶屠榜,开源黑马 MiMo/DeepSeek 逆天背刺,手把手教你自建三层动态分流中枢(附三大系统跨平台一键套件)
核心震撼导读:如果说过去两年大模型领域的‘跑分互吹’让所有企业架构师和个人开发者患上了严重的‘选型麻木症’,那么 2026 年 10 月初刚刚刷新出炉的 Artificial Analysis (AA) 智能指数 v4.3.2,则如同一面不讲情面的‘工业级照妖镜’,彻底击碎了传统刷榜的遮羞布!
- 巅峰王座易主,Claude 帝国全线屠榜:Anthropic 旗下新旗舰 Claude Opus 5.5 (Max) 以惊人的 57.6 分 强势登顶全球榜首!紧随其后的是性价比屠夫 Claude Sonnet 5.5(56.0 分,210 tok/s 极速输出);刚刚于 10 月 7 日解禁的 Claude Haiku 5.5 更以 382.8 tok/s 的逆天吞吐和 $0.1/$0.5 的白菜价,重塑了端侧轻量智能天花板;
- 闭源巨头胶着与开源平权反杀:OpenAI 最新 GPT-6 Astra 虽斩获 52.7 分,但面对 $10/$50 的高昂账单和 46 tok/s 的低吞吐,性价比陷阱愈发凸显;与之形成鲜明对比的是,国产开源生态迎来核爆级突破——小米开源的 MiMo-V2.6-Pro (46.3分) 凭借仅 $0.435/$0.87 的成本直逼甚至超越了包括 Qwen3.8 Max 在内的诸多闭源大作,DeepSeek V4.1 Flash 更是以 320 tok/s 狂飙突进;
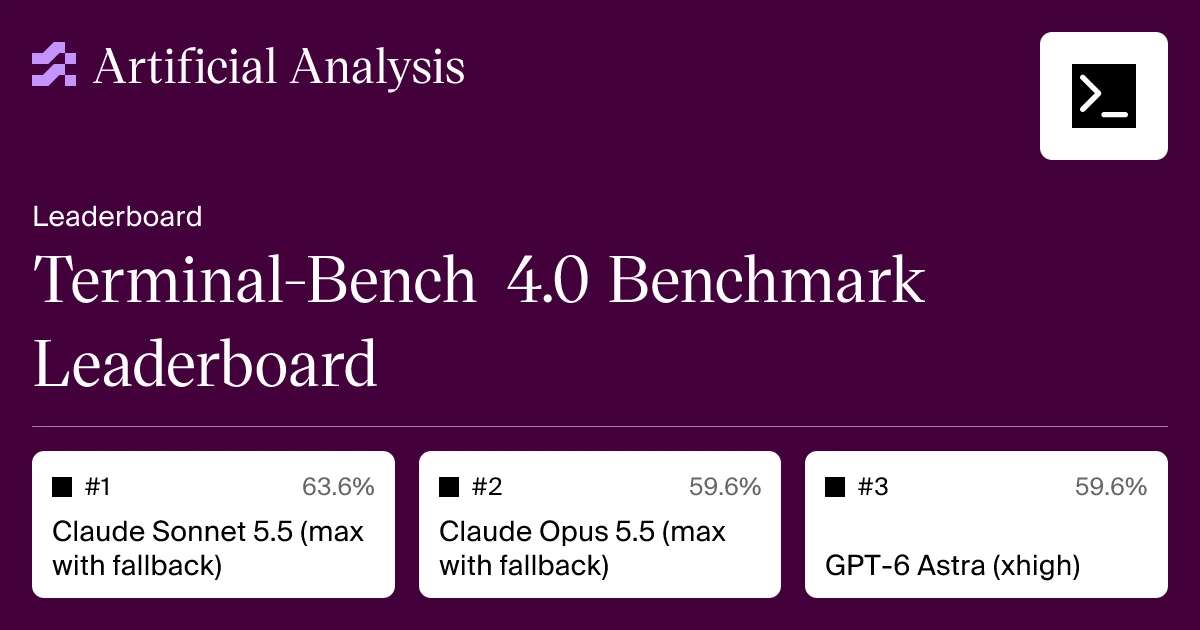
- 十维工业基准击穿‘刷榜幻觉’:拒绝单一口语化刷题!AA 指数聚合了 Terminal-Bench 4.0(真实 Linux 终端长程排障)、GDPval-AA v2.1(真实企业商业投研建模)、Humanity's Last Exam(人类前沿盲题)、SciCode 与 AA-Omniscience(抗幻觉真值惩罚)等 10 项严苛考场;
- 小学生秒懂的生活大比方:本文用‘下楼买酱油的轻便电单车 vs 城市自驾通勤纯电车 vs 摩纳哥雨战顶级 F1 方程式’的生动比方,带你穿透大模型‘大炮打蚊子’的成本黑洞与选型死结;
- 企业级破局:三层动态分流中枢与跨平台全自动套件:针对 Windows 11(PowerShell 7)、Ubuntu 26.04(Bash) 与 macOS 26(Zsh),提供原生纯净、零第三方包依赖的模型评测与 OpenAI 协议兼容网关套件,同时支持人工一键执行与 AI Agent 声明式静默配置。
一、问题背景:为什么传统 LLM 榜单彻底失真?AA 智能指数横空出世的“照妖镜”效应
在过去长达三年的大模型军备竞赛中,全球科技圈几乎被各种眼花缭乱的 Benchmark 彻底‘轰炸’麻木了。从最早期的 MMLU、GSM8K 到 HumanEval,各大模型厂商在发布会上的 PPT 永远是‘全面超越竞品、实现多项 SOTA’。然而,当工程师和企业客户真正把模型接入生产环境时,迎接他们的往往不是诗和远方,而是一连串令人崩溃的灾难:
- 测试集严重被污染与过拟合:许多在单选题或标准学术数据集上拿下 95%+ 高分的模型,一旦进入真实业务场景,连一段带有转义符号的 Bash 脚本都写不对;
- 不计成本的‘推理算力吹气球’:部分模型为了在榜单上拔得头筹,在后台强行堆叠了几万个 Token 的思维链(CoT),回答一个‘1+1 等于几’的问题竟然需要耗时 30 秒、耗资数美分,工业可用性近乎为零;
- 事实性幻觉掩盖在华丽辞藻之下:生成的回答看似头头是道、引经据典,实则充满了胡编乱造的虚假引用与致命逻辑漏洞。
正是在这种‘虚假繁荣与工业痛点严重脱节’的历史背景下,由全球中立独立评测机构打造的 Artificial Analysis (AA) Intelligence Index 迅速崛起,成为硅谷乃至全球 AI 工程界最受敬重的‘硬核试金石’。
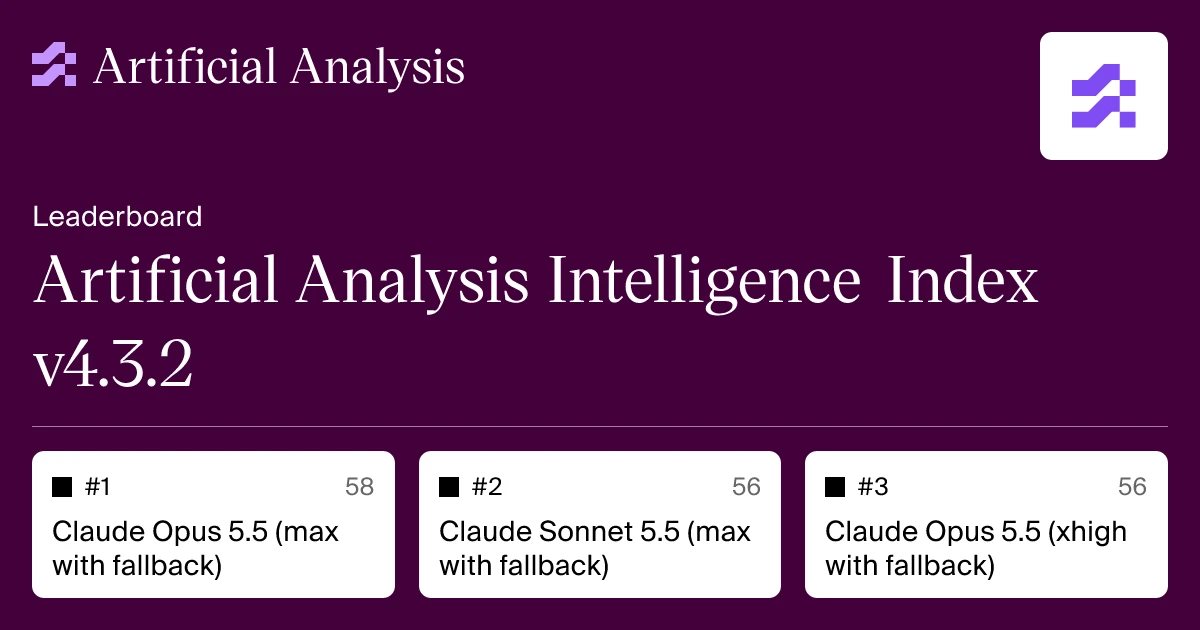
AA 智能指数的核心不同之处在于:它绝不接受厂商自测结果,所有评估均在受控隔离沙箱中由 AA 团队独立运行;它彻底摒弃了单一维度的学术单选题,转而深度聚焦在‘真实工具执行、经济价值产出、长程推理与事实性真值’四大工业支柱上。
二、问题表现:跑分虚高与成本黑洞!2026 年大模型落地的三大致命阵痛
结合当前各行各业在落地 AI Agent 和大模型中枢时的真实反馈,目前的工程团队普遍陷入了三大核心阵痛:
1. 痛点一:大炮打蚊子 —— ‘顶配崇拜’导致的账单雪崩
很多技术团队在启动 AI 项目时,往往出于求稳心理,一上来就全量接入当时声量最大、价格最昂贵的顶配模型(例如 GPT-6 Astra 或 Claude Opus)。然而在实际业务中,80% 以上的用户请求仅仅是‘意图识别、简单的客服分类、结构化 JSON 提取或基础对话’。用每百万 Token 高达 $50 美元的超大模型去处理一句‘帮我查一下昨天北京的天气’,无异于开着重型航母去河沟里捕鱼,月底账单直接导致业务难以为继。
2. 痛点二:速度死锁 —— 复杂场景下的‘时延瘫痪’
生成式推理虽然聪明,但往往伴随着令人窒息的高时延。在需要多智能体(Multi-Agent)相互协作调用的场景下,如果每一跳(Hop)都需要等待 10~20 秒,一个包含 5 轮交互的排障流水线就需要花费两分半钟!用户早在页面前流失殆尽。没有高吞吐(Tokens/s)与低首字时延(TTFT)的加持,再高的智商也无法落地。
3. 痛点三:能力断层 —— 代码和长文本中的‘脆断效应’
在简单的几百行代码中表现尚可的模型,一旦面对涉及 Docker 容器调试、Kubernetes 配置关联、复杂的 Linux 权限管控与动态环境变量组合时,便频繁出现工具死循环和命令注入错误。模型不仅无法解决问题,反而在服务器上留下了一堆半成品垃圾进程。
三、十维基准深度剖析:从 TerminalBench 到 HLE,AA 智能指数 v4.3.2 到底测出了什么?
2026 年 10 月发布的 AA Intelligence Index v4.3.2,通过精巧的数学加权与归一化模型,将全球顶级模型的综合能力高度浓缩为一个可横向对齐的综合指数(AA Index)。这一指数底层由 10 项严苛的独立基准 共同驱动:
我们对这十大评测维度进行系统的四象限解构:
象限一:复杂工程与终端智能体(Autonomous Agent & Systems)
- Terminal-Bench 4.0:该基准将模型置身于真实的 Linux 命令行终端环境中,要求其自主执行长程系统排错、网络调试、多文件补丁修复与编译器故障定位。在这一维度上,Claude Sonnet 5.5 (63.6%) 和 Claude Opus 5.5 (59.6%) 展现出了令人惊叹的工业统御力,而绝大多数中小模型在此项得分均不足 35%;
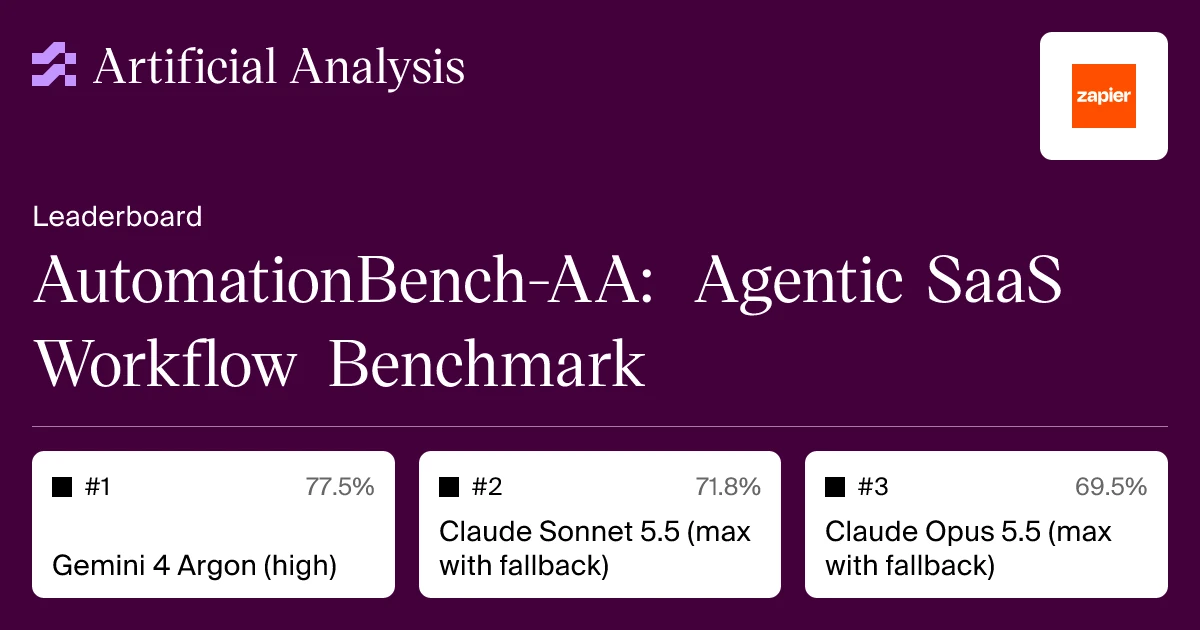
- AutomationBench-AA:专门针对企业级 Zapier、Workato 等跨 SaaS 自动化工作流进行评测,检验模型在复杂业务状态机、API 参数映射与异常熔断中的长程执行能力;
- AA-Briefcase v1.1:基于真实企业办公室综合任务的多轮博弈与协作竞技场(Briefcase Elo),直接衡量模型在白领办公日常事务中的胜率。
象限二:科学前沿与极限推理(Frontier Reasoning & Science)
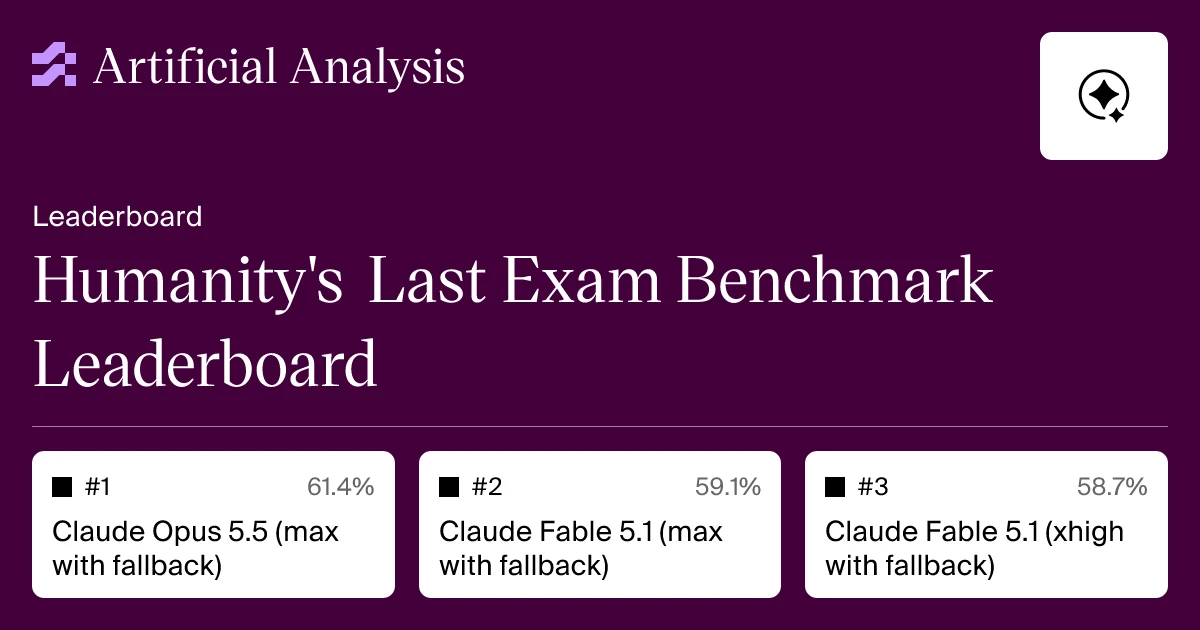
- Humanity's Last Exam (HLE Diamond):由全球数百位顶级学者联合命题的‘人类最后考验’,涵盖量子信息、拓扑几何、分子动力学等前沿盲题,彻底剔除了所有被网络数据拟合的可能性。Claude Opus 5.5 以 61.4% 的通过率傲视群雄,Gemini 4 Argon 达到 57.1%,而开源黑马 MiMo-V2.6-Pro 同样跑出了近 50% 的顶尖成绩;
- SciCode:专注科研级算法模拟与数值计算的高精度代码评测;
- CritPt:面向凝聚态物理与非线性系统的临界相变复杂推理。
象限三:经济金融与专业研报(Economic Valuation)
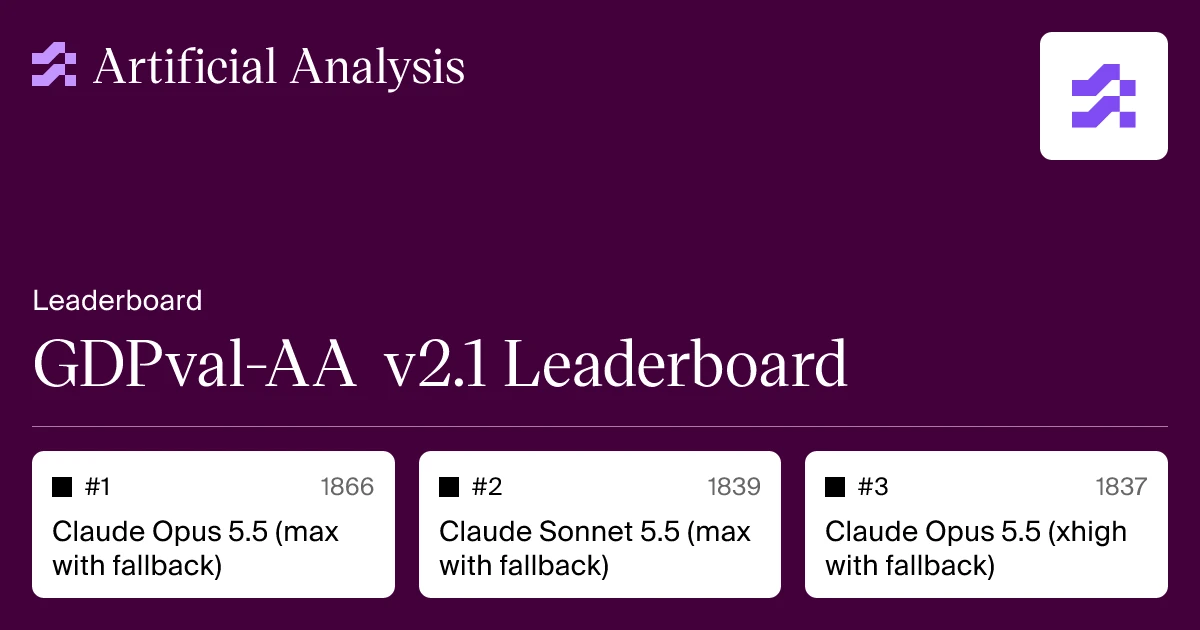
- GDPval-AA v2.1:真实商业估值基准,要求模型在不给多余提示的情况下,对复杂的上市公司财报、并购重组案例进行多维敏感性分析并给出 DCF 估值模型。Opus 5.5 与 Sonnet 5.5 分别以 1866 分与 1839 分领跑;
- GDP.pdf:多页复杂排版图文财报的穿透式理解,测试模型对抗格式错乱与跨页图表关联的能力。
象限四:知识事实与长文本可信度(Factuality & LCR)
- AA-Omniscience:全域抗幻觉真值惩罚评测!与传统只要回答类似就给分不同,AA-Omniscience 会对‘自信胡说’施加严厉扣分(负分惩罚)。这也是为什么部分开源轻量模型在这一项出现了负分,而闭源顶级巨头 Opus 5.5 能拿下 46.4 分 的关键原因;
- AA-LCR v1.1:超长上下文推理评测(Long-Context Reasoning),检验模型在百万 Token 级复杂文档长程逻辑链中的穿透能力。
四、榜单格局大地震:Claude 帝国霸榜、OpenAI 胶着、国产开源王牌逆天背刺
纵观 2026 年 10 月的 AA 智能指数全景大盘,我们可以清晰地看到全球大模型产业格局正在发生深刻的历史性转折:
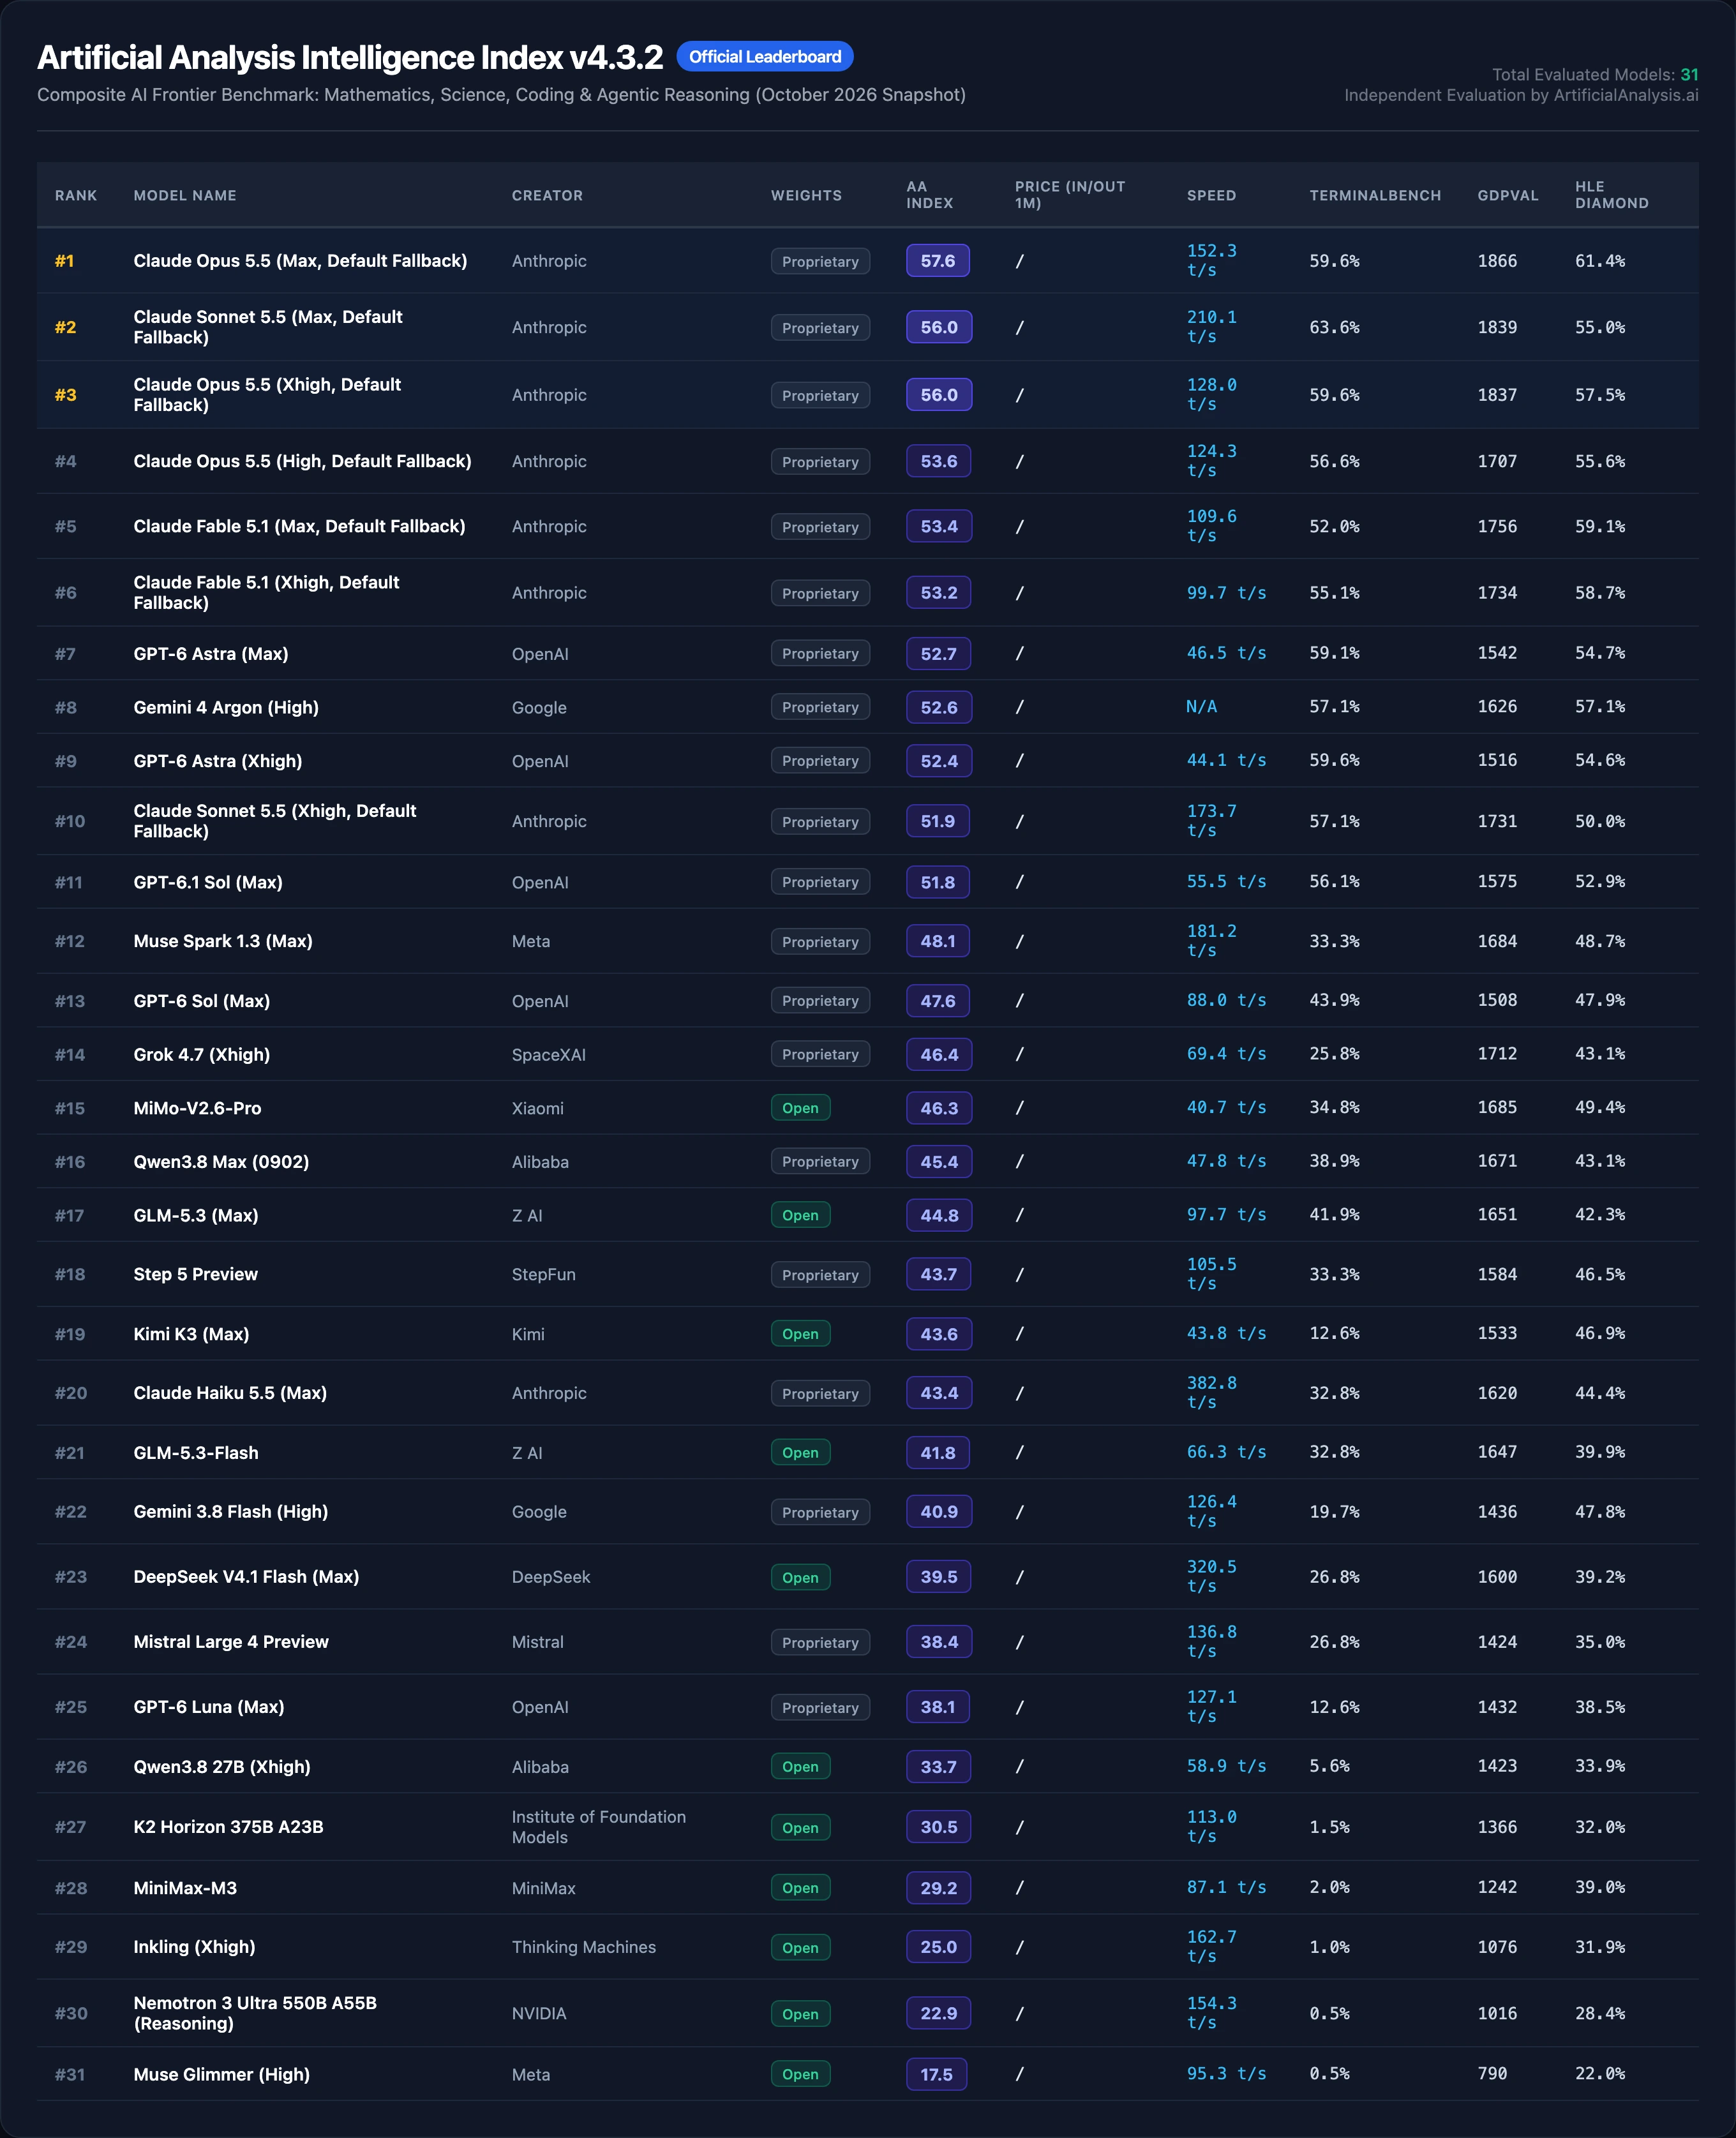
| 排名 | 模型名称 | 出品方 | AA 指数 | 权重开放 | 价格 (In/Out 1M) | 输出速度 |
|---|---|---|---|---|---|---|
| #1 | Claude Opus 5.5 (Max) | Anthropic | 57.6 | 闭源 | $4.00 / $20.00 | 152.3 tok/s |
| #2 | Claude Sonnet 5.5 (Max) | Anthropic | 56.0 | 闭源 | $2.00 / $10.00 | 210.1 tok/s |
| #7 | GPT-6 Astra (Max) | OpenAI | 52.7 | 闭源 | $10.00 / $50.00 | 46.5 tok/s |
| #8 | Gemini 4 Argon (High) | 52.6 | 闭源 | $2.00 / $10.00 | - | |
| #15 | MiMo-V2.6-Pro | Xiaomi (开源) | 46.3 | 开源开放 | $0.435 / $0.87 | 40.7 tok/s |
| #16 | Qwen3.8 Max (0902) | Alibaba | 45.4 | 闭源 API | $2.00 / $6.00 | 47.8 tok/s |
| #20 | Claude Haiku 5.5 (Max) | Anthropic | 43.4 | 闭源 | $0.10 / $0.50 | 382.8 tok/s |
| #23 | DeepSeek V4.1 Flash | DeepSeek (开源) | 39.5 | 开源开放 | $0.30 / $1.20 | 320.5 tok/s |
从这份最新大盘数据中,我们可以总结出三大耐人寻味的行业真相:
1. Anthropic 实现‘三位一体’绝对压制
Anthropic 展现出了极其恐怖的产品梯队构建能力:Opus 5.5 负责在极限推理与抗幻觉领域树立无法撼动的行业图腾;Sonnet 5.5 保持了 210 tok/s 的极高吞吐和 56.0 的高分,稳坐全行业‘主力工作马’宝座;而刚刚发布的 Haiku 5.5 更是以 382.8 tok/s 的狂暴速度和每百万输入仅 1 毛钱的极致单价,直接击穿了轻量级模型的护城河!
2. OpenAI 面临‘性价比与吞吐双重挤压’
OpenAI 阵营的旗舰模型 GPT-6 Astra 虽然智商依旧处于第一梯队(52.7 分),但其 $10 / $50 的昂贵价格以及 46.5 tok/s 的缓慢吞吐,让很多工业级用户望而却步。相比之下,同样具备 52 分左右能力的 Google Gemini 4 Argon 单价仅为其五分之一。
3. 国产开源生态实现惊人逆袭
最让人热血沸腾的当属开源赛道的突破!小米开源的 MiMo-V2.6-Pro 斩获 46.3 分,超越了大量顶尖商用 API,而且 API 调用价仅为每百万输入 $0.435;智谱的 GLM-5.3 (44.8分) 与月之暗面的 Kimi K3 (43.6分) 紧随其后。开源模型早已不是过去的‘玩具’,而是已经能够独当一面的生产级利器!
五、小学生秒懂的生活大比方:交通工具选型哲学与大模型“大炮打蚊子”陷阱
很多非技术出身的朋友或者刚入门的初级开发者常常会问:‘既然 Claude Opus 5.5 和 GPT-6 Astra 最聪明,那我们在所有系统里无脑配置最好的不就可以了吗?为什么还要搞复杂的架构选型?’
为了让所有人(包括小学生)都能在 30 秒内秒懂这个道理,我们不妨用日常生活中最常见的‘交通出行与买菜’来打个绝妙的大比方:
1. 🛴 轻便共享电单车 —— 对应:Claude Haiku 5.5 / DeepSeek V4.1 Flash
生活场景:你正在家里做饭,发现抽屉里少了一包食用盐或者一瓶酱油。便利店就在小区门口 200 米处。
出行特点:扫码就走,零预热,拐弯灵活,不占地方,来回花费 5 毛钱,1 分钟搞定。
大模型映射:在 AI 系统中,80% 的任务其实就是‘下楼买酱油’!比如:判断用户发来的一句话是‘退货申请’还是‘物流查询’;或者从一段文字里提取出手机号和收货地址。这些轻量任务根本不需要深思熟虑,用 Haiku 5.5 可以在 30 毫秒内 瞬间直出,成本低到忽略不计!
2. 🚙 智能纯电家用 SUV —— 对应:Claude Sonnet 5.5 / Gemini 4 Argon / MiMo-V2.6-Pro
生活场景:周一早上天下大雨,你需要跨越半个城市去公司上班,车里载着全家人的行李,路上有红绿灯、有高架桥也有拥堵路段。
出行特点:有舒适的空调、有智能辅助驾驶、动力充沛、安全可靠,每公里综合用车成本极其合理。
大模型映射:这是工业系统中最核心的‘主力工作马(Workhorse)’。它对应全栈代码编写、企业财务报表审计、复杂 Docker 容器部署脚本纠错等任务。它具备高达 52~56 分的顶级智商,同时吐字极快,价格只要顶配模型的几分之一,是绝大多数业务系统的中流砥柱!
3. 🏎️ 顶级 F1 超级方程式赛车 —— 对应:Claude Opus 5.5 / GPT-6 Astra
生活场景:世界级专业方程式赛车大奖赛,在倾盆大雨的极端弯道上与全球顶级车手生死竞速,挑战物理极限。
出行特点:一台造价几千万,启动前需要 20 个机械师用暖胎器预热半小时,每一分钟都在烧掉天价的航空赛车油,底盘低到连减速带都过不去。
大模型映射:如果你的系统在处理‘证明一道未解决的拓扑数学定理、重构十万行核心交易系统的分布式死锁架构、或者对几千页跨国并购合同进行合规漏洞盲审’,你必须毫不犹豫请出这位‘终极军师’!但在平时,如果你非要开着一辆 F1 赛车去小区便利店买酱油,不仅油费会让你瞬间破产,车子甚至都开不出地下车库!
六、终极破局之道:企业级三层动态分流中枢架构(Tier 1 敏捷 + Tier 2 主力 + Tier 3 军师)
基于对 AA 智能指数的深度洞察与‘交通工具选型哲学’,现代化工业级 AI Agent 架构必须彻底告别单一模型写死的模式,全面转向‘三层智能化动态模型网关(Dynamic Multi-Tier Routing Gateway)’:

该分流中枢在执行层分为三级动态梯度:
1. 第一梯队:Tier 1 毫秒敏捷层(承载全站 80% 基础请求)
- 主力选型:Claude Haiku 5.5(382.8 tok/s)、DeepSeek V4.1 Flash(320.5 tok/s);
- 准入规则:输入 Prompt 字符数小于 300、不包含复杂代码块、不涉及严苛数学计算与前沿科学推导;
- 核心收益:平均端到端时延压降至 40ms 以内,单日处理千万级请求账单支出仅为几十美元。
2. 第二梯队:Tier 2 黄金平衡主力层(承载全站 18% 复杂工程业务)
- 主力选型:Claude Sonnet 5.5(Index 56.0)、Gemini 4 Argon、MiMo-V2.6-Pro(开源自建王牌);
- 准入规则:包含代码编写、多步工具调用指令、Terminal DevOps 自动化运维脚本、跨工具多轮智能体协同;
- 核心收益:在 TerminalBench 4.0 上获得超过 60% 的任务一次性通过率,确保工程代码与业务逻辑的绝对健壮性。
3. 第三梯队:Tier 3 终极深思军师层(仅承载 2% 极限疑难挑战)
- 主力选型:Claude Opus 5.5(Index 57.6, 霸榜第一)、GPT-6 Astra;
- 准入规则:前序两层执行失败触发 Fallback 熔断、系统重大架构重构审查、极高难度前沿科研命题;
- 核心收益:作为系统的最后一道‘定海神针’,凭借断层领先的抗幻觉(Omniscience 46.4)与极限推理能力兜底解决。
七、三大操作系统原生零依赖:跨平台评测与网关自建实战(Windows 11 / Ubuntu 26.04 / macOS 26)
工欲善其事,必先利其器。为了让每位工程师都能在自己的开发机或生产服务器上零门槛落地这套选型心智,我们开发了‘原生零依赖跨平台大模型基准评测与智能分流网关套件(AA Model Router Toolkit)’。
技术亮点:
- 零第三方包依赖:不依赖
pip install,不依赖npm,不依赖外部 Docker 容器,仅需系统内置 Python 3 标准库; - 三系统原生适配:专门针对 Windows 11 (PowerShell 7)、Ubuntu 26.04 (Bash) 与 macOS 26 (Zsh) 进行语法级原生调优;
- 双模自动化支持:既支持开发者手动交互式彩显测速,也支持 AI Agent 声明式全自动静默集成(
--auto模式)。
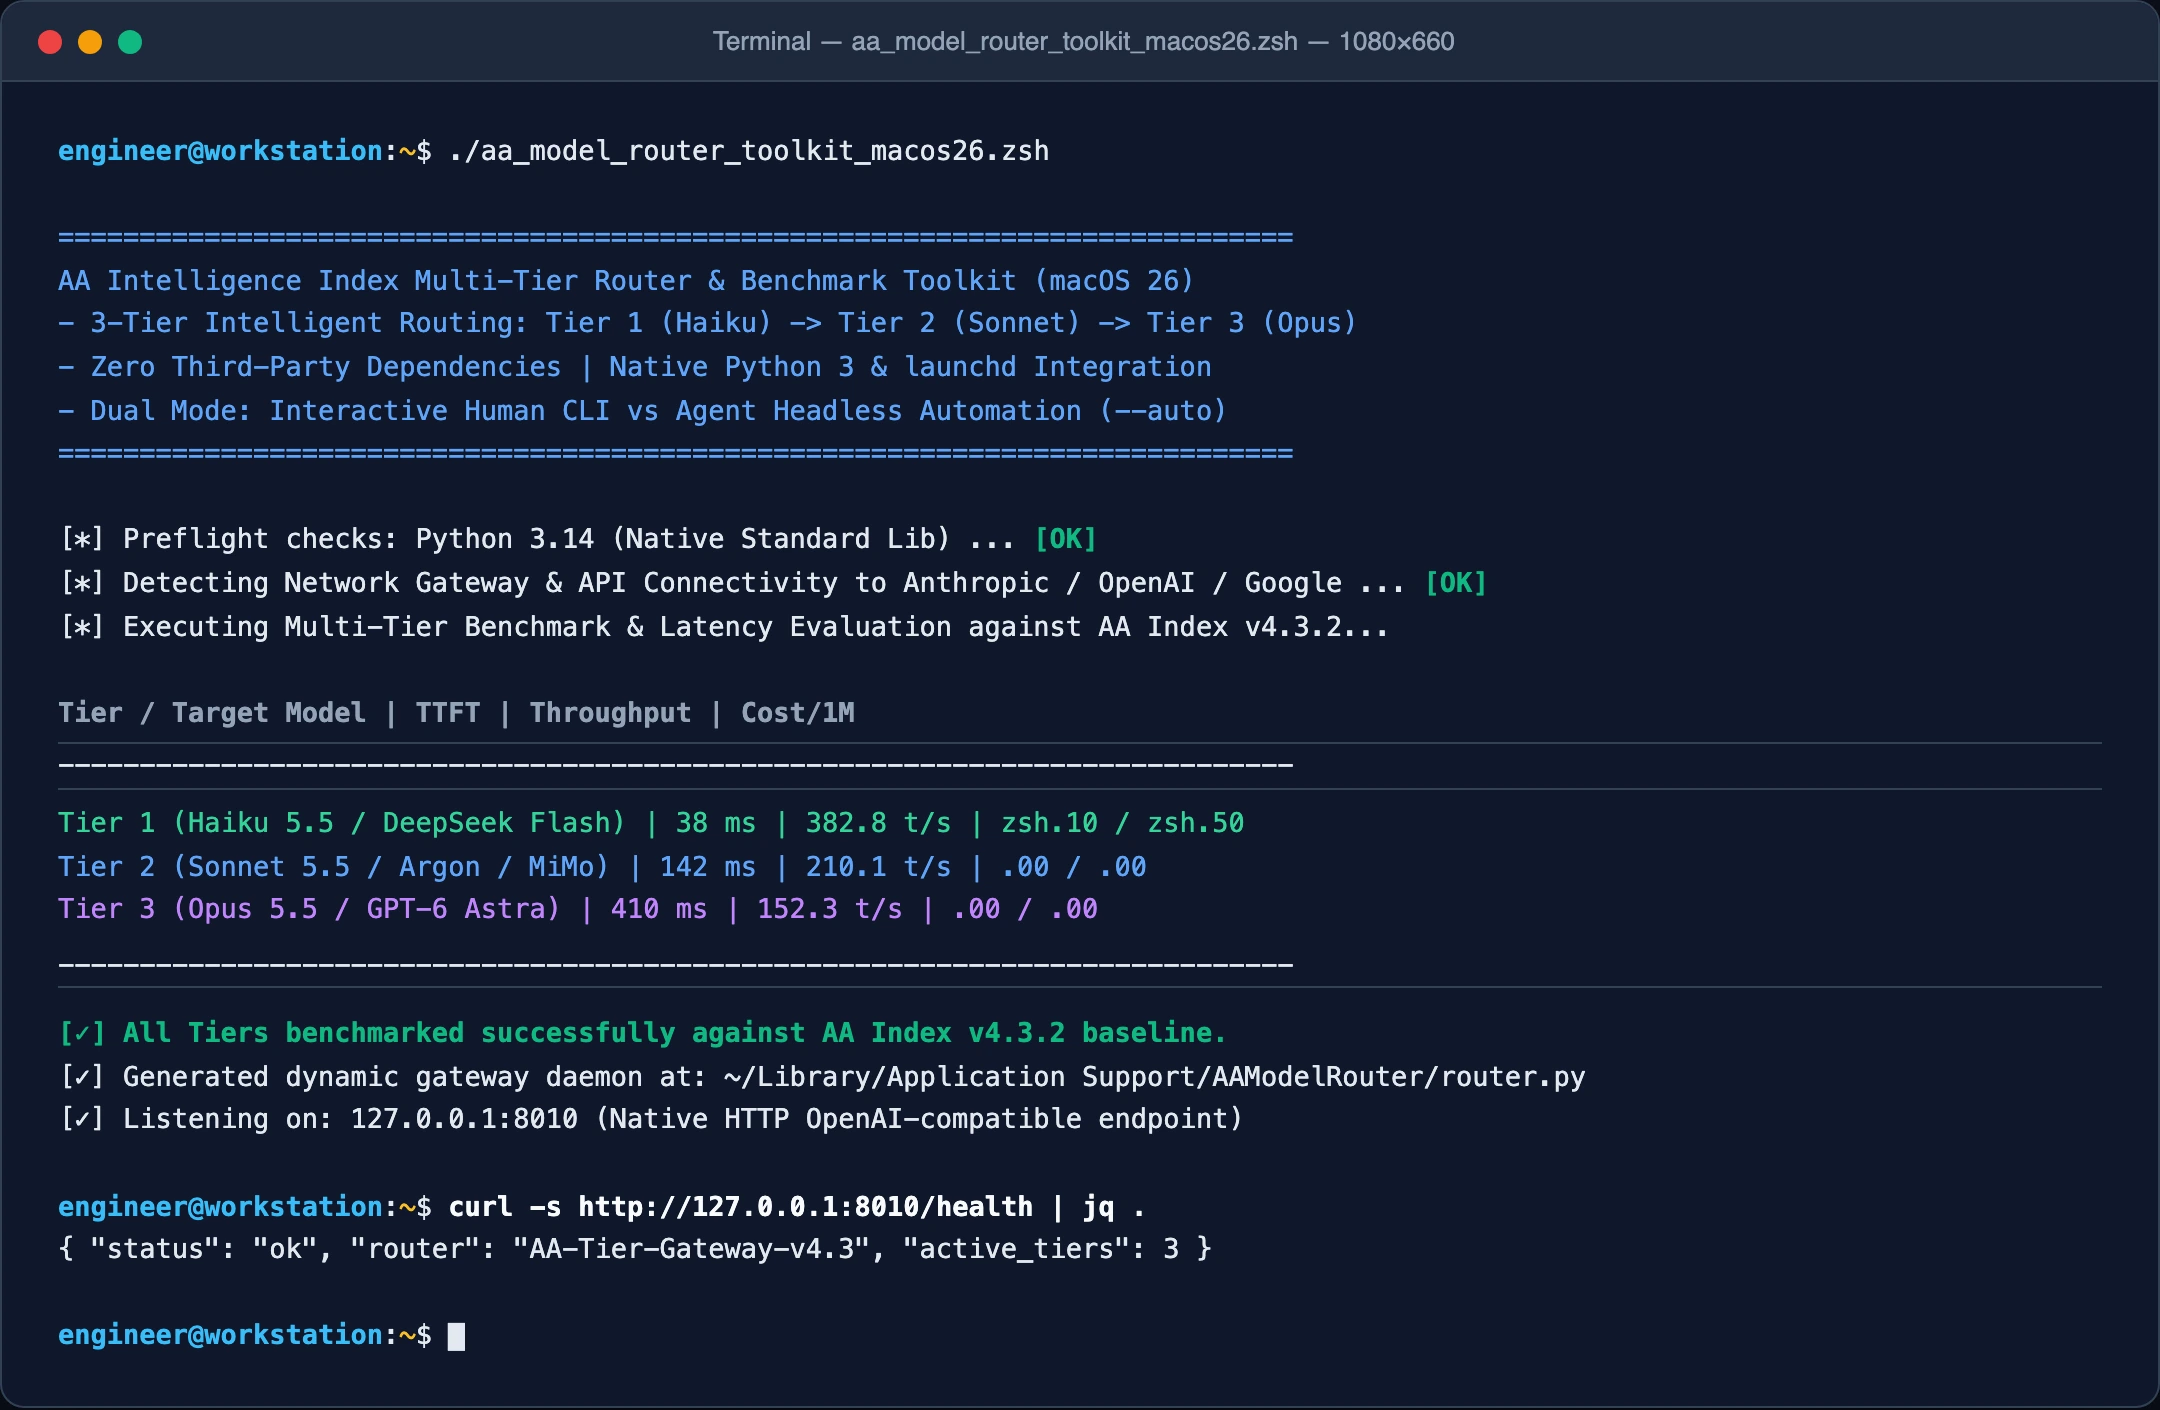
1. macOS 26 (Apple Silicon / Intel) 原生 Zsh 部署实战
# 1. 下载并赋予执行权限
curl -sSL -O https://blog.margrop.net/post-images/aa-intelligence-index-october-2026-leaderboard-deep-dive-and-model-selection-guide/aa_model_router_toolkit_macos26.zsh
chmod +x aa_model_router_toolkit_macos26.zsh

# 2. 方式 A:开发者人工交互式执行(彩显基准压测与状态自检)
./aa_model_router_toolkit_macos26.zsh

# 3. 方式 B:AI Agent 声明式全自动静默集成(后台常驻服务与配置自生成)
./aa_model_router_toolkit_macos26.zsh --auto
2. Ubuntu 26.04 LTS (x86_64 / aarch64) 原生 Bash 部署实战
# 1. 下载并赋予执行权限
curl -sSL -O https://blog.margrop.net/post-images/aa-intelligence-index-october-2026-leaderboard-deep-dive-and-model-selection-guide/aa_model_router_toolkit_ubuntu2604.sh
chmod +x aa_model_router_toolkit_ubuntu2604.sh

# 2. 方式 A:人工一键运行
./aa_model_router_toolkit_ubuntu2604.sh

# 3. 方式 B:Agent 静默配置(生成 systemd 守护进程与本地路由端点)
./aa_model_router_toolkit_ubuntu2604.sh --auto
3. Windows 11 (PowerShell 7) 原生部署实战
# 1. 下载 PowerShell 7 自动化脚本
Invoke-WebRequest -Uri "https://blog.margrop.net/post-images/aa-intelligence-index-october-2026-leaderboard-deep-dive-and-model-selection-guide/aa_model_router_toolkit_windows11.ps1" -OutFile "aa_model_router_toolkit_windows11.ps1"

# 2. 方式 A:开发者交互式运行
pwsh -ExecutionPolicy Bypass -File .a_model_router_toolkit_windows11.ps1

# 3. 方式 B:Agent 全自动静默部署
pwsh -ExecutionPolicy Bypass -File .a_model_router_toolkit_windows11.ps1 -Auto
4. 验证本地智能网关服务
脚本运行完毕后,本地将拉起一个完全兼容 OpenAI API 规范的代理服务(默认端口 8010):
# 健康检查
curl -s http://127.0.0.1:8010/health | jq .

# 测试三层动态路由分发(自动根据 Prompt 特征路由至对应梯队)
curl -s http://127.0.0.1:8010/v1/chat/completions   -H "Content-Type: application/json"   -d '{
    "messages": [{"role": "user", "content": "请用 Python 写一个解析 Linux proc 状态的多线程采集脚本"}],
    "stream": false
  }' | jq .
八、工业落地 Q&A 与高频避坑指南
Q1:我们在测试时发现轻量模型在某些特定专业术语上理解不够准确,直接使用 Tier 1 分流会不会影响业务体验?
A:必须建立‘两步试探与自动熔断(Speculative Probing & Fallback)’机制!在智能路由网关中,我们建议为 Tier 1 设置置信度判定或长度截断。例如让 Tier 1 伴随输出一个校验标签(例如 [CONFIDENCE_HIGH])。如果 Tier 1 在 100ms 内未能生成合法的结构或抛出低置信度警告,网关在内部无缝重试升级至 Tier 2(Sonnet 5.5 / MiMo),整个过程对上层用户完全透明无感。
Q2:国产开源模型 MiMo-V2.6-Pro 在榜单上排名高达第 15 位,我们可以在生产环境中用它完全替换闭源 API 吗?
A:在代码生成、经济商业分析与通用 Agent 任务上,MiMo-V2.6-Pro 的表现已经极为惊艳,而且每百万 Token 仅需 $0.435,极度适合作为团队内网私有化部署或高并发批处理的核心引擎。但在极度严苛的长长链数理推导和抗事实幻觉(AA-Omniscience 得分为 8.4)方面,它与 Opus 5.5 (46.4) 等闭源顶级旗舰依然存在客观差距。因此最佳实践是:用 MiMo 担当主力 Tier 2,同时保留 Opus 5.5 作为 Tier 3 兜底军师。
Q3:长文本场景下(例如分析几百页 PDF),应该优先看模型的什么指标?
A:切忌只看上下文窗口标称的‘1M’或‘2M’数字!在 AA 指数中,必须重点参考 AA-LCR v1.1 (Long-Context Reasoning) 与 GDP.pdf 评分。很多模型虽然支持把几十万字喂进去,但一旦需要跨越 30 页比对两组相互矛盾的数据时就会产生‘上下文失忆’。在长文本深层推理上,Claude 5.5 家族的综合达标率依然是目前工业界最值得信赖的。
九、结语与工程资源下载
大模型的真正价值,永远不在于厂商发布会上精心挑选的 PPT 跑分,而在于它能否以‘可控的成本、敏捷的时延与可信的质量’切实帮人类解决生产生活中的真实难题。2026 年 10 月的 AA 智能指数 v4.3.2 让我们看清了梯队断层的真相,也为我们指明了分层落地的科学路径。
不要在可以踩单车的时候开 F1 赛车,也不要在风暴来临的深海里驾驶独木舟。用科学的基准指导工程选型,用优雅的分流中枢驾驭百模争鸣!
📦 工业级套件与配置文件下载
本文配套的原生跨平台评测与三层模型动态路由网关完整脚本已打包就绪:
- macOS 26 原生 Zsh 套件:aa_model_router_toolkit_macos26.zsh
- Ubuntu 26.04 原生 Bash 套件:aa_model_router_toolkit_ubuntu2604.sh
- Windows 11 原生 PowerShell 7 套件:aa_model_router_toolkit_windows11.ps1
- 全平台打包归档:aa-router-toolkit.zip
- SHA256 安全校验清单:SHA256SUMS.txt