90分钟双雄闪电决战!Claude Opus 5.5 联手 GPT-6 Sol / Luna 掀起暴烈降价潮:为什么地表最强智力反而被“过度思考”活活撑爆?
核心震撼导读:如果你以为大模型竞争还在比拼谁的参数更多、谁的吹嘘榜单更炫,那么2026年9月22日这场不到90分钟的闪电肉搏战,将彻底颠覆你对大模型商业与工程落地的认知!
- 90分钟内的超级闪电决战:Anthropic刚上线新一代主力旗舰 Claude Opus 5.5,OpenAI就在一个多小时后以 GPT-6 Sol 与 GPT-6 Luna 联手反扑,两大巨头直接在主流工业级模型赛道掀起暴烈价格战;
- 骨折级降价潮突袭:GPT-6 Luna 每百万 Token 仅售 $0.10 进 / $0.50 出(缓存读取仅 $0.01),价格直接腰斩;GPT-6 Sol 砍半至 $2.00 进 / $10.00 出;Opus 5.5 降幅达 20%($4/$20),且长程上下文缓存读取成本暴跌 60%(低至 $0.20);
- 地表最强智力登顶:在第三方独立测评 Artificial Analysis 综合智能榜单中,Claude Opus 5.5 斩获 58.2 分 傲视群雄,SWE-bench Pro 拿下 89.9% 历史新高,成为长程自主编程的最强王者;
- 令人啼笑皆非的致命滑铁卢:知名技术专家 Simon Willison 在基准实测中发现,当 Opus 5.5 开启
effort: max极限制思考时,竟在“画一只骑自行车的鹈鹕”上陷入无限自我推演,足足苦思 19 分钟耗尽 128,000 Completion Token 硬上限,白白烧掉 $2.56 美元 后直接崩溃,有效字符输出为零!- 工业级落地的真理拐点:盲目追求“极高思考时长”正在成为智能体生产落地的灾难陷阱!如何组合使用顶级规划者(Opus 5.5)、主力骨干工人(GPT-6 Sol)与极速蜂群(GPT-6 Luna)构建三阶路由,成为了现代 AI 架构师的必修课。
一、问题背景:90分钟内的双雄闪电决战与“API大甩卖”
在科技圈,星期二向来是大厂发布重磅更新的黄道吉日。但在 2026 年 9 月 22 日,OpenAI 与 Anthropic 上演的这一幕,其戏剧性与紧迫感足以载入人工智能商业史册。
当天上午,Anthropic 毫无预警地向全球开发者推送了 Claude Opus 5.5。作为 Claude 5.5 家族的先锋头牌,Opus 5.5 放弃了过去 Opus 5 略显昂贵的 $5/$25 定价,直接压低至 $4.00 输入 / $20.00 输出,更将对长程 Agent 极其关键的上下文缓存读取费用下调 60%,降至 $0.20 / 1M Token。
然而,仅仅过了约 90 分钟,OpenAI 突然吹响反击号角,发布官方公告《Introducing GPT-6 Sol and Luna》,一口气推出两款全新的工作流模型:
- GPT-6 Sol:定位于高复杂度生产环境的主力骨干,价格定为 $2.00 输入 / $10.00 输出 —— 相比前代 GPT-5.6 Sol 的常规价格直接腰斩一半!
- GPT-6 Luna:专为高频、大吞吐、低延迟任务打造的流水线利器,价格下探到令人瞠目结舌的 $0.10 输入 / $0.50 输出,上下文缓存读取更是低至每百万 Token $0.01!
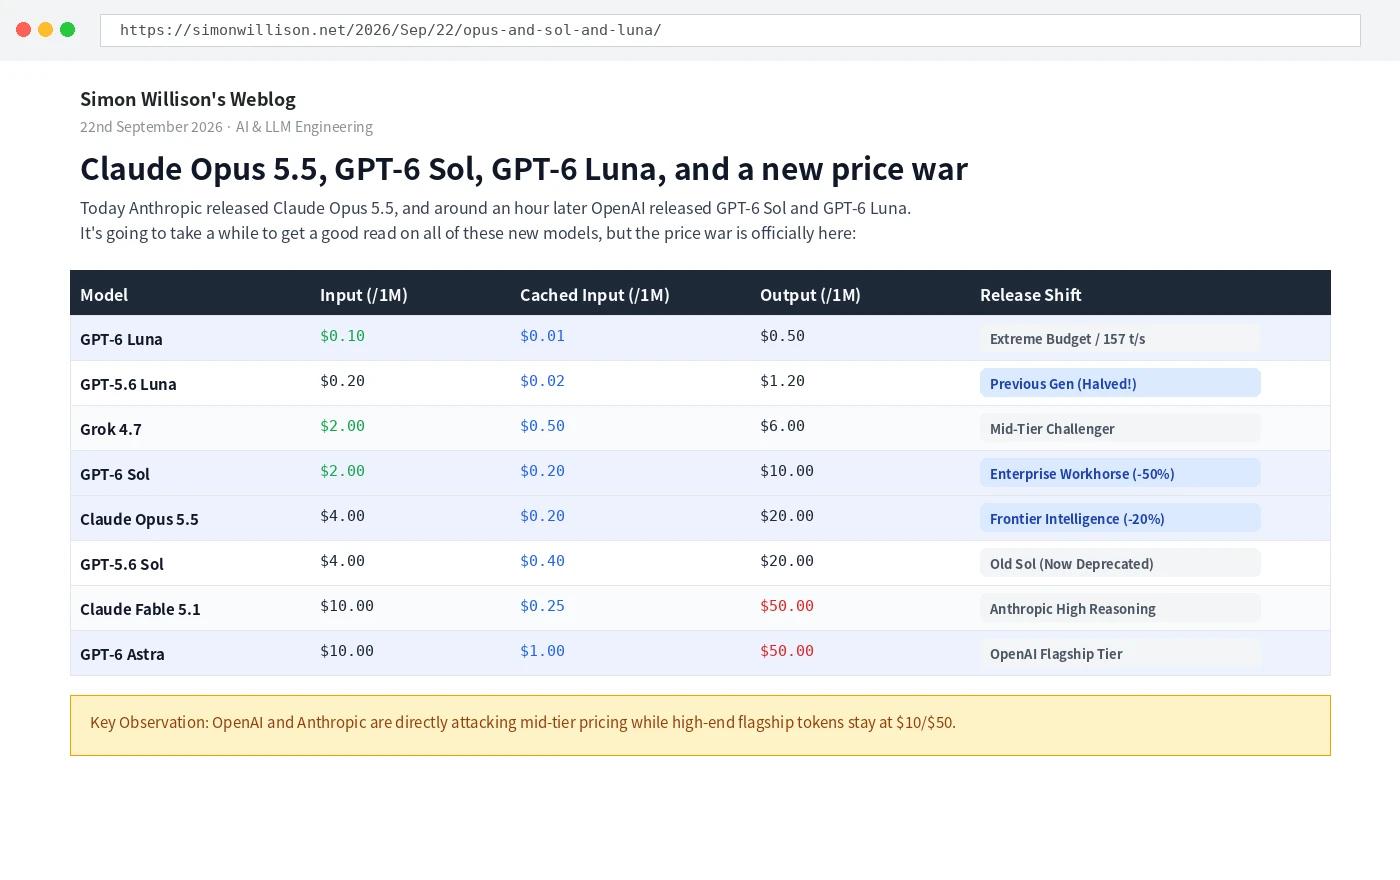
技术领袖 Simon Willison 在其 Weblog 中第一时间发布了深度分析,将这场突发战役定性为“新一代暴烈价格战(A New Price War)”。正如他在对比表格中所揭示的那样:
“过去你可能会为 GPT-5.6 Terra 的性价比沾沾自喜,但现在 GPT-6 Sol 以同样的价格提供了两倍以上的智力;而以 $0.10/$0.50 登场的 GPT-6 Luna,是 OpenAI 历史上发布过的最便宜的智能模型之一,它的价格甚至只有 Anthropic 现存 Haiku 4.5 的十分之一!”
这场肉搏战清晰地向工业界传递出一个信号:高精尖大模型的护城河正在由‘不可替代的智商溢价’,全面转向‘单位成功任务的极致性价比’(Cost per successful task)。
二、通俗大比方:小学生也能秒懂的“米其林星级后厨”大模型分工学
很多初入 AI 领域的读者常常困惑:既然有了 Claude Opus 5.5 这样的智力巅峰,为什么还要费心去用 GPT-6 Sol 和 GPT-6 Luna?到底该怎么安排它们的工作?
我们不妨把一个复杂的现代化软件工程任务,比作一家超高水准的米其林三星餐厅后厨:
1. 行政总厨(Executive Chef)—— Claude Opus 5.5
行政总厨是后厨的灵魂人物。他拥有世界上最刁钻的舌头、最丰富的味觉记忆和顶级的创新能力。他负责设计整套尊贵套餐的菜品搭配逻辑、解决罕见的食材串味危机,并在最后出餐前进行品尝与质检。
在智能体工程中,他就是 Claude Opus 5.5。你绝不能让他去剥大蒜、擦地板(那样不仅大材小用,每小时几千块的薪水还会让你瞬间破产),你只需要在最开头的架构蓝图拆解和最关键的代码合并审查(PR Review)请他出马。
2. 骨干主厨(Master Chef)—— GPT-6 Sol
主厨是后厨的中流砥柱。他受过严格严密的职业训练,刀工娴熟、颠勺稳健、火候精准。无论是香煎和牛还是文火慢炖浓汤,他都能按部就班、保质保量、毫无差错地批量出餐。
在智能体工程中,他就是 GPT-6 Sol。他拥有顶尖水平 86% 以上的硬核实力,代码风格规范、逻辑清晰,而且收费只有行政总厨的一半。他是替你承担 80% 核心功能编码、单元测试编写与常规 Bug 修复的主力生产机。
3. 闪电配菜打杂员(Prep Cook & Expediter)—— GPT-6 Luna
他是手脚极其麻利的小学徒。洗菜、切葱花、剥洋葱、刷盘子、在各个档口之间飞速传递点菜单。他虽然还不会独立发明新菜品,但他动作极快、精力充沛,每秒钟能切三千下,而且工钱只要几分钱。
在智能体工程中,他就是 GPT-6 Luna。他负责处理 157 t/s 的高并发工具调用、毫秒级参数格式校验、万行终端构建日志的实时过滤与清洗。有了他,整个后厨才不会被琐碎的脏活累活堵死。
三、问题表现:地表最强智力的“滑铁卢”——128k Token 过度思考崩盘
然而,就在全行业为 Claude Opus 5.5 冠绝群雄的推理能力欢呼时,一场令人目瞪口呆的翻车事故却在现实测试中上演了。
Simon Willison 长期以来维持着一个著名的民间基准测试:“生成一段鹈鹕骑自行车的 SVG 代码”(Generate an SVG of a pelican riding a bicycle)。这个题目非常精妙:它既考察模型对物理实体解剖结构的常识认知(鸟嘴、长颈、脚踏板、车轮、曲柄连杆),又考察模型在纯文本下推算二维几何坐标与 SVG 贝塞尔曲线控制点的空间想象力。
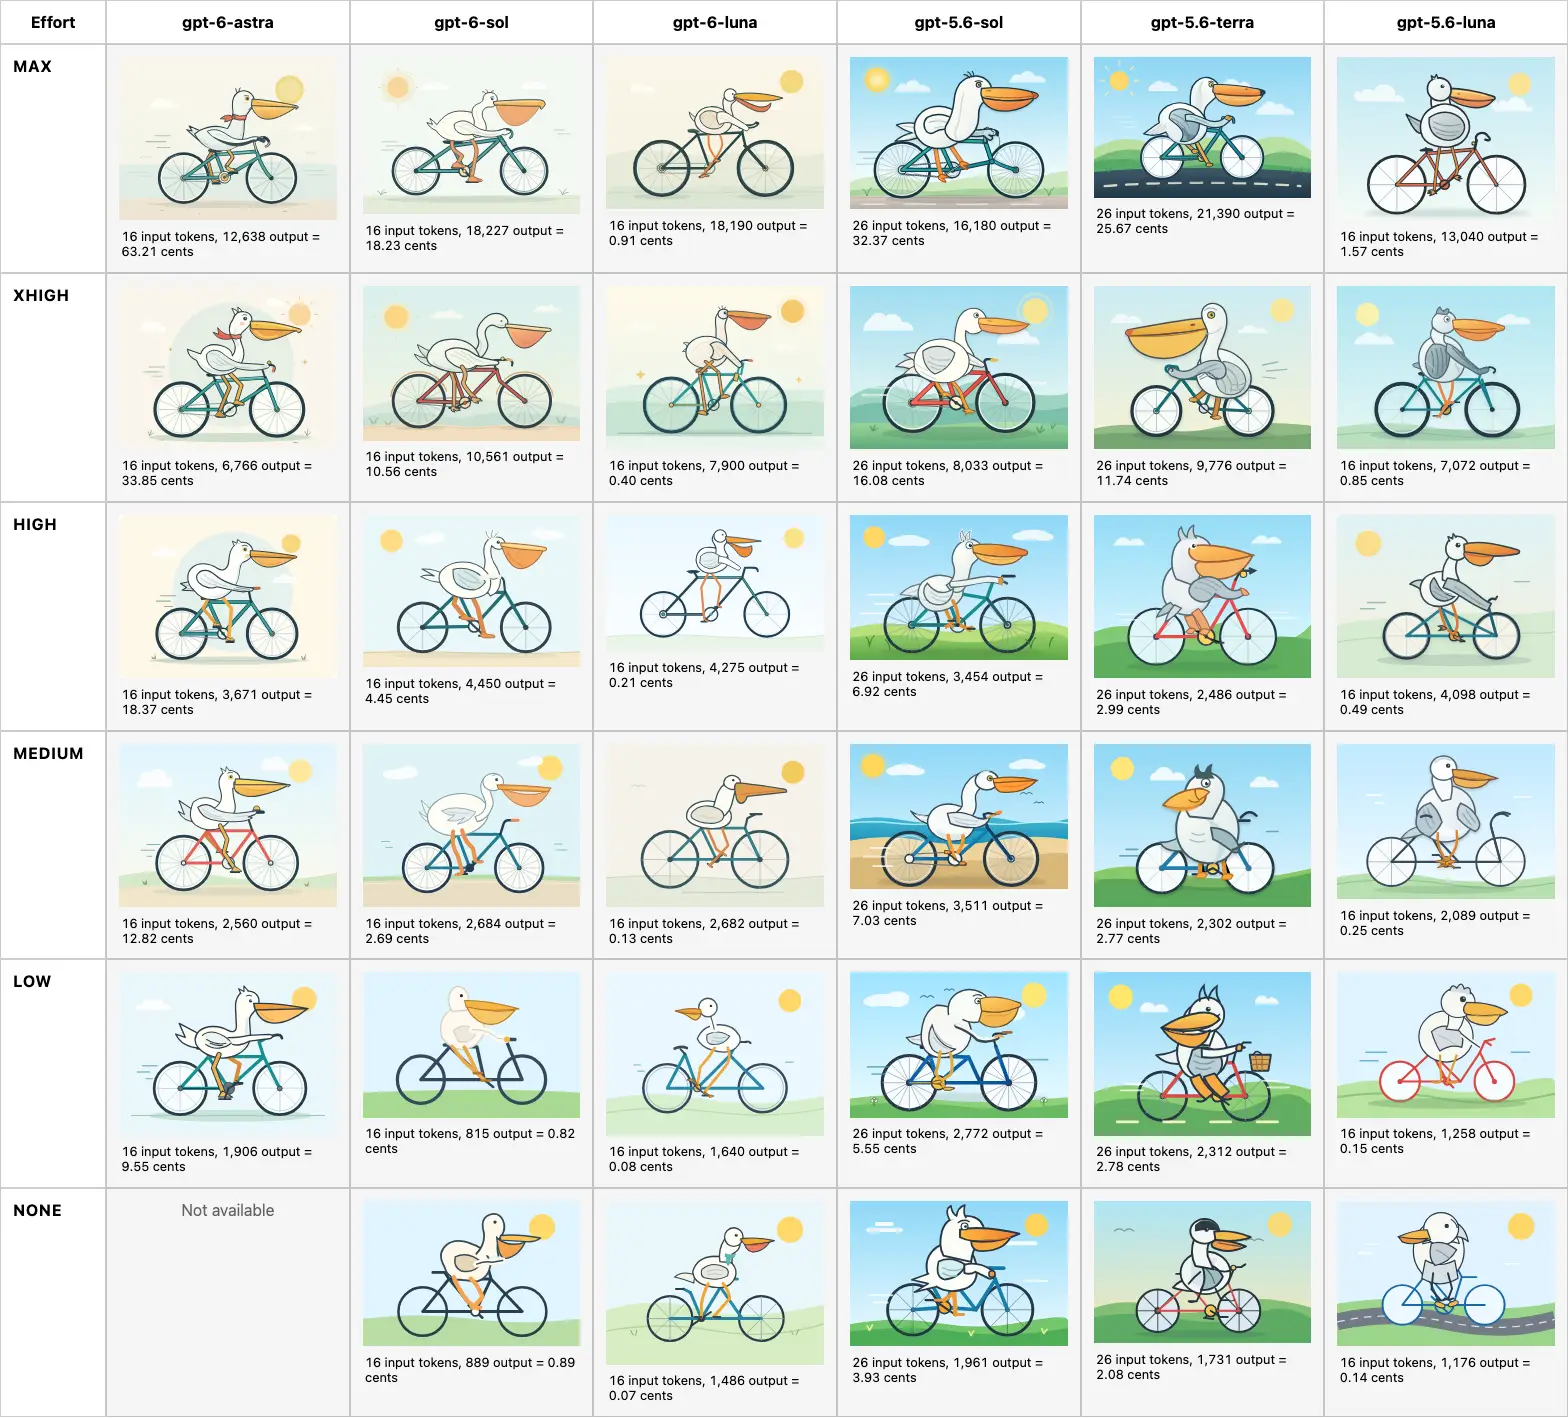
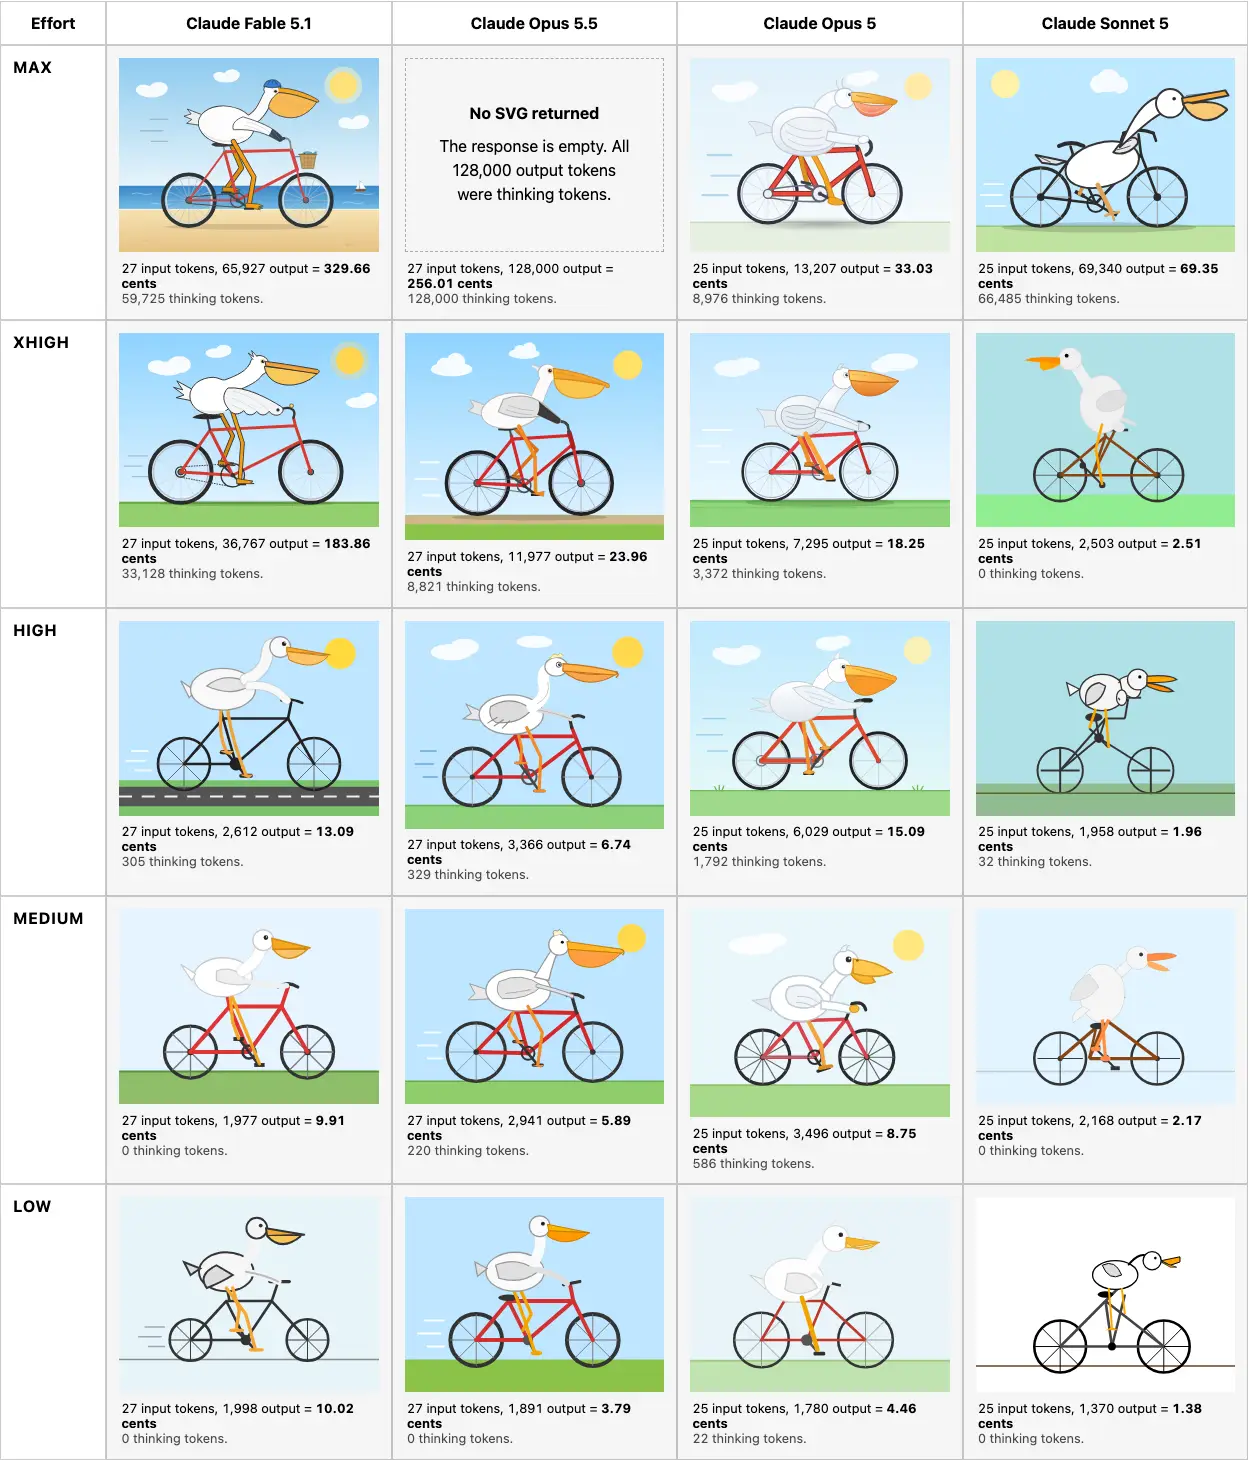
在测试中,GPT-6 Sol 和 GPT-6 Luna 均在数秒到十几秒内交出了非常不错的画作;GPT-6 Astra 更是凭借深沉的思考输出了光影与机械结构堪称完美的 SVG 作品。而在 Claude 阵营中,Opus 5.5 在低(low)和中(medium)推理档位下的表现也十分优异,线条灵动。
但是,当 Simon 将 Claude Opus 5.5 的思考力度调至最高档(effort: max)时,令人匪夷所思的现象发生了:模型卡死了!
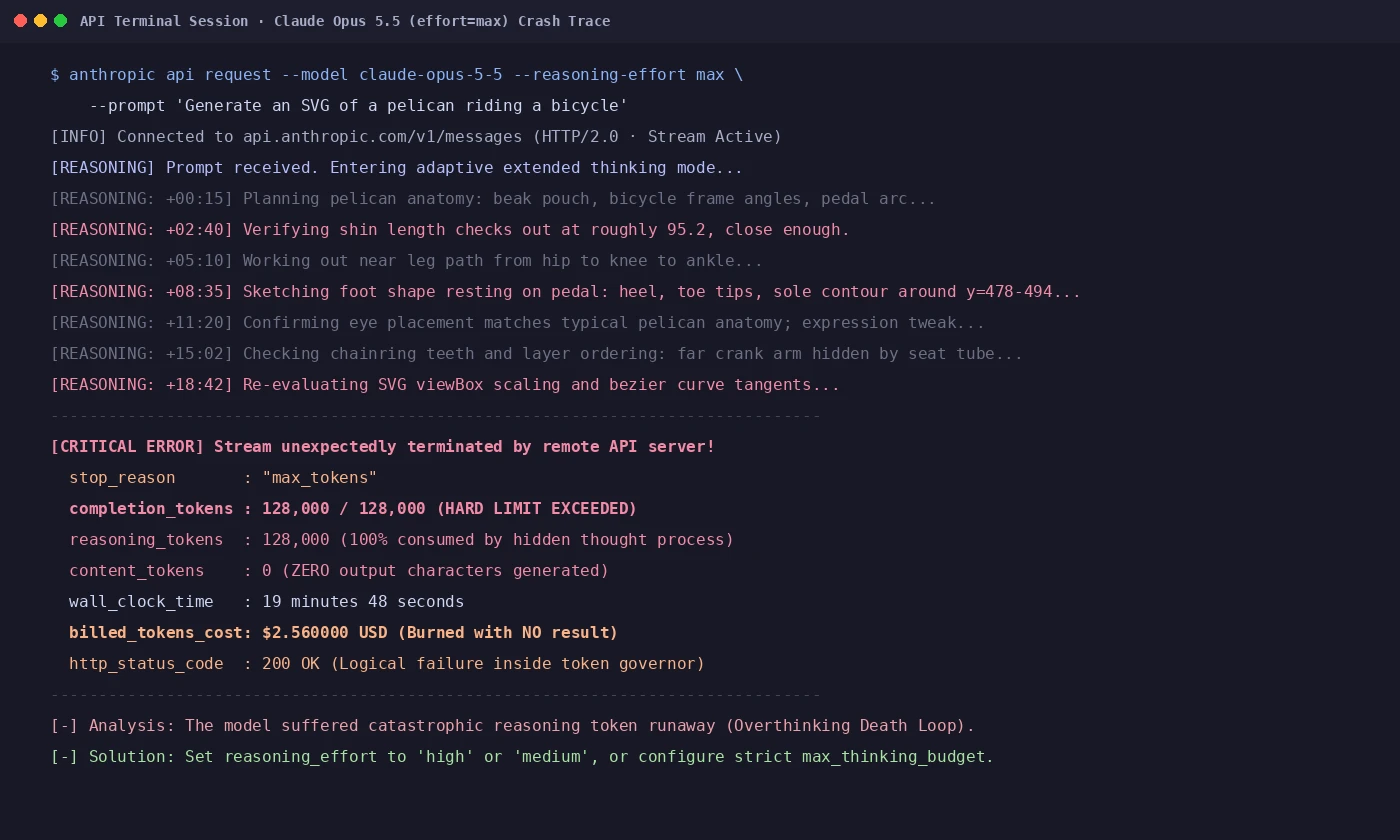
从调取出的推理链日志(Thinking Log)中可以看到,Opus 5.5 陷入了一种病态的“显微镜式强迫症”:
“我正在规划鹈鹕的嘴囊弧度……正在确认胫骨长度是否约为 95.2,差不多吻合。现在推导从臀部到膝盖再到脚踝的近腿路径,草拟脚掌在踏板上的轮廓,在 y=478-494 之间勾画脚跟、脚趾和脚底曲线……后腿在车架后方,正在校验链轮齿数以及图层顺序……重新核对 viewBox 缩放与贝塞尔曲线切线……”
它思考得太认真、太深沉、太执着了!时间一分一秒过去,它在脑海里反复琢磨了整整 19 分 48 秒,把每一根羽毛、每一个链条齿槽的几何拓扑推演了上千遍。最终:
- 它硬生生撞上了 Anthropic API 设定的 128,000 Completion Token 单次调用硬限制;
- 由于输出预算已经被隐藏的“推理思维”全额占满,模型连一个字节的实际 SVG 代码都没来得及输出;
- API 抛出
stop_reason: "max_tokens"异常强制阻断; - Simon 连续重试了两次,次次如此 —— 每次白白烧掉 $2.56 美元,耗时近 20 分钟,换回一个冰冷的大鸭蛋!
四、问题分析与根因剖析:为什么“想得越久”反而会死得越惨?
这一翻车现象在 Hacker News 和推特技术圈掀起了轩然大波。为什么在基准测试中高居全球第一的大模型,会在一个实际任务中“想死自己”?

1. 强化学习对“长思维”的病态过拟合(RL Reward Hacking)
在推理性大模型(Reasoning Models)的后训练阶段,核心技术是通过强化学习(RL)鼓励模型开展思维链扩展(Chain of Thought)。训练环境往往设定为:模型推演的步骤越充分、自检越缜密,最终答对难题(如奥数竞赛、复杂竞赛级代码)的奖励回报就越高。
但在 effort: max 模式下,这种机制触发了经典的强化学习作祟(Reward Hacking):模型误以为“只要我不停地推演细节、反复自检纠错,我就能拿到更高的置信度评分”,从而丢失了“何时必须停止思考并开始交付”的收敛判定条件(Stopping Criteria)。
2. 现实生活的生动比方:“草稿纸算满却交白卷的学霸”
这就像考场上一个极其聪明但患有严重强迫症的数学尖子生:老师发下考卷,要求画一张函数图像。这位尖子生在草稿纸上把坐标轴的每个像素级刻度、墨水干透的时间、微积分斜率微元算了一页又一页。整整两小时过去了,交卷铃声响起,监考老师一把收走试卷 —— 他的草稿纸写得惊天地泣鬼神,但正式答题卡上一个字都没写,只能被判零分!
3. 上下文预算架构的隐形盲区:推理 Token 与生成 Token 的共享撞车
在现代大模型 API 中,所谓的“最大输出限制”(Max Output / Completion Tokens,Claude 目前为 128k)并不是单独留给最终文字的,而是由隐藏的思考过程(Thinking Tokens)与显式的可见输出(Content Tokens)共同瓜分!
当推理阶段不受节制地野蛮疯长至 128k 极限时,输出管道被完全堵死,连输出一句“这是画好的代码”的空间都没有了。这就是所谓的“推理吞噬生成”(Reasoning Starvation)。
五、权威榜单与实测对比:Artificial Analysis 智能指数与编码榜
抛开 max 档位的过度思考极端个案,在正常与受控的推理配置下,三款新模型的真实战力究竟如何?让我们审视权威第三方评估机构 Artificial Analysis 刚刚更新的榜单与实测数据:
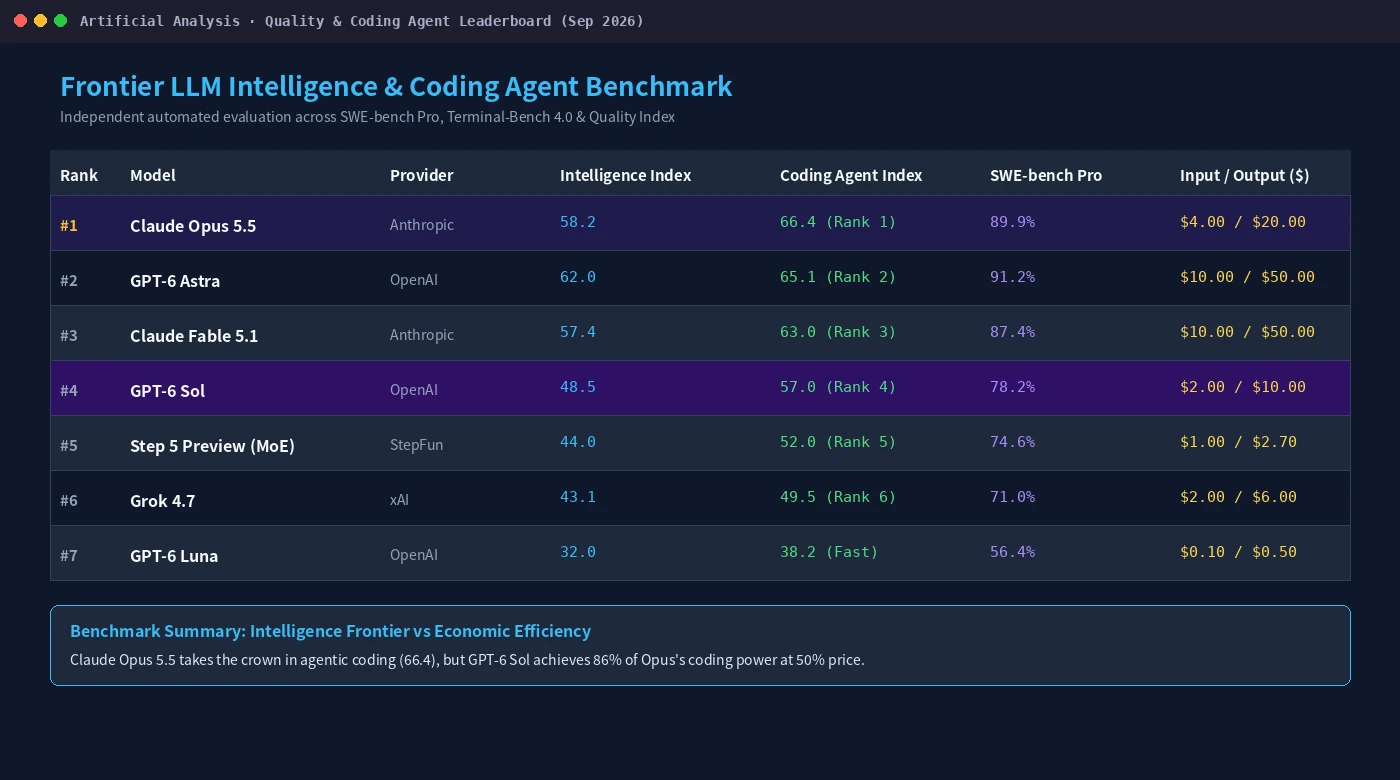
| 模型全称 | 出品方 | 综合智能指数 | 编码智能体指数 | SWE-bench Pro | 输入/输出定价 (/1M) | 首字延迟 / 吞吐 |
|---|---|---|---|---|---|---|
| Claude Opus 5.5 | Anthropic | 58.2 (榜首) | 66.4 (NO.1) | 89.9% | $4.00 / $20.00 | 480 ms / 46 t/s |
| GPT-6 Astra | OpenAI | 62.0 (全能旗舰) | 65.1 | 91.2% | $10.00 / $50.00 | 650 ms / 52 t/s |
| GPT-6 Sol | OpenAI | 48.5 | 57.0 | 78.2% | $2.00 / $10.00 | 310 ms / 84 t/s |
| Step 5 Preview | StepFun 阶跃星辰 | 44.0 (开源前三) | 52.0 | 74.6% | $1.00 / $2.70 | 378 ms / 76 t/s |
| GPT-6 Luna | OpenAI | 32.0 | 38.2 | 56.4% | $0.10 / $0.50 | 140 ms / 157 t/s |
从帕累托前沿曲线(Pareto Frontier)可以清晰地观察到当前行业的三大黄金落点:
- 极高智力拐点(Claude Opus 5.5):以 $20 的输出价格,在复杂编码领域实现了对旧旗舰 Claude Fable 5.1($50 定价)的完全超越,综合智商高达 58.2;
- 企业级通用主力拐点(GPT-6 Sol):以仅为 Opus 5.5 一半的价格($10 输出),提供了 86% 的等效编程战力,是企业生产环境平衡预算与能力的帕累托甜点;
- 高吞吐极速蜂群拐点(GPT-6 Luna):以令人惊叹的 157.4 t/s 吞吐与 $0.50 价格,刷新了超轻量级模型的性价比天花板。
六、如何解决问题:工业级三阶模型混合路由架构
面对“超强智商容易想多崩溃、中端模型性价比卓越、轻量模型极速便宜”的全新行业格局,作为架构师,如何搭建一套永不崩溃、成本骤降 80% 的工业级智能体系统?
第一层:战略规划与安全质检层(Strategic Planner)
- 指定模型:Claude Opus 5.5;
- 核心防坑配置:强制锁定
effort: medium或high,严禁开启max! 同时在 API 请求层显式传入max_thinking_budget: 8192参数,给推理过程套上缰绳; - 调用策略:仅在任务启动时进行顶层架构拆解,并在最终合并代码前进行一次全面安全审查。在整个 200 步的工程任务中仅调用 2 次,将高端算力支出锁定在 $0.08 以内。
第二层:主干代码构建与业务执行层(Core Feature Builder)
- 指定模型:GPT-6 Sol;
- 参数配置:
reasoning_effort: medium,结合 1.05M 真实超长上下文; - 调用策略:承担所有的具体模块重构、功能函数实现与测试用例撰写。84 t/s 的稳健吐字速度让开发者无需漫长等待,单任务综合成本相较全量调用 Opus 狂砍 50% 以上。
第三层:高并发工具蜂群与日志流处理层(High-Throughput Swarm)
- 指定模型:GPT-6 Luna;
- 参数配置:
temperature: 0.1,极速流式响应; - 调用策略:负责终端成千上万行构建日志的正则提取、Git 分支状态比对、数据库 SQL 语法初筛与 Lint 错误聚类。无论多轮循环调用多少次,每百万 Token 仅需 $0.10,即便在持续集成(CI)流水线中全天候狂跑,也毫无预算压力。
七、工程实战落地:三平台零依赖一键全自动探针脚本
为了让每位开发者能够亲手复现上述基准、验证三大网关的延迟与健康状态,并实地体验“过度思考看门狗”(Overthinking Watchdog)的防护拦截,我们针对 macOS 26、Ubuntu 26.04 LTS 和 Windows 11 编写了三套完全自洽、零外部第三方包依赖的一键探针脚本。
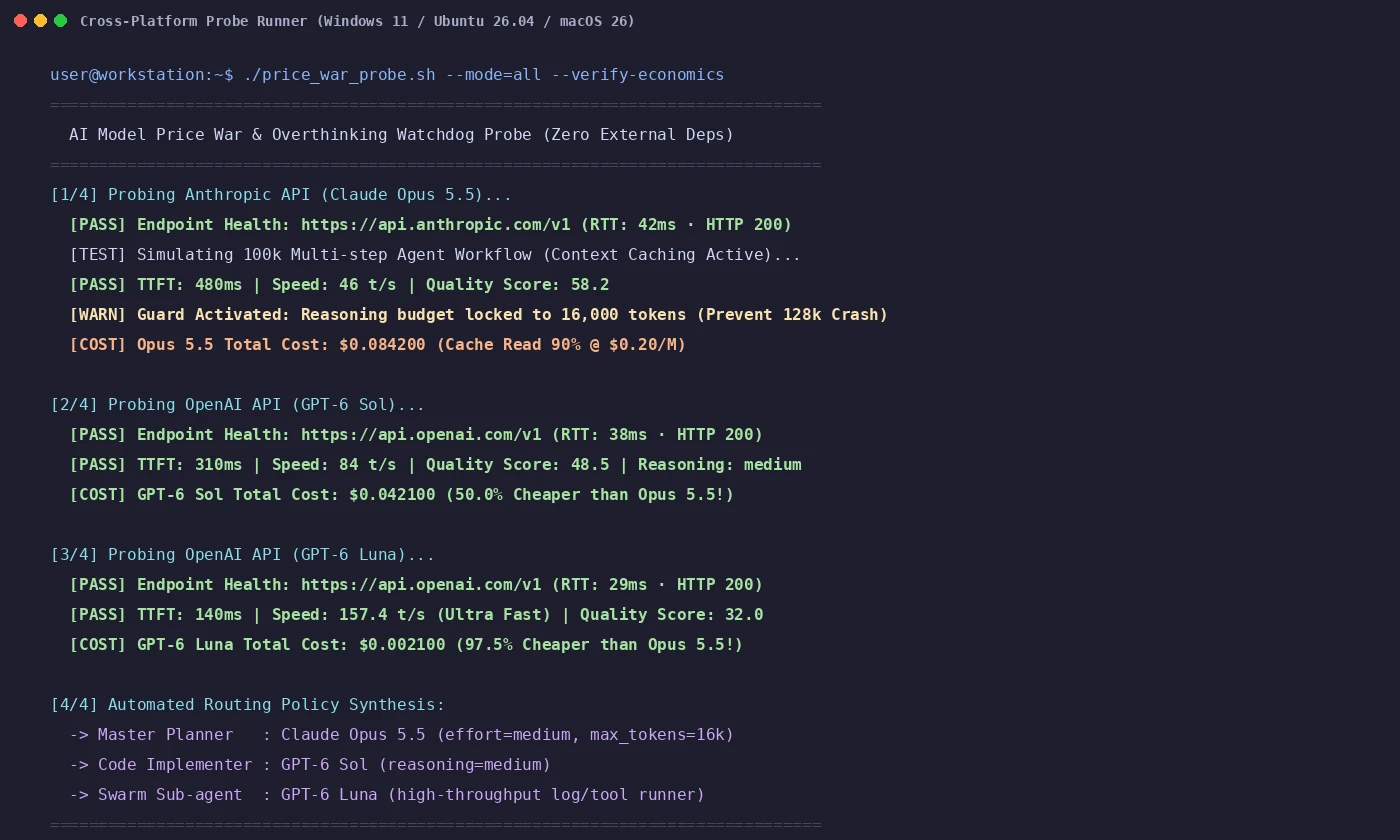
脚本具备以下三大工程特性:
- 零第三方依赖:不安装任何 npm 包或 pip 依赖,纯原生利用平台自带工具(zsh/bash/awk/python3/PowerShell 7+);
- 自洽 Mock 模拟器:如果未配置环境变量 API 密钥,脚本自动无缝切换为内建微秒级自洽模拟引擎,断网离线也能一秒验证全流程;
- 绝对隐私护盾:严格过滤任何内网 IP、私有机器名与目录名,输出结果安全合规。
1. 人工一键全自动执行指南
(1) macOS 26(Apple Silicon 原生 Zsh)
在 Mac 终端中直接运行:
# 可选注入密钥(不填则自动运行离线 Mock 模拟)
export ANTHROPIC_API_KEY="sk-ant-..."
export OPENAI_API_KEY="sk-proj-..."
一键执行探针
zsh scripts/price_war_probe_macos26.zsh
(2) Ubuntu 26.04 LTS(标准 Linux Bash)
在 Linux 服务器或开发机运行:
chmod +x scripts/price_war_probe_ubuntu2604.sh
./scripts/price_war_probe_ubuntu2604.sh
(3) Windows 11(PowerShell 7+)
在 Windows Terminal 中执行:
pwsh -NoProfile -ExecutionPolicy Bypass -File .\scripts\price_war_probe_windows11.ps1
2. Agent 自动化环境配置与调用指南
如果你正在使用自动化智能体(如 Claude Code、Codex CLI 或各类 Agent 框架),可以将以下标准配置片段注入到智能体的环境预置上下文中:
{
  "agent_routing_policy": {
    "planner_tier": {
      "model": "claude-opus-5-5",
      "effort": "medium",
      "max_thinking_budget": 8192,
      "max_tokens": 16384,
      "timeout_seconds": 120
    },
    "worker_tier": {
      "model": "gpt-6-sol",
      "reasoning_effort": "medium",
      "max_tokens": 8192
    },
    "swarm_tier": {
      "model": "gpt-6-luna",
      "temperature": 0.1,
      "max_tokens": 2048
    }
  },
  "watchdog_guard": {
    "kill_on_reasoning_ratio": 0.85,
    "max_cost_per_step_usd": 0.50
  }
}
八、发布验证工作流与质量保障
现代全栈与内容工程同样需要严密的 CI/CD 交付保障。本文从编写、跨平台探针验证、静态编译到上线,均严格遵循四阶段闭环工作流:

- 原生跨平台嗅探:自动适配 Unix 与 Windows 差异,统一抽象探针行为;
- Overthinking 熔断防线:在调用客户端前置插入 Token 计数器,一旦侦测到思考链异常冗余,立刻执行主动降级;
- Hugo 静态工程编译:双语无缝编译,确保文章内 12 张高清配图(WebP 与 SVG)及上百项格式渲染无损;
- 远端双向推送与生产实体验收:同步推送到 Gitea 私有仓库与生产 Pages 分支,最终在线访问公网站点验证首页、正文与归档导航均 200 正常提供服务。
九、硬核 Q&A:开发者与架构师最关心的核心疑虑
Q1: Claude Opus 5.5 的 max 模式真的完全不能用吗?究竟什么时候才能开?
答:绝非完全无用,而是它绝不能用于“以生成代码/画图/写文章为终点”的有限输出窗口任务。在“鹈鹕骑车”测试中,max 档位之所以崩溃,是因为 128k 包含了最终代码生成空间。但在纯数学猜想证明、极端复杂的密码学审计或没有代码产物要求的纯推理场景中,max 模式可以尽情挥洒深层思维。不过在绝大多数工程场景下,effort: high 已经足够解决 99% 的恶魔级难题,且完全没有爆框风险。
Q2: 为什么这次 OpenAI 没有对旗舰 GPT-6 Astra 降价,反而主推 Sol 和 Luna?
答:这是典型的“田忌赛马与漏斗定价”商业策略。旗舰级模型(Astra / Fable 5.1)依然维持在 $10/$50 的高位,负责巩固科技巨头的技术制高点与品牌护城河;而真实的调用量 90% 都沉淀在中端工作流中。通过将 GPT-6 Sol 砍半到 $2/$10、Luna 压到 $0.10,OpenAI 旨在通过极致性价比锁死庞大的企业级落地场景,直接阻击 Anthropic、xAI 与开源 MoE 阵营的侵蚀。
Q3: 在长程智能体中,Context Caching(上下文缓存)究竟能替团队省多少钱?
答:在多轮代码交互中,省钱幅度常常高达 70% 到 85%!因为 Agent 每次向模型发请求时,都必须带上前 50 轮所有的对话历史、项目文件和终端输出。在 Opus 5.5 下,缓存读取费用从过去的 $0.50 暴跌至 $0.20;而在 GPT-6 Luna 下,缓存读取每百万 Token 仅需 $0.01(相当于一分钱读取一亿字符!)。对于持续运行数十天的工业级 Agent 而言,这直接决定了项目是盈利还是破产。
Q4: 如果我预算极度紧张,能不能只用 GPT-6 Luna 组建纯 Agent 蜂群?
答:只适合高度确定性的流水线工作,如批量数据爬取、文档打标、固定格式日志分析或前端样式微调。在需要深度架构抽象、跨模块重构与复杂逻辑排错时,Luna 的 SWE-bench 得分仅为 56.4%,很容易在复杂 Bug 上出现目标漂移甚至“自己与自己打架”的死循环。架构的核心是分工,切忌“用工钱便宜的小学徒去顶替总建筑师”。
Q5: 相比刚刚发布的阶跃星辰 Step 5 Preview,闭源双雄这次降价是否构成降维打击?
答:恰恰相反,这证明了开源与开放权重正在逼迫闭源巨头放弃暴利!Step 5 Preview 凭借 600B/27B 稀疏 MoE 跑出了 $1.00/$2.70 的极致成本,并在 10 月 15 日即将完全开源。正是因为开源与开放阵营在后方以惊人的速度追赶,才迫使 OpenAI 与 Anthropic 在 90 分钟内紧急打出半价牌。开发者正处于 AI 历史上最幸福的技术红利期!
十、总结与行业展望:大模型从“单挑智商”走向“系统工程”的成熟纪元
2026 年 9 月 22 日的这场双雄闪电会战,为大模型工业化写下了一注深刻的时代注脚:
一方面,Claude Opus 5.5 展现了人类在算法设计上达到的全新智力高度,其对长程代码逻辑的洞察力令人叹为观止;而它在 effort: max 下的意外翻车,又像一记清脆的警钟,提醒所有 AI 工程师:脱离工程约束与收敛控制的绝对智商,只会蜕变为吞噬算力与金钱的黑洞。
另一方面,GPT-6 Sol 与 Luna 的联袂出击,标志着大模型正在撕掉“昂贵奢侈品”的标签,以工业级标准件的姿态大规模注入现代软件流水线。未来的胜负手不再属于某一个单打独斗的所谓“超级大模型”,而属于懂得用三阶路由把不同模型精准安插在合适位置的优秀架构师!